2026.08.25
Claude CodeとAWS 公式ワークフローを用いたAI-DLCの実践
導入
こんにちは。グループ研究開発本部 次世代システム研究室のH.Oです。
生成 AI 、AIエージェントをコーディングに使うことはもはや当たり前になりましたが、それに伴って「開発プロセスそのもの」を AI 前提で設計し直す取り組みが求められています。その中でAWS(Amazon Web Services)が提唱する AI-DLC(AI-Driven Development Life Cycle)という考え方が注目を集めているため、調査・検証を行いました。
本記事では、スクラムを経験している開発者を対象に、AI-DLC とは何か、スクラムの考え方とどうつながるのかを整理します。その上で、AWS がオープンソースで公開しているワークフロー実装 awslabs/aidlc-workflows を、Anthropic のコーディングエージェント Claude Code 上で実際に動かし、小さな業務ツールを 1 本作るデモをお見せします。
結論ファースト
- AI-DLC は、計画・設計・実装の提案を AI が担い、人間は各工程の区切りに置かれた承認ゲート(人間が成果物を確認して進行を許可する関門)で判断する側に回る開発方法論です。スクラムの経験主義(透明性・検査・適応)はそのまま引き継がれ、イテレーションの単位が週(Sprint)から時間〜日(AI-DLC では Bolt と呼びます)に縮みます
- AWS はこの方法論のワークフロー実装 awslabs/aidlc-workflows をオープンソースで公開しています。実装には安定版の v1 系と開発中の v2 系があり、本記事では、依頼の内容に合わせて実行する工程を絞り込む仕組みを持つ v2 系を Claude Code 上で完走させ、業務ログ自動生成ツールを 1 本作りました。vibe codingでは暗黙のまま進む設計判断がすべて質問と承認の形で可視化され、AI レビュアーは実装前に 30 件を超える設計上の問題を検出しました。これらを修正しテストによる検証を経てツールの実装を完了できました。
- 所要時間を決めるのはコーディングにかかる時間ではなく、人間が承認ゲートで判断する時間(今回 12 回)となります。v2 の各仕組みはこの判断の手間を減らす方向に設計されており、さらに AI の報告をそのまま信用せず、テストの再実行や承認者が人間であることの検証まで機械側で行います。
アジェンダ
- 結論ファースト
- 実行環境
- 1. AI-DLC とは何か
- 2. スクラム から AI-DLC へどう接続するのか
- 3. AI-DLC workflows v2 を Claude Code で動かす
- 4. やってみてわかったこと
- まとめ
- 参考文献
- 最後に
実行環境
- OS: macOS 26.6.2
- Claude Code: 2.1.238
- aidlc-workflows: v2.3.0(tag、2026-07-09)
- bun: 1.3.12(JavaScript ランタイム。v2 の実行基盤に必要)
- Python: 3.12.3(デモで生成するツールの実行環境。テスト実行も標準の
python3 -m unittestで追加依存なし) - gh CLI(GitHub 公式の CLI(Command Line Interface)ツール): 2.86.0(生成するツールが GitHub の活動取得に使用)
1. AI-DLC とは何か
結論から言うと、AI-DLC は「AI をアシスタントではなく中心的な作業者として位置づけ、人間の役割を意思決定と検証に寄せる」ための方法論です。AWS の Raja SP 氏が 2025 年 7 月に AWS DevOps Blog の記事「AI-Driven Development Life Cycle: Reimagining Software Engineering」で提唱しました。
AI と人間の役割が入れ替わる
従来の AI 活用は「人間が計画し、AI が部分的に手を動かす」形でした。AI-DLC はこれを逆転させます。AI が要件の明確化質問を出し、計画を立案し、設計と実装を提案してきます。人間の仕事は、各段階の承認ゲートで判断を下すことです。
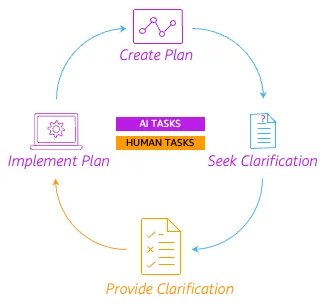
この「AI が提案し、人間が承認する」ループが、SDLC(Software Development Life Cycle、ソフトウェア開発ライフサイクル)のあらゆる活動で高速に繰り返されるというのが AI-DLC の基本メンタルモデルです。提唱ブログでは、このループが次の図で示されています。AI の仕事(計画の作成・明確化の要求・実装)と人間の仕事(明確化への回答)が色分けされています。
3 つのフェーズ
AI-DLC はライフサイクルを 3 つのフェーズで構成します。
- Inception: ビジネス意図を要件・ストーリーに変換する(何を・なぜ作るか)
- Construction: 検証済みのコンテキストをもとに設計・実装・テストを行う(どう作るか)
- Operations: デプロイと運用(IaC(Infrastructure as Code)、モニタリング)
3 つのフェーズの流れと各フェーズの活動は、提唱ブログの次の図で示されています。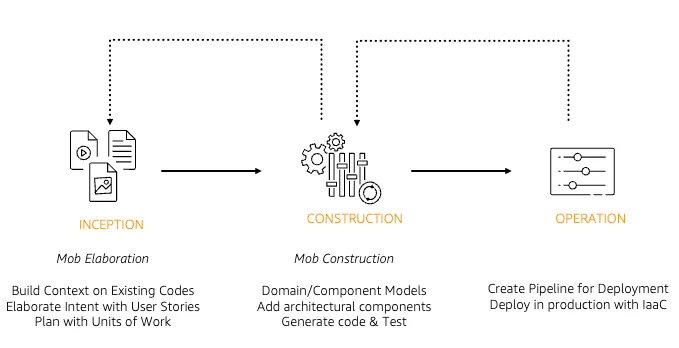
どのフェーズでも動きは同じです。「AI が提案 → 人間が承認」の小さいループが、フェーズ内で何度も回ります。
2. スクラム から AI-DLC へどう接続するのか
結論から言うと、AI-DLC は スクラム の否定ではなく、同じループをずっと短い周期で回すものです。スクラム の経験主義はそのまま引き継がれ、イテレーションの単位が週から時間・日に縮みます。
用語の対応
| スクラム | AI-DLC | 変わる点 |
|---|---|---|
| Sprint | Bolt | 週単位 → 時間・日単位 |
| Epic | Unit of Work | AI が分割を提案する |
| バックログリファインメント | Mob Elaboration | AI が質問を生成し、チームが全員で回答・検証する |
| 実装(分担 + レビュー) | Mob Construction | AI が設計・コードを提案し、チームがリアルタイムに検証する |
| レトロスペクティブ | learning loop(v2 実装) | 人間の修正・指摘が恒久的なルールとして蓄積される |
なお「Sprint → Bolt」「Epic → Unit of Work」は公式ブログにある言い換えで、リファインメントとレトロスペクティブの行は私が解釈し、対応付けました。また厳密には Epic は Scrum Guide の用語ではなく現場の慣行用語ですが、通りの良さを優先してこの表記にしています。
両者のループの対応は次のとおりです。
スクラム(週単位のループ・簡略化)          AI-DLC(時間〜日単位のループ)
──────────────────────          ──────────────────────
Epic                 ──対応──▶  Unit of Work(AI が分割を提案)
リファインメント        ──対応──▶  Mob Elaboration(AI が質問・チームが判断)
Sprint(1か月以内)     ──対応──▶  Bolt(数時間〜数日)
スプリントレビュー      ──対応──▶  承認ゲート(各ステージ末尾)
※ 両ループとも簡略化しています(スクラム 側のプランニングやレトロスペクティブは省略)。また AI-DLC の承認ゲートは Bolt の末尾に 1 つだけではなく、各ステージの末尾に置かれます。
経験主義は引き継がれる
スクラム の土台は経験主義の 3 本柱(透明性・検査・適応)です。AI-DLC ではこれらが次のように実装されます。
- 透明性: 決定と成果物、そして 70 種類のイベント(v2.3.0 同梱の監査ツール
aidlc-audit.tsに定義されている種別数)からなる監査ログがリポジトリに残ります。後述のデモで実物を確認できます - 検査: 各ステージ末尾の承認ゲート
- 適応: 承認ゲートでの差し戻し、実行中のワークフロー組み替え(recompose)、そして学んだことをルールとして残す learning loop が担います
「各ステージに承認ゲート」と聞くと、ウォーターフォールのフェーズゲートへの回帰を連想するかもしれません。違いは周期にあります。フェーズゲートが数週間〜数か月に 1 度の関門だったのに対し、AI-DLC のゲートは時間単位で通過するものです。検査のループが回る周期はむしろ スクラム より短く、「作ってから間違いに気づくまでの時間」は縮む方向に働きます。
なぜ周期を短くできるのか
周期を短くできる理由は 2 つあります。
1 つ目は認識合わせと文書化のコスト削減です。要件の明確化質問の生成・選択肢の整理・ドキュメント化を AI が担うため、リファインメント相当の Mob Elaboration は「人間が判断する時間」だけで回るようになります。
2 つ目は構築そのもののコスト削減です。設計・実装・テストの一次ドラフトを Mob Construction で AI が作るため、インクリメントの完成までの時間も縮みます。認識合わせだけ速くしても実装が従来速度のままなら周期は縮みません。
両方が揃って、初めて Sprint が Bolt になります。
3. AI-DLC workflows v2 を Claude Code で動かす
ここまでは考え方の話でした。ただ、方法論は文章を読んだだけでは実践できません。AI にどの順序で何をさせるか、承認ゲートをどこに置くか、成果物をどのファイルに残すか — 実際に回すには、これらを具体化した手順と道具立てが必要です。AWS はこれを AI コーディングエージェント上で動く形に落とし込み、2025 年 11 月にワークフロー実装 awslabs/aidlc-workflows としてオープンソースで公開しました。
公開時の記事で AWS は、AI を使った開発を型に落とすときの課題を 3 つ挙げています。
- 硬直的なワークフロー: すべてのプロジェクトに同じ手順を強制してしまう
- 深さの調整が効かない: 単純な変更に過剰な工程を課す、あるいは複雑な変更に必要な厳密さを欠く、という問題を抱えがちになる
- 過剰な自動化: 人間の検証と監督が形骸化する
aidlc-workflows が「adaptive(適応型)」を掲げているのは、この 3 課題への回答です。価値を生む工程だけを、依頼に応じた深さで実行します。そしてその最新形である v2 系は、もはや「ルール集」ではなく、Claude Code 上で動く本格的なワークフローエンジンになっています。ここからは実際にツールを 1 本作りながら、その動きを見ていきます。
v1 と v2 — 2 つの実装世代
awslabs/aidlc-workflows には現在 2 つの世代があります。
- v1 系(最新 v1.0.1、2026-06-30 リリース): ルールファイル方式です。
core-workflow.mdをプロジェクトのCLAUDE.mdに、詳細ルール群aws-aidlc-rule-details/を.aidlc-rule-details/にコピーし、AI コーディングエージェントの「指示書」として読ませます。3 フェーズ構成で、Claude Code のほか Kiro、Cursor、Copilot など 7 種類のツールに同じ方法で導入できます - v2 系(
v2ブランチ、最新タグ v2.3.0、2026-07-09): 複数の AI コーディングツールそれぞれに合わせて作り込まれた実装です。Claude Code 向けには、Claude Codeのskill・エージェント定義(ドメイン専門 11 + 支援 3 の計 14 ファイル)・フックと、bun で動くワークフロー進行管理プログラム(オーケストレーションエンジン)の組で提供され、/aidlcコマンドで起動します。ワークフローは 5 つのフェーズ(INITIALIZATION / IDEATION / INCEPTION / CONSTRUCTION / OPERATION)で構成され、その下に要件分析・設計・コード生成といった個々の工程が合計 32 個並びます。v2 ではこの工程を「ステージ」と呼びます
1 章で見た方法論のフェーズは 3 つでしたが、v2 のフェーズは 5 つに増えています。両者の対応を整理すると次のようになります(この対応付けは本記事による整理です)。方法論の Inception に当たる範囲が、意図の聞き取りからスコープ確定までを行う IDEATION と、要件・設計・実装計画を確定する INCEPTION の 2 つに分かれました。方向を決める前半と、作るものを詳細に固める後半とでは、承認ゲートで人間が判断する内容が異なるためと考えられます。CONSTRUCTION と OPERATION は、方法論の Construction / Operations にそのまま対応します。残る INITIALIZATION は方法論のライフサイクルには存在しないフェーズで、作業環境の検出や状態ファイルの初期化といった、ワークフローエンジンが動き出すための技術的な準備を担います。
この 5 フェーズの下に並ぶ 32 ステージの内訳は次のとおりです(v2.3.0(2026-07-09 リリース)に同梱されている定義ファイルに基づきます。ステージ名はファイル名のままで、丸括弧は本記事による補足です。v2 は開発途上のため、以降のリリースで構成が変わる可能性があります)。後述する scope は、この一覧から実行するステージを選ぶ仕組みです。
- INITIALIZATION(初期化)— 3 個
- workspace-detection(作業環境の検出)
- workspace-scaffold(作業環境の雛形作成)
- state-init(ワークフロー状態の初期化)
- IDEATION(構想)— 7 個
- intent-capture(意図の聞き取り)
- market-research(市場調査)
- feasibility(実現性評価)
- scope-definition(スコープ定義)
- team-formation(チーム編成)
- rough-mockups(ラフモックアップ)
- approval-handoff(構想フェーズの承認)
- INCEPTION(要件・設計)— 8 個
- reverse-engineering(既存コードの分析)
- requirements-analysis(要件分析)
- user-stories(ユーザーストーリー)
- practices-discovery(開発プラクティスの確認)
- refined-mockups(詳細モックアップ)
- application-design(アプリケーション設計)
- units-generation(Unit of Work への分割)
- delivery-planning(実装計画)
- CONSTRUCTION(構築)— 7 個
- functional-design(機能設計)
- nfr-requirements(非機能要件)
- nfr-design(非機能設計)
- infrastructure-design(インフラ設計)
- code-generation(コード生成)
- build-and-test(ビルドとテスト)
- ci-pipeline(CI パイプライン構築)
- OPERATION(運用)— 7 個
- environment-provisioning(環境構築)
- deployment-pipeline(デプロイパイプライン)
- deployment-execution(デプロイ実行)
- observability-setup(監視の設定)
- performance-validation(性能検証)
- incident-response(障害対応手順)
- feedback-optimization(運用フィードバック改善)
v2 の設計で面白いのは、「次に何をするか」の判断を LLM(Large Language Model、大規模言語モデル)に任せず、同じ状態からは必ず同じ判断を返すエンジンが握っている点です。エンジンが JSON形式の指示を 1 つずつ返し、LLM 側はその 1 手だけを実行して結果を報告します。ステージの順序・承認ゲートの状態・監査ログがエンジン側に固定されるため、LLM の振る舞い次第でワークフローの骨格が崩れる余地は大幅に減ります(ステージの中身を実行するのは依然 LLM であり、README も能力の低いモデルでは手順の省略が起こりうると注意しています)。
注意点として、v2 は執筆時点で GitHub Releases に掲載されていません(タグのみの配布)。v2 の README も「GA(General Availability)Preview — under active development」としてリリース間の破壊的変更がありうると明言し、本番用途には安定版の main ブランチ(v1 系)を推奨しています。
それでも本記事が v2 系を使うのは、本記事で見せたい仕組み — 実行するステージの絞り込み(scope・composer)、学んだことのルール化(learning loop)、イベント単位の監査ログ — がいずれも v2 の実装だからです。
「価値を生む工程だけを実行する」という考え方自体は v1 にもあり、v1 ではルール文書を読んだ LLM 自身が実行計画を判断します。v2 はこの判断を scope の設定とエンジンに移し、何を実行して何を省いたのかを後から検証できる形にしました。再現性を保つため、タグ v2.3.0 に固定して使います。
scope — 開発作業の種類に応じて実行するステージが決まる
v2 では「adaptive」が scope という仕組みで具体化されています。scope は、バグ修正・新機能・検証実験といった開発作業の種類ごとに、32 ステージのうちどれを実行(EXECUTE)しどれを省略(SKIP)するか、そして各ステージをどれだけ深く掘り下げるか(depth。Minimal / Standard / Comprehensive の 3 段階)をまとめて決める設定です。あらかじめ定義されたものが 9 種類同梱されており、stock scope と呼ばれます。
9 種類すべてを挙げます(実行ステージ数・depth・用途は、v2.3.0(2026-07-09 リリース)の定義によります)。
feature(新機能の開発): 32 ステージすべて・depth Standard。指定がないときの既定ですenterprise(統制の厳しい環境での開発): 32 ステージすべて・depth Comprehensive。監査証跡を最も厚く残しますworkshop(グループ演習): 25 ステージ・depth Standard。進行役付きの研修などで使う想定で、承認ゲートを飛ばせない設定になっていますmvp(Minimum Viable Product の構築): 22 ステージ・depth Standard。OPERATION フェーズを省き、コア機能を最短で形にしますinfra(インフラ変更): 13 ステージ・depth Standard。インフラ構成の変更に絞った工程ですsecurity-patch(脆弱性対応): 10 ステージ・depth Minimal。CVE(公開済み脆弱性)への対応を想定していますpoc(Proof of Concept、実現性の検証): 8 ステージ・depth Minimal。実現可能性の確認だけを高速に行いますrefactor(リファクタリング): 8 ステージ・depth Minimal。挙動を変えない既存コードの整理ですbugfix(バグ修正): 7 ステージ・depth Minimal。既存コードの分析と修正・テストだけを行います
どの stock scope にも合わない依頼に対しては、composer という仕組みが専用の EXECUTE/SKIP 構成をその場で仕立てます(後述のデモで実際にこれが発動します)。
セットアップ
導入はリポジトリの dist/claude/ 一式をプロジェクトにコピーするだけです。
git clone --branch v2.3.0 --depth 1 https://github.com/awslabs/aidlc-workflows.git
cp -R aidlc-workflows/dist/claude/.claude your-project/
cp -R aidlc-workflows/dist/claude/aidlc your-project/
dist/claude/ 直下をまるごとコピーすると、同梱の .gitignore が既存プロジェクトのものを上書きしてしまいます。README どおり 2 つのディレクトリを個別にコピーしてください。
1 点だけハマりどころがあります。同梱されている Claude Code の設定ファイル .claude/settings.json は、Amazon Bedrock(AWS の生成 AI サービス)経由で Claude を呼び出す前提の設定(CLAUDE_CODE_USE_BEDROCK=1 とモデル ID 群)を含むため、Claude サブスクリプションで使う場合は settings.local.json で上書きが必要です。
{
  "env": {
    "CLAUDE_CODE_USE_BEDROCK": "0"
  },
  "model": "claude-fable-5"
}
また、hooks とオーケストレーションエンジンの実行に bun が必要です(brew install oven-sh/bun/bun など)。
なお、同梱の .mcp.json(AWS 系 MCP(Model Context Protocol)サーバー群の接続設定)は今回のデモでは使わないため外しています。
検証 — 業務ログ自動生成ツールの実装
デモの題材は、自分の1日の業務記録を一覧化するツールとしました。私は以前 vibe coding で このようなツールを4 時間ほどで作っていました。同じ題材を AI-DLC で作り直すことで両者の実装作業・使用感を比べてみることを意図しました。
/aidlc に投入したビジネス意図文がこちらです。
日々の業務ログを自動生成するツールを作りたい。ローカルにある活動の痕跡 — GitHub のコミット・PR(gh CLI 経由)、ブラウザの閲覧履歴、Claude Code のセッション履歴 — を突き合わせて、その日何にどれくらい時間を使ったかを推定し、タスク単位の業務ログとしてファイルに出力する。確信度の高い項目と低い項目が区別できるようにして、人間が最終確認・修正してから工数管理システムに転記できる形にしたい。
あえて出力フォーマット・時間の丸め単位・重複の統合ルールなどを書いていません。この曖昧さを AI-DLC がどう扱うかが見どころです。
composer が依頼専用のワークフローを仕立てる
意図文を投入すると、エンジンはまず scope の判定を試みました。結果は「どの stock scope にも一致しない」。そして composer が起動し、この依頼専用の構成を提案してきました。
15 stages EXECUTE / 17 SKIP, 12 approval gates mode: custom / scopeName:
local-tool/ depth: Standard / workspace: Greenfield
depth は前節で述べた掘り下げの深さ、Greenfield は「既存コードのない新規開発」という自動判定の結果です。なお v2 では、この意図文から始まる一連の開発を intent と呼びます(次の表にもこの語が出てきます)。
SKIP 判定には全件に理由が付きます。抜粋します。
| Stage | 判定 | 理由 |
|---|---|---|
| market-research | SKIP | 個人用内部ツール。調査すべき市場・競合が存在しない |
| team-formation | SKIP | 開発者 1 名のソロツール。編成すべきチームがない |
| rough-mockups | SKIP | CLI + ファイル出力で GUI がない |
| feasibility | EXECUTE | ブラウザ履歴 DB のロック/形式、セッションログの形式、gh CLI 認証、プライバシー制約 — 本 intent 最大のリスク |
| nfr-requirements | EXECUTE | ブラウザ履歴という機微データを扱うためプライバシー要件の明文化は必須 |
| operation 全 7 stages | SKIP | デプロイ対象が存在しない。ツールはオンデマンドにローカル実行される |
「32 ステージ全部が実行されるのでは」という心配は杞憂でした。stock scope で足りない場合だけ composer が依頼に合わせて刈り込み、しかも承認するまでプロダクト側のファイルは一切書きません(ワークフロー自身の状態・監査ファイルは除きます)。まさに本章の冒頭で述べた「adaptive」な挙動です。
この提案を承認すると、custom scope local-tool が保存され、ワークフローが開始されました(v2 用語では intent の「birth」)。
Mob Elaboration — AI の質問攻めが始まる
ワークフローが始まると、AI は実装の話を一切せず、質問票を出してきました。最初のステージ Intent Capture(意図の聞き取り)では以下の7問が質問として提示されました。
Q1. このツールが解決する現在最も困っている問題は何ですか?
現状の「日々の業務ログ作成」で最も困っていることを教えてください。
- A. 毎日のログ作成に時間がかかりすぎる(記入作業そのものの手間)
- B. 記憶に頼るため内容が不正確・抜け漏れが多い(思い出せない)
- C. 工数管理システムへの転記が面倒で後回しになり、まとめて書くと精度が落ちる
- D. 何に時間を使ったか自分でも把握できておらず、振り返り・改善ができない
- E. 上記の複合(主となるものを補足してください)
- X. Other (please specify)
[Answer]: E — 主は C(転記の後回しで精度低下)、副として B(記憶頼みの抜け漏れ)
Mode: direct / 回答日時: 2026-08-21T07:53:24Z
Q2. 利用者は誰を想定していますか?
- A. 自分ひとりの個人ツール(他者への配布は考えない)
- B. まず自分用、うまくいけばチームメンバーにも配りたい
- C. 最初からチーム全員で使う前提
- D. 社内の他部署にも展開する可能性を視野に入れる
- X. Other (please specify)
[Answer]: A(自分ひとりの個人ツール。配布は考えない)
Mode: direct / 回答日時: 2026-08-21T07:53:24Z
Q3. 「成功」をどう測りますか?(あてはまるものをすべて選択)
- A. 日次ログ作成にかける時間が一定以下になる(例: 15分 → 3分)
- B. 生成されたログの修正箇所が少ない(人間の修正率が一定以下)
- C. 業務時間のカバレッジ(1日の実働のうちログで説明できる割合)が一定以上
- D. 毎営業日欠かさず工数管理システムに転記できている(習慣の定着)
- E. 振り返りで時間の使い方の傾向が見えるようになる
- X. Other (please specify)
[Answer]: A, B, D(日次ログ作成が数分で終わる / 人間の修正が少ない / 毎営業日転記が定着する)
Mode: direct / 回答日時: 2026-08-21T07:53:24Z
Q4. このツールを作ろうと思ったきっかけ(トリガー)は何ですか?
- A. 会社・組織で工数入力が義務化されている/厳格化された
- B. 自分の生産性・時間の使い方を改善したい個人的な動機
- C. 日報・週報などの報告義務があり、その作成を楽にしたい
- D. AI活用・自動化の実験として試したい(題材としての興味)
- X. Other (please specify)
[Answer]: A(組織で工数入力が求められている。日々の入力の手間を減らしたい)
Mode: direct / 回答日時: 2026-08-21T07:53:24Z
Q5. 転記先の工数管理システムとの関係はどこまで求めますか?
- A. ツールはファイル出力まで。転記は完全に手動でよい
- B. 転記しやすい形式(工数管理システムの項目・粒度に合わせた出力)までは欲しい<
- C. 将来的にはAPI等での自動転記も視野に入れたい(今回は手動でよい)
- D. 今回から自動転記まで含めたい
- X. Other (please specify)
[Answer]: C(将来的には API 自動転記も視野。今回はファイル出力までで転記は手動)
Mode: direct / 回答日時: 2026-08-21T07:53:24Z
Q6. 確信度の低い項目を、運用上どう扱いたいですか?
- A. 確信度の高低で表示を分け、低いものだけ人間が重点的に確認したい
- B. 低確信度の項目は「不明時間」としてまとめ、人間が埋める前提にしたい
- C. 低確信度でもツールの推定を仮置きし、人間は間違いだけ直したい
- D. まだ決めていない/使いながら決めたい
- X. Other (please specify)
[Answer]: A(確信度の高低で表示を分け、低いものだけ重点確認したい)
Mode: direct / 回答日時: 2026-08-21T07:53:24Z
Q7. データの取り扱いで守りたい境界はありますか?(あてはまるものをすべて選択)
ブラウザ履歴・作業内容という機微なデータを扱います。問題定義の段階で境界を確認させてください。
- A. すべての処理・データはローカルマシン内で完結すること(外部送信しない)
- B. 業務と無関係な閲覧(私用サイト等)は除外・マスクできること
- C. 生成されたログファイル自体の保存場所・保持期間を自分で管理できれば十分</l
- D. 特に強い制約はない(個人利用の範囲で常識的であればよい)
- X. Other (please specify)
[Answer]: A, B(すべてローカル完結・外部送信なし / 業務と無関係な閲覧は除外できること)
Mode: direct / 回答日時: 2026-08-21T07:53:24Z
この回答から
「ローカル完結・外部送信なし(例外は GitHub への検索クエリのみ)」
「AI の推定は確信度付きの下書きにとどめ、人間が最終確認する」
「分類はルールベースのみで LLM を使わない」
という 3 つの方針が固まり、以降のすべてのステージで守る前提として記録されました。
人間の回答が揺れたときの扱いも記録に残ります。要件分析ステージでは、タスク分類の単位について私が一度「チケット ID 単位」と答え、AI の追加質問(チケット ID をどこから取得するのか)を受けて撤回しました。その経緯ごと質問票に固定されています。
[Answer]: C(プロジェクト × 作業カテゴリの 2 軸)。※初回回答は D だったが、
follow-up(チケット ID の取得元確認)を受けて利用者が D を撤回し C に確定
**Mode:** guided / **回答日時:** 2026-08-24
続いて注目したいのは自己学習ループ(learning loop)です。序盤に「上流の確定事項から導出できることは質問しない」という運用ルールを承認したところ、この学びがプロジェクトメモリに書き込まれ、後半のステージでは質問がゼロになりました。代わりに「どの上流文書から何を導出したか」の対照表が残ります。書き込まれたルールの現物はこうです(aidlc/spaces/default/memory/project.md)。
## Code Style
- 対応環境は macOS + Chrome 固定。移植性の抽象化レイヤは作らない(YAGNI、ソロ利用)
  (learned 2026-08-23)
## Tech Stack
- 設定ファイル形式は JSON(Python 標準ライブラリで読み書き両対応なのは JSON のみ。
  tomllib は 3.11+ かつ読み取り専用) (learned 2026-08-23)
## Decided
- DECIDED: データソースの数え方は「3 ソース(git/GitHub を 1 扱い)・4 収集経路」で統一
  (Stage scope-definition, 2026-08-24) (learned 2026-08-23)
3 件とも出どころは私とのやり取りです。上の 2 つは、質問への回答から学びとった環境と技術選定の制約(Mac + Chrome 以外は考えない、設定ファイルは JSON にする)。3 つ目は、git と GitHub を同じ系統と数えるかどうかで文書ごとに揺れていた表記を、私が一度指摘しただけで以降の全文書に効く決定として固定したものです。一度の指摘が仕組みとして定着する — レトロスペクティブに対応するのが learning loop だという 2 章の話が、目の前で実演された形です。
AI レビュアーが NOT-READY を突きつける
要件・設計の各ステージには専任のレビュアーエージェントが付き、READY 判定が出るまで作成者(これも AI)と修正ループを回します。結果は以下の通りです。
| ステージ | 1 巡目の判定 | 代表的な指摘 |
|---|---|---|
| 要件分析 | NOT-READY(HIGH 2 件含む 6 件) | 時間帯の集計単位(バケット)の幅が未定義で、受け入れ基準がテスト不能 |
| ユーザーストーリー | NOT-READY(HIGH 2 件含む 5 件) | 除外ドメイン要件にストーリーがないのに、要件とストーリーの対応表上は「カバー済み」に見える |
| アプリケーション設計 | READY(指摘 5 件) | モジュール数の記載が 7 なのに列挙すると 9 |
| Unit 分割 | NOT-READY(CRITICAL 1 件) | 下流工程が読む機械可読の依存 DAG(Directed Acyclic Graph、有向非巡回グラフ)が丸ごと欠落 |
検出された指摘は合計で 30 件を超え(CRITICAL 1 件・HIGH 8 件を含む)、すべて修正してから実装に入りました。どれも、放置すれば実装に入ってから設計に戻ってやり直すことになる類の欠陥です。レビューの往復は監査ログにイベントとして残ります。次の抜粋は要件分析ステージの実記録で、1 つ目のイベントがレビュアーの完了報告(Verdict 行が判定。講評は英語で出力されます)、2 つ目がそれを受けた要件文書の修正開始です。タイムスタンプに注目してください。
## Subagent Completed
**Timestamp**: 2026-08-23T17:15:44Z
**Event**: SUBAGENT_COMPLETED
**Agent Type**: aidlc-product-lead-agent
**Message**: **Reviewer:** aidlc-product-lead-agent

## Review
**Verdict: NOT-READY**
This is a strong artifact for a solo weekend-scale tool. Traceability is
exemplary — every FR cites its Q&A answer or upstrea…(以下略)

## Artifact Updated
**Timestamp**: 2026-08-23T17:16:00Z
**Event**: ARTIFACT_UPDATED
**File**: …/inception/requirements-analysis/requirements.md
「NOT-READY 判定 → 16 秒後に修正開始」という応答速度も含めて、人間のレビュー会では成立しないループです。レビューを通じて設計そのものも変わりました。データ収集部(コレクター)の戻り値は当初の list[Activity] から、一部のソースが失敗したときに警告を一緒に返せる CollectResult(activities, warnings) に変わり、上流の設計文書まで遡って修正されています。
Unit 分割と Bolt — Walking Skeleton で縦に切る
Unit of Work は 3 つ生成されました。(以下 UW は Unit of Work の略)。
UW-1 が「git コミットだけを入力に、設定 → 収集 → 突き合わせ → 描画 → CLI の全層を端から端まで貫通する最小構成(walking skeleton と呼ばれます)」、
UW-2 がコレクター 3 種の追加、
UW-3 が確信度モデルと運用仕上げです。
実装はこの順に 3 本の Bolt として実行されました。計画ステージ(delivery-planning)が生成した Bolt 計画の現物(Bolt 1 の行)を抜粋します。
## Bolt 1: core-skeleton 【WALKING SKELETON・ゲート付き】

| 項目 | 内容 |
|------|------|
| 含む Unit | UW-1 コアスケルトン |
| スケルトン証明レイヤ | 設定 → 収集(git) → 相関 → 描画 → CLI/ファイル I/O の全 5 層を貫通 |
| Definition of Done | `worklog --date <日>` がコミットのみの下書き Markdown を生成する。
|                    | config 検証・bucketize・classify・render の単体テスト + E2E 1 本が green |
| 確信度仮説 | 「Activity 契約と純粋関数 correlate を軸にしたパイプライン構造で、
|            | 残り 2 Bolt が既存コード変更なしの追加だけで載る」ことを証明する |
| デモ | 実リポジトリのコミット履歴から当日下書きを生成して見せる |
表中の「確信度仮説」はワークフロー側の用語で、この Bolt で確かめたい設計上の見込みを指します(ツールの出力に付く確信度とは別物です)。Bolt ごとに Definition of Done とこの仮説が事前に決まっている点は、スプリントゴールの運用に馴染んだ読者には納得感があるはずです。
Construction の仕組みで特筆すべきは、実装と検証を別の主体が担っている点です。各 Bolt は git worktree(同じリポジトリを別ディレクトリに展開する Git の機能)上に隔離して実装され、実装した AI とは別の検証ツールが自分でテストを走らせ、全件成功していること・保護対象のファイルが書き換えられていないことを確認したものだけが main にマージされます。実装 AI の「テストが通りました」という報告は、そのままでは採用されないということです。テスト数は Bolt 1: 46 → Bolt 2: 83 → Bolt 3: 101 と積み上がり、最終的に 101 件すべてが通りました。
完成したツールと数字
出力を見る前に、ツールの動作をかいつまんで説明します。ツールは 1 日分の活動の痕跡を 4 つの経路(ローカル git のコミット、GitHub の PR、Chrome の閲覧履歴、Claude Code のセッションログ)から集め、30 分単位の時間帯(バケット)に割り付けます。各時間帯を「プロジェクト × 作業カテゴリ(開発・レビュー・会議など 7 種)」の 2 軸で分類し、その時間帯を裏付ける独立した証拠が多いほど高い確信度(✓ 高 / △ 中 / ? 低)が付きます。
実際の出力がこちらです。フルタイムの出勤日 1 日分の実データを集計した下書きから抜粋します(プロジェクト名は仮名に差し替え)。
# 業務ログ下書き — 2026-08-14

合計: 11時間30分(690分 / うち未分類 0分)

| プロジェクト | カテゴリ | 分 | 確信度 |
|---|---|---:|:---:|
| プロダクトA | 開発 | 54 | △ |
| プロダクトA | レビュー | 54 | ? |
| プロダクトB | レビュー | 10 | ? |
| 社内ツール | 開発 | 40 | △ |
| 共通 | 会議 | 33 | ? |
| 共通 | 事務 | 147 | ? |
| 共通 | 調査 | 137 | ? |
(一部の行を省略)
コミットのある時間帯は「開発」(確信度 △)として、コミットがなくても GitHub 上で PR を閲覧していた時間帯はリポジトリ単位の「レビュー」として拾われます。会議や勤怠処理のように特定プロジェクトに紐づかない時間は、設定の対応表に基づいて「共通」プロジェクトに計上されます。閲覧履歴だけが根拠の行には低い確信度(?)が付くため、人間が確認すべき箇所は一目でわかります。対応表にまだ載っていないドメインは未分類として列挙され、設定ファイルにそのまま貼れるスニペットが付くので、使えば使うほど分類の精度が上がっていきます。
生成されたコードの品質も見ておきます。上の表の確信度(✓/△/?)を決めている関数の現物です(worklog/correlate.py)。ルールは一言でいえば「独立した証拠が何本あるか」です。コミット・PR・Claude Code セッションの 3 経路は互いに独立した証拠として数え、閲覧履歴(chrome)は単独では証拠にならない「補強」として扱います。docstring 中の S・B・C はその 3 要素(独立ソース数・関与した時間帯数・補強の有無)の略記、A-20 / BR-60 といった記号は設計文書の判断 ID で、このコードがどの要件から来たかをたどるためのトレースです。
def confidence(sources: FrozenSet[str], bucket_refs: Tuple[datetime, ...]) -> str:
    """A-20/BR-60: 統合 Entry の (sources, bucket_refs) の純粋関数として確信度を算出。

    S = 寄与した独立ソース集合(git/github/claude)、B = 寄与バケット数、
    C = chrome(従属)寄与の有無:

        high : |S| >= 2                       — 独立ソース 2 種以上の一致
        mid  : |S| == 1 かつ (B >= 2 または C) — 単一独立ソース + 補強
        low  : それ以外                        — 単発・単一、または従属寄与のみ

    決定的(集合サイズと真偽値のみ)。BR-62 の単調性を構成的に満たす。
    """
    independent = sources & INDEPENDENT_SOURCES
    if len(independent) >= 2:
        return "high"
    if len(independent) == 1 and (len(bucket_refs) >= 2 or "chrome" in sources):
        return "mid"
    return "low"
ワークフロー全体の数字は次のとおりです。
| 指標 | 値 |
|---|---|
| 実行ステージ | 15 / 32(composer が構成した custom scope local-tool) |
| AI レビュアーの検出指摘 | 30 件超(CRITICAL 1 件・HIGH 8 件)— すべて修正 |
| 蓄積された学習ルール | 10 件 |
| 最終テスト | 101 / 101 PASS |
| 実データ 1 日分の生成時間 | 5.6 秒(目標 30 秒) |
| 追加依存パッケージ | 0(Python 標準ライブラリのみ。テストも unittest で実行) |
| ワークフロー実働時間 | 約 3 時間 30 分(最初の質問票から最終テスト完了まで。断続実行の実働ベース) |
完走後のリポジトリには、コードと同じだけの「判断の記録」が残ります。
aidlc/spaces/default/intents/260821-local-tool/
├── ideation/       # 質問票(回答・日時入り)・実現性評価・制約台帳・スコープ文書
├── inception/      # 要件・ストーリー・設計・Unit 分割・Bolt 計画(+各ステージの観察日誌)
├── construction/   # uw-1〜3 の機能設計・非機能要件 + コード生成計画(uw-3) + テスト結果
├── verification/   # フェーズ検証レポート
└── audit/          # 全イベントの監査ログ(レビュー判定・承認・自律移行を含む)
worklog/            # 生成された Python パッケージ
tests/              # 101 本のテスト
構成図だけでは中身が伝わらないので、代表的な成果物を 2 つ抜粋します。まず要件書(inception/requirements-analysis/requirements.md)。全 20 件超の要件が ID・合格基準付きの表になっており、冒頭には根拠にした上流文書、各要件には質問票のどの回答から来たか(例: 「Q1: C」)が記録されています。
# Requirements — 業務ログ自動生成ツール

> 根拠: intent-statement、scope-document、requirements-analysis-questions.md
>      (全 4 問 + follow-up 1 件解消済み)

| ID | 要件 | 合格基準 |
|----|------|----------|
| FR-32 | 各バケットをプロジェクト × 作業カテゴリの 2 軸で分類する
|       | (Q1: C)。分類手段は対応表 2 種(FR-14)のみ
|       | → 対応表で解決できたものは 2 軸が付き、できないものは「未分類」になる |
| FR-33 | 各項目に確信度(高/中/低)を付与する
|       | → 複数ソースの信号が一致した項目は単一ソースのみの項目より高い
|       |   確信度になる。確信度の算出根拠が仕様に明文化されている |
FR-32 の「Q1: C」は、先ほど紹介した「一度 D と答えて撤回し C に確定した」あの質問への参照です。先ほど見た確信度関数 confidence() も FR-33 の「算出根拠の明文化」が要件として先にあり、それを実装した結果ということになります。
もう 1 つは設計判断の記録(inception/application-design/decisions.md)。各判断が Context・Decision・棄却案・可逆性のセットで残る ADR(Architecture Decision Record)形式です。
## ADR-1: 単発実行 CLI パイプライン(常駐なし)

- **Context**: 日次で下書きを生成する手段として、単発 CLI /
  常駐デーモン(バックグラウンド収集)/ スケジューラ登録(launchd)が考えられる
- **Decision**: 引数なし 1 コマンドの単発実行 CLI とする
- **Consequences**: 実装・デバッグが最も単純。実行時にのみデータに触れるため
  プライバシー説明が容易。リアルタイム収集はできないが、全ソースが履歴を
  持つため実行時遡及で十分
- **Alternatives Rejected**: 常駐デーモン — 収集は既存履歴の読み取りで足りる
  ため常駐の複雑さが無価値。launchd 登録 — 習慣付けは利用者の裁量に残す
- **Reversibility**: 高(後から launchd をかぶせるのは自由)
「デーモンにしない理由」「launchd(macOS のジョブ常駐の仕組み)に登録しない理由」まで棄却案として残っている点に価値があります。半年後に「常駐化したい」と思ったとき、当時何を比較してなぜ捨てたかをゼロから考え直さずに済みます。
人間不在の承認は、ツールが拒否する
最後に、AI-DLC が掲げる human-centric(人間中心)が実装でどう担保されているかがよく分かる挙動を紹介します。Construction の途中、私は残りの工程の完了を指示して離席してみました。AI がその指示を根拠にゲートを承認しようとした結果、エンジンに拒否されたときの監査ログがこれです(Error 行は原文そのままです)。
**Error**: Refusing to approve "functional-design": a real human has not acted
  at this gate since it opened. The approval gate requires a typed human turn
  before it can commit. Acknowledge the gate as a human, then approve.
  (autonomous Construction is exempt)
「人間の指示があった」と AI が主張しても、承認ゲートは「ゲートが開いてから人間が実際にタイプしたか」を検証する仕組み(コード中では human-presence gate と呼ばれています)によって拒否します。人間不在のまま先へ進む唯一の正規の方法は、人間があらかじめ自律実行モードへの移行を選んでおくことでした。この「任せた」という事実も、監査ログにイベントとして残ります。
## Autonomy Mode Set
**Timestamp**: 2026-08-23T18:21:32Z
**Event**: AUTONOMY_MODE_SET
**Mode**: autonomous
AI が勝手に先へ進むことはできず、できるのは人間が記録を残した上で任せることだけ。AI-DLC が掲げる human-centric が飾りでないことを、いちばんよく示している挙動です。
4. やってみてわかったこと
結論から言うと、AI-DLC の価値は「速く作れること」ではなく「判断が形に残ること」でした。
有効だった点
質問の質が高い。 Intent Capture の 7 問は、機能の話をほとんど聞いてきませんでした。聞かれたのは「一番困っていることは何か」「成功をどう測るか」「データの取り扱いで守りたい境界はどこか」です。vibe coding で作った既存版では、これらを一度も言語化しないまま実装していました。動くものは同じでも、「なぜこう作ったか」が残っているかどうかは、半年後の自分にとって大きな差になります。
SKIP にも理由が残る。 composer の提案では、実行しない 17 ステージすべてに理由が付きました。「やらなかったこと」の判断根拠が残る点は、より方針選択の根拠を強固なものにします。
レビュアーは飾りではない。 実装前の指摘は 30 件を超え、うち CRITICAL と HIGH が 9 件でした。「要件との対応表の見た目ではなく、受け入れ基準の本文が要件を満たしているかを読む」という検証姿勢がとられている点は優れています。
つまずいた点
セットアップの罠。 前述のとおり、同梱 settings.json が Bedrock 前提である点は、Claude サブスクリプションで使う人が最初に引っかかるところです。
承認ゲートの負荷は軽くない。 今回の構成で承認ゲートは 12 回でした。1 回ごとの判断は数分で済むものの、「読んで判断する」行為が連続するため、従来の「AI に投げて放置」とは明確に体験が違います。2 章で「後半のデモで報告する」とした検証時間の実態がこれです。ただし欠点というより、AI-DLC が要求する働き方そのものでもあります。Bolt の速いサイクルは、人間がそのつど判断に応じるか、記録を残して自律実行に任せるか、どちらかを明示的に選ぶことで成立します。
GA Preview の現実。実装において若干の不安定な挙動がありました。 監査ログのコミット方針と Bolt 用 worktree の分岐が衝突して 3 回とも手動リカバリが必要だったこと、上流ステージが付けた Unit ID UW-1 が下流の命名検証(小文字必須)で弾かれたこと、レビュアーの既定モデルが環境で使えず上書きが必要になったこと、の 3 点です。どれも致命傷ではなく、そして興味深いことに、つまずきと回避策自体がステージごとの作業記録(観察日誌)と監査ログに残るため、次に回すときは同じ轍を踏まずに済みます。
Vibe Codingで実装した場合との比較 — 差は「動くか」ではなく「残るか」
同じ題材を vibe coding で 4 時間で作った既存版と比べると、動くものという意味では両者に大差はありません。テストも両方にあります。決定的に違うのは残っているものです。既存版には「なぜ時間帯のバケット幅が 30 分なのか」「なぜ閲覧履歴を確信度の主証拠に数えないのか」という判断の記録が一切ありません。AI-DLC 版には、すべての実装判断が要件 → 設計 → コード → テストへとたどれる証跡として残っています。半年後にこのツールを直すとき、どちらの自分が楽かは明らかです。
v2 の仕組みは、どれも人間の承認を軽くするためにある
デモを終えて振り返ると、私が費やした時間はほぼすべて「AI の提案を読んで判断する時間」でした。コードもテストも文書も AI が書くので、ワークフロー全体の所要時間は、承認ゲート 12 回にどれだけかかるかでほぼ決まります。この見方で 3 章を振り返ると、一見バラバラに見えた v2 の仕組みには共通点があります。どれも、人間の承認にかかる手間を減らす方向に働いているのです。デモで実際に起きたことと対応させてみます。
- 選択式の質問票は、1 回の判断を軽くします。Q1 への回答は「E — 主は C、副として B」の 1 行です。この 1 行から「ローカル完結」「確信度付きの下書き」「分類に LLM を使わない」という 3 つの方針が決まりました。白紙から要件を書き起こすのに比べて、人間が書く量のわりに決まることが多い形式です
- learning loop は、同じことを二度判断させません。序盤にルールを 1 つ承認しただけで後半のステージでは質問がなくなり、ゲートで読むものは「どの上流文書から何を導出したか」の対照表だけになりました。蓄積された 10 件のルールは、次の開発にもそのまま引き継がれます
- composer と scope は、承認が発生する場所そのものを減らします。17 ステージの SKIP は、読まなくてよい成果物が 17 ステージ分減ったということです。全 32 ステージを実行していたら、ゲートは 12 回では済みませんでした
- AI レビュアーは、人間がゲートで読む文書の質を先に引き上げます。私が承認した要件・設計文書は、「モジュール数が 7 と書いてあるのに列挙すると 9」のような不整合が 30 件以上修正された後のものです。おかげで人間は方針の妥当性だけを見ればよく、誤記や矛盾を探すことに時間を使わずに済みました。NOT-READY から 16 秒で修正が始まる往復に、人間の時間は使われていません
- 自律実行モードと人間の実在チェックは、判断を手放すときの条件をはっきりさせます。ゲートに応答できない時間帯は記録を残した上で任せることができ、任せていないのに AI が先へ進むことはできません
実装が一晩で終わっても、承認 12 回が重ければこの体験は成立しません。v2 の設計の力点は「AI を速くする」ことではなく「人間の承認を軽くする」ことに置かれていることが、デモの経過からも読み取れます。
AI の報告を信用しない仕組みが、人間の確認作業を減らす
もう 1 つの発見は、v2 が「AI の報告をそのまま信用しない」ための検証を三重に用意していることです。それぞれが防いでいる事故と、そのおかげで人間が省ける作業は、具体的に挙げることができます。
- オーケストレーションエンジンは、「次に何をするか」を LLM に選ばせず、指示を 1 手ずつ渡します。手順どおり進むことがエンジン側で保証されるため、ステージを勝手に飛ばしていないかを人間が見張る必要がありません
- Bolt の検証ツールは、実装 AI の「テストが通りました」という報告を採用しません。worktree 上で自分でテストを走らせ、保護対象のファイルが書き換えられていないことまで確かめてからマージします。101 本のテストが本当に通っているのかを私が確かめ直さずに済んだのは、この再実行があるからです。vibe coding で作った既存版では、この確認は自分の仕事でした
- 承認ゲートの人間実在チェックは、AI による承認の代行を拒否します。3 章で見たとおり「人間の指示があった」という AI の主張は通らず、離席中に指示が拡大解釈されて工程が進む事故は起こりようがありません
3 つに共通するのは、「AI の出力を疑う」作業のうち機械にできる部分 — 手順どおりか、テストは本当に通ったか、承認したのは人間か — を機械に任せ、人間には方針の判断だけを残すという分担です。「判断の記録が残る」ことの実利もここにあります。要件から設計・コード・テストまで遡れる形で書くことが強制されているからレビュアーは機械的に検証でき、検証されているから「それらしく書かれただけの文書」が成果物に紛れ込みません。半年後にこのツールを直すとき、私は記録を辿れるだけでなく、その記録が検証済みであることまで当てにできます。
まとめ
- AI-DLC は、AI が提案して人間が承認する形に役割を入れ替えた方法論であり、スクラム の経験主義(透明性・検査・適応)を監査ログ・承認ゲート・learning loop として実装し直したものでした。awslabs/aidlc-workflowsはAWSがこの考え方を実装したツールで、今回はv2を用いて実際にツールを作成してみました。
- 開発の所要時間を決めたのはコーディングではなく、承認ゲートで提案を読んで判断する時間でした。選択式の質問票・learning loop・composer・AI レビュアーといった aidlc-workflows v2 の仕組みは、いずれもこの判断の手間を減らす方向に働きます。
- aidlc-workflows v2 は AI の報告をそのまま信用せず、手順の進行はオーケストレーションエンジンが管理し、テストは実装とは別のツールが再実行し、承認したのが人間であることまで検証します。「AI の報告は本当か」を確かめ直す作業は機械が肩代わりし、すべての判断は要件からテストまで辿れる検証済みの記録として残ります
- aidlc-workflows v2 は GA Preview であり本番用途には main ブランチが推奨されています。それでも「AI に作らせたものに説明責任を持つ」次のフェーズを先取りする体験として、試す価値は十分にあります
参考文献
- AI-Driven Development Life Cycle: Reimagining Software Engineering(AWS DevOps Blog、2025-07-31)
- Open Sourcing Adaptive Workflows for AI-Driven Development Life Cycle (AI-DLC)(AWS DevOps Blog、2025-11-29)
- awslabs/aidlc-workflows(v1.0.1 / v2 ブランチ tag v2.3.0、MIT-0)
- AI-DLC Workflows 2.0 Specification(v2 ブランチ同梱の whitepaper PDF)
最後に
グループ研究開発本部 次世代システム研究室では、最新のテクノロジーを調査・検証しながらインターネット上の高度なアプリケーション開発を行うエンジニア・アーキテクトを募集しています。募集職種一覧 からご応募をお待ちしています。

グループ研究開発本部の最新情報をTwitterで配信中です。ぜひフォローください。
Follow @GMO_RD