2026.10.01
AI にオントロジーのたたき台を作らせてみた:熊本地震の公開データで試した試行錯誤
こんにちは。AI 研究開発室の M.K. です。
皆さん、オントロジーはご存じですか?2000年代初頭のセマンティック・ウェブの頃から言われていた言葉ですが、昨今ますますホットなキーワードになってきているように思います。
生成AIの大規模言語モデル(LLM)が世の中に浸透し、LLM がどんどん高性能・巨大化する中で、適切に使いこなすには外部や独自の知見&専門知識をうまく与えて制御することが求められます。
従来の RAG(Retrieval-Augmented Generation)は社内データを類似検索して抜粋して LLM に投げる形なので、限界がありました。
より使いこなすために、様々な RAG 応用が出てきて、その中にグラフ RAG というものがあります。グラフは情報同士の関係まで表現でき、体系的な知識を表現することができます。このグラフをうまく LLM に組み合わせたのがグラフ RAG で、オントロジーはこのグラフ構造をしているので、グラフ RAG のように LLM を使うことが想定されます。
では LLM を使いこなすという話だったらグラフ RAG を突き詰めればいいじゃないか、となりますね。その通りでもあるのですが、このグラフを適切に構築・運用するというのは実は非常に難しいことだったりします。
オントロジーはそれを簡単にしてくれる魔法の道具・・なんてことはなく、グラフの構築・運用を実世界で役立つものにするための方法論を提供するようなものと思ってます。
そしてそれがうまくできれば、LLM と相性よく今まで以上に LLM を使いこなせる、だからこそオントロジーは今注目されているのではないでしょうか。
今回はこのオントロジーを、熊本地震(令和8年)の公開データを使って、専門家の手を借りずに AI で試行錯誤した例を紹介します。
目次
1. オントロジーとは何か
グラフとの違い
「ノードとエッジのグラフ」と「オントロジー」は似ているように見えて、性質が異なります。
- クラスとインスタンス:オントロジーでは「カレー屋」というクラス(型)と、「ココ壱番屋〇〇店」という個々のインスタンス(実例)を区別します。単純なグラフはこの区別を持たないことが多いです。
- 関係の意味:「オープンする」という関係(プロパティ)には、主語の型(domain)と目的語の型(range)が定義されます。「オープンする」の主語は組織や役職で、目的語はお店、といった具合です。
- 制約:OWL(Web Ontology Language)で「このクラスのインスタンスは必ず1つ以上の管轄組織を持つ」といった制約を、SHACL(Shapes Constraint Language)で「このプロパティの値は必ず日付型でなければならない」といった検証ルールを書けます。
- 推論:「カレー屋」が「飲食店」のサブクラスであると定義すれば、「A 店はカレー屋である」という事実から、「A 店は飲食店である」という事実も自動的に導けます。逆は成り立ちません。飲食店であっても、カレー屋とは限らないからですね。また、「飲食店」が持つ性質(営業時間や所在地など)は、カレー屋にも性質として引き継がれます。
RDF の最小例
オントロジーの多くは RDF(Resource Description Framework)という「主語・述語・目的語」の3つ組(トリプル)でデータを表します。最小の例はこうなります。
@prefix ex: <http://example.org/> .

ex:cocoichiA a ex:CurryShop .              # 「ココ壱番屋 A 店」は「カレー屋」である
ex:cocoichiA ex:locatedIn ex:ChofuCity .   # 「ココ壱番屋 A 店」は「調布市」にある
ex: は説明用の架空の語彙です。これを大量に集めたものが RDF グラフであり、その上に「クラスと関係の定義」を載せたものがオントロジーです。
なぜ今、注目されているのか
オントロジーやナレッジグラフが改めて注目されている背景には、LLMを使うことが当たり前になってきたことに加えて、いくつかの理由があります。
- RAG のハルシネーション(捏造)を抑えたい
- AI エージェントに、構造化された業務知識や権限の情報を渡したい
- 部署や組織をまたいでデータを統合したい
- そのため、従来のベクトル検索ベースではないグラフ RAG が求められるようになった
いずれも「AI に何を渡してどう答えてもらうか」という問題で、オントロジーはその答えの一つになります。では、その中身をどう組み立てればいいのか。次の章で見ていきます。
2. 名詞・動詞・権限の3層と、それを支える標準
3層に分ける考え方
オントロジーを考える際に「名詞(誰が・何を)」「動詞(行い)」「権限」という3つの層に分ける考え方があります。実運用に役立つものとするには「動詞(行い)」を AI が提案したりすることが求められ、ガバナンス上「権限」が必ず必要になるからです。
この3層を普段使う言葉で表したものを上に置き、その下に厳密なオントロジーを敷くことで、人が理解しやすく確認できるオントロジーを構築できないか、と考えました。それを公開データを使ってまずは作ってみようというのが今回の検証です。
下敷きにしたオントロジーの手法
下の層には、次のような公開された手法を導入することを考えてみました。
- BFO(Basic Formal Ontology):時間の中で持続する物(continuant)と、時間の中で起きる出来事(occurrent)を大きく分ける、オントロジーの国際標準(ISO/IEC)です。災害の例で言えば、「避難所」という施設は continuant、「避難所を開設する」という出来事は occurrent(process)に当たります。「指定避難所である」という立場は role(役割)として、施設そのものとは別に扱います。
- RO(Relation Ontology):
has_participant(誰が関わったか)やhas_output(何を生み出したか)のような、関係そのものを定義する標準です。 - IAO(Information Artifact Ontology):報告書や計画書のような「情報の実体」を扱う標準です。
さらに、これらを実装に落とすときに LinkML を使いました。LinkML は YAML でスキーマを書くと、そこから OWL・SHACL・JSON Schema・Pydantic のコードなどを生成できる仕組みです。ただし注意点があります。LinkML は「書いたスキーマを複数の形式に変換する」ためのものであり、「何をノード(クラス)にすべきか」という設計判断そのものは決めてくれません。この判断は人(または後述する AI への委任)が行う必要があります。
ここで一つ、限界にも触れておきたいと思います。BFO に準拠していても、「災害」を process(出来事)として捉えるか disposition(傾向・素因)として捉えるかは、作る人によって割れます。準拠したからといって「同じ答えになる」ことを保証してくれるわけではなく、設計判断の余地が大きく難しい課題です。
CQ を SPARQL で検証する
能力質問は、それ単体では「答えられるはずの問い」のリストに過ぎません。実際にオントロジーが使えるかを確かめるには、CQ を SPARQL(RDF グラフに対する標準のクエリ言語)に落とし込んで、実データに対して走らせる必要があります。
例えば「避難所を開設する役割を担うのは誰か」という CQ は、架空の語彙(ex: 以下はすべて説明用の架空のプロパティ・クラス)を使うと、次のような SPARQL に置き換えられます。
PREFIX ex: <http://example.org/disaster-ontology#>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>

SELECT ?shelter ?shelterLabel ?opener ?openerLabel
WHERE {
  ?shelter a ex:EvacuationShelter ;
           rdfs:label ?shelterLabel .
  ?act a ex:ShelterOpeningAct ;
       ex:actsOn ?shelter ;
       ex:performedInRole ?role .
  ?role a ex:ShelterOpeningRole ;
       ex:heldBy ?opener .
  OPTIONAL { ?opener rdfs:label ?openerLabel . }
}
「避難所を開設する行為(ShelterOpeningAct)」が「避難所を対象に行われ(actsOn)」、その行為が「開設する役割(ShelterOpeningRole)」の下で行われ、その役割を「誰か(heldBy)」が担っている――という経路をそのままクエリの形にしています。CQ を SPARQL に落とすと、良し悪しが「読んで納得できるか」ではなく「実データに対して実際に答えが返ってくるか」という、機械的に確かめられる基準に変わります。この「実データで確かめる」姿勢は、今回の検証の根幹を成しています。
3. 熊本地震(令和8年)の公開データで AI にたたき台を作らせた
ここからが本題です。熊本地震(令和8年、2026年)の公開データを使い、AI に上のようなオントロジーのたたき台を作らせる検証を行いました(平成28年、2016年の熊本地震ではありません)。
使ったデータ
主に次の公開資料を使いました。大きく分けて、災害の「状況」を表すデータと、その状況で「誰が何をすべきか・してよいか」(規範)を定めた資料の2種類です。
状況を表すデータ
- 熊本県が公開している報道資料(被害状況等)
- 内閣府(防災担当)が公開している被害状況等の資料
- 国土地理院が公開している指定緊急避難場所・指定避難所の台帳(CSV/GeoJSON)
あわせて、規範の出どころとして、災害対策基本法や防災基本計画などのデータも使いました。
全体の流れ
大まかな流れは、データから LLM で「誰が・何を・どうした」という構造を抜き出し、グラフに組み立てて、最後に能力質問で評価する、というものです。
Claude Code と相談しながら、基本的には LLM の提案に沿って作っていきました。ところが、難易度が高いことをしているせいか、問題がよく出てそれを解決することに LLM が躍起になって、本来の大きな目的よりも目先の問題にフォーカスがあたり、時間をかけてもオントロジーができない・・いわゆる沼にハマってしまいました。
うまくいかなかったこと
取り組んだことのうち、うまくいかなかったものを表にまとめます。
| # | やったこと | 何が起きたか |
| 1 | 決まった型に合わせて、LLM で文書から一気に抜き出す | 処理は「完了」になるのに、中身(いつの情報か、誰の報告か)が全件空だった |
| 2 | 表は LLM を使わず機械的に読み、上位オントロジーの型を付ける | 表は全件読めたが、肝心の「何をノードにするか」が決まらないままだった |
| 3 | 正規表現で「〜が〜を〜する」を拾う | ほとんど当たらなかった |
| 4 | 抜き出しの崩れを LLM のせいだと考えて補正する | 良くならなかった。原因はもっと上流にあった |
| 5 | 分かりやすい2つの数字で進み具合を管理する | 数字を直接動かさない「骨組み作り」が後回しになり、出発点だった名詞・動詞・権限の3層を置き去りにしていた |
| 6 | 能力質問への回答率を上げるために、採点の基準を作り込む | 基準の細かい修正を繰り返すばかりで、回答率は1週間ほとんど上がらなかった |
| 7 | 欠けているつながりを AI の推論で埋める | 一部の問いには答えられるようになったが、答えの重複やノイズも増えた |
| 8 | 答えの採点を AI に任せる | 採点役の AI が明らかな欠陥を見逃した。モデルによって判定が正反対になることもあった |
こうした試行錯誤の結果、今のオントロジーの状態にたどり着く前に、10日以上の期間と、LLM の費用だけで約160ドル(API換算、記録に残っている分)がかかってしまいました。
今のオントロジーの状態
未だ完成とは言い難いですが、最新のオントロジーは、ノード47,346、エッジ167,715、RDF トリプルにして325,627という規模になりました。これを名詞・動詞・権限のどれに当たるかで分けて数えてみると、次のようになります。この分け方は私たちの解釈による参考値です。
| 分類 | ノード数 | 中身 |
| 名詞(組織・施設・地域など) | 3,454 | うち約9割(3,052)が国土地理院の台帳の避難所 |
| 動詞(行為) | 3,610 | うち3,052が「避難所を指定する」行為で、台帳の1件ごとに1つできている |
| 権限(規範) | 1,924 | 法令・通知・計画から取り出した「誰が何をすべきか・してよいか」 |
| 権限に付くもの(条件・期限・根拠条文など) | 4,189 | 規範の条件や期限、根拠の条文 |
| 観測・報告 | 33,907 | 熊本県・内閣府の被害状況の表から取り出した値と、その判定 |
| その他 | 262 | 行為の対象・場所など |
| 合計 | 47,346 |
「誰が・何を・どんな権限で」という本題に当たるのは、規範の1,924件とそれに付くものです。
その規範について見ると、「誰が(主体が実在の組織に結び付いた割合)」は72.2%、「何を(行為の型)」は76.0%と、かなり取れるようになりました。一方で、「誰に」「いつまでに」「誰の費用で」など、まだ弱いところも残っています。
直近の工夫で、ようやく改善が見え始めた
沼から抜け出すきっかけになったのは、LLM に任せきりにしていた「何を目指し、どう測るか」を、人の側で決め直したことでした。具体的には、次のような工夫です。
- ぶれやすい判断は LLM に選ばせない:義務か努力かといった区分のように、LLM に選ばせるとぶれる判断は、原文の文末から規則で決めるようにしました。
- 対象を広げる:一部の条文だけでなく、関連する法令などの全体から規範を取り出しました。
これらの工夫を入れてから、規範の数は847件から1,924件に増えました。この段階にかかった期間は2日ほど、LLM の費用は約40ドルでした。遠回りしてきた12日間と比べると、目指すものと測り方を人が先に決めておくことの大切さがよく分かります。
4. 格納と可視化
たたき台ができても、それをどう保管し、どう見せるかはまた別の問題です。ここからは、格納と可視化で考えたことをまとめます。
RDF トリプルストアと LPG
オントロジーはグラフのような構造を持つので、当初はグラフのためのデータストア(Neo4j など)を想定していたのですが、RDF を扱うより専門的な製品があることがわかりました。
RDF を保存する専用の仕組み(トリプルストア)と、Neo4j のようなラベル付きプロパティグラフ(LPG)は似ていますが違うものです。RDF は URI によってグローバルに一意な識別子を持ち、SPARQL・SHACL・OWL といった標準規格に準拠しています。一方で LPG はノードやエッジに任意のプロパティを直接持たせられ、Cypher のような実装依存のクエリ言語で操作します。
製品比較の要点
オンプレミスで動かす前提で、2026年9月時点の情報をもとに次の製品を比較しました。
- RDF トリプルストア:Ontotext GraphDB、Stardog、OpenLink Virtuoso など
- グラフ RAG 向けデータベース:Neo4j、PostgreSQL + Apache AGE、MongoDB など
評価の軸は、トリプルストア側では SPARQL 1.1 への準拠度、フェデレーション、OWL・RDFS 推論、SHACL 検証、全文・ベクトル検索との統合、可視化 UI、大規模データでの実績、クラスタ・冗長化、ライセンスなど、グラフ RAG 向けデータベース側では hop 数ごとのレイテンシ、探索の枝分かれ(fan-out)への強さ、複数の関係の種類をまたぐ探索、ベクトル検索との統合、グラフ RAG の構築しやすさなどです。
今回は検証ということもあり、Ontotext GraphDB のコミュニティ版を使って試してみました。
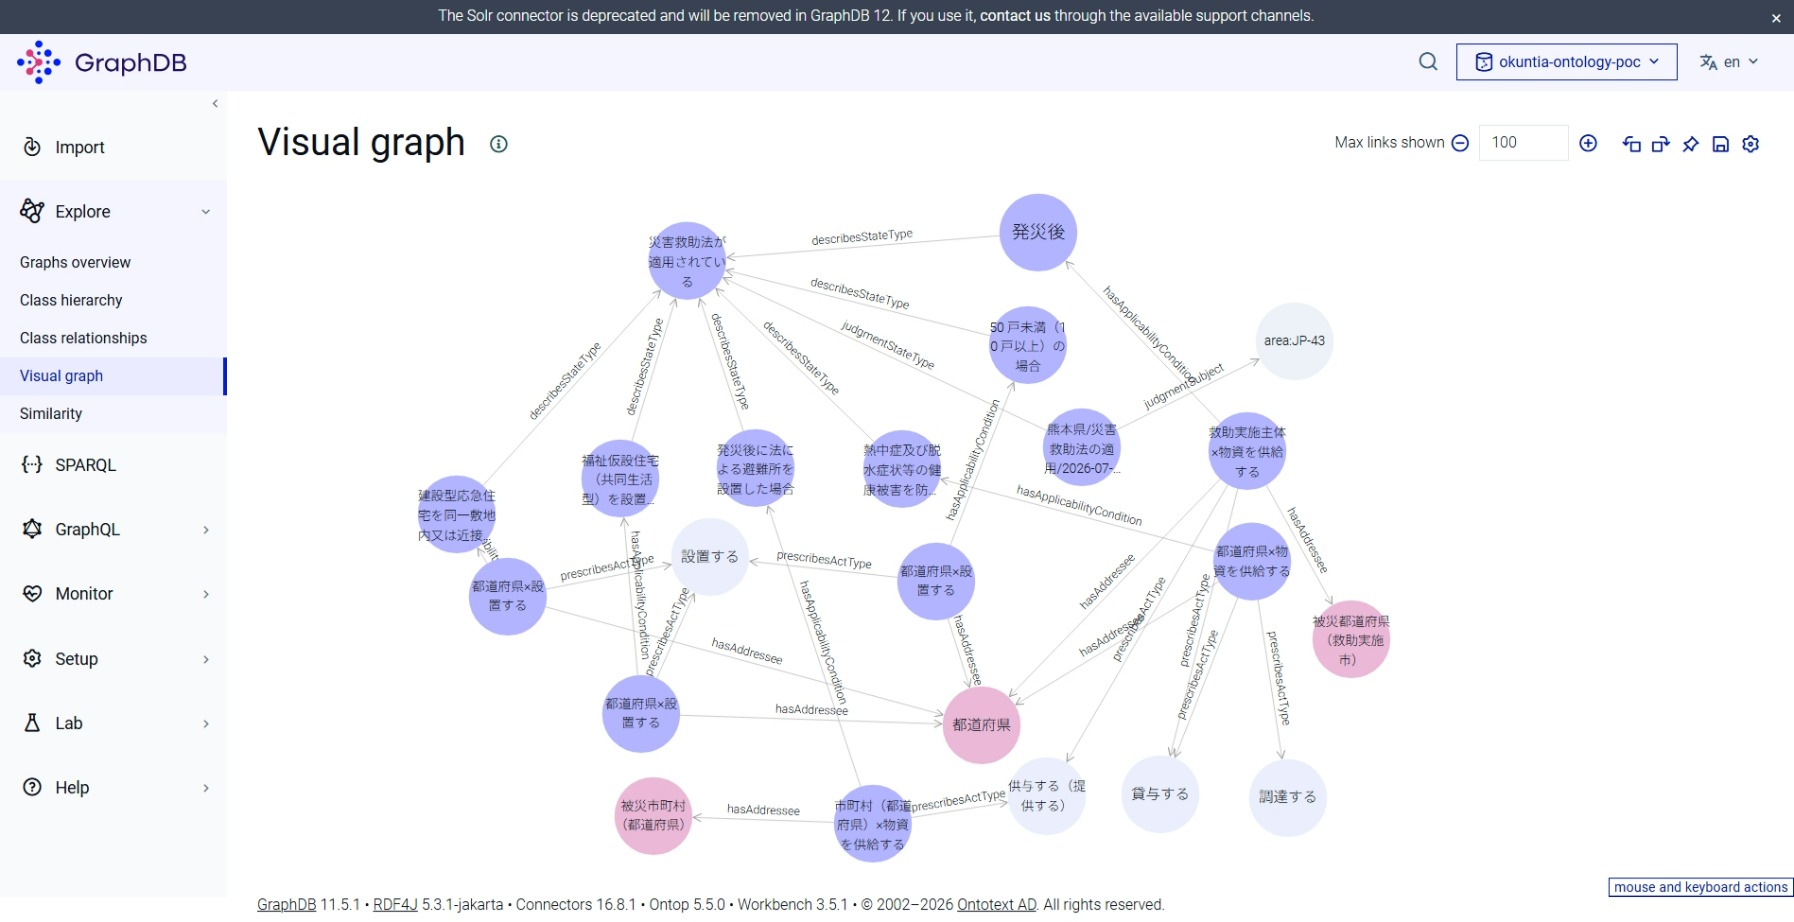
GraphDBによるオントロジー可視化の例
グラフ RAG との関係
最後に冒頭に述べた グラフ RAG との関係です。オントロジーを AI と組み合わせる以上、必然的にグラフ RAG のような製品を考えることになります。
グラフ RAG には、あらかじめ決めたスキーマを持たず、LLM が文書からその場でグラフを抜き出す方式と、オントロジーのような決まった型・関係を軸にしてグラフを組み立てる方式があります。前者は立ち上げが速く、想定していなかった関係も拾える一方、同じ実体が違う名前で重複しやすいという弱点があります。後者は型がそろっている分、能力質問のような決まった問いには答えやすい一方、型に収まらない情報を取りこぼしやすい面があります。
グラフ RAG をどのような設計にするかも大事な要素となります。
5. まとめ
今回の検証を通じて感じたのは、オントロジーはデータを用意して AI に任せたからといって容易に作れるものではないということです。それでも BFO・RO・IAO などや LinkML、SPARQL といった標準は、オントロジーを「独自すぎる」ものにしないための土台として、有用そうなことは感じ取れました。
そして、AI を使ったオントロジー構築において、目的や評価を相当しっかり考えて進めないと、間違いなく沼にハマるということです。
概念はわかるが、実際に自分たちの領域・業務に役立つオントロジーを作るのはやっぱり簡単でない、ということが改めてわかる検証となりました。
「オントロジーの構築にあたって AI にたたき台を作らせる」ことを検討している方の参考になれば幸いです。
6. 参考文献
- Basic Formal Ontology (BFO) 公式サイト:https://basic-formal-ontology.org/
- OBO Relation Ontology (RO) 公式サイト:https://oborel.github.io/
- Information Artifact Ontology (IAO) 公式リポジトリ:https://github.com/information-artifact-ontology/IAO
- LinkML 公式サイト:https://linkml.io/
- W3C SPARQL 1.1 Query Language:https://www.w3.org/TR/sparql11-query/
最後に
AI研究開発室では、データサイエンティスト/AIエンジニアを募集しています。AI/LLMを活用したシステム開発、AI×ロボットなどにご興味を持って頂ける方がいらっしゃいましたら、ぜひ募集職種一覧からご応募をお願いします。皆さんのご応募をお待ちしています。

グループ研究開発本部の最新情報をTwitterで配信中です。ぜひフォローください。
Follow @GMO_RD