2026.09.01
Claude Securityとsecurity-guidanceで開発初期から脆弱性対策を自動化
こんにちは。グループ研究開発本部のT.D.Qです。
私たちのチームは、2つのWebサービス(以下「リポジトリA」「リポジトリB」)を少人数で開発・運用しています。また、どちらもJWT認証、複数組織のデータ分離、LLM連携、メディアのストリーミングまで抱えている「攻撃面の広い」システムです。
この記事でわかること
- Claude Security による約29万行・2リポジトリのフルスキャンにかかった実時間(約2時間+約3.5時間)、トークン消費(約16.5億)、費用(API定価換算で約$1,715、Max 20xプランのため実請求は0円)
- 検出された脆弱性72件の深刻度・CWE別内訳
- AIが書いたパッチ9本が検証で却下された理由と、CLAUDE.md で再発防止を自動化する方法
なぜ開発初期にスキャンするのか
両サービスともまだ本番リリース前、開発初期の「一番コードが増える」時期です。特に、機能追加のスピードが最優先で、毎スプリント数十本のPRがマージされていきます。一方で、専任のセキュリティエンジニアはいません。そのため、「今この瞬間に積み上がっているコードに、後で直すと高くつく穴が混ざっているのでは」という不安をずっと抱えていました。
加えて、私たちのプロジェクトでは、本番リリース前に第三者によるセキュリティ監査を受け、指摘に対応したうえでリリースする計画です。つまり、脆弱性はいずれ必ず見つかり、必ず直すことになります。であれば、第三者監査の直前に大量の手戻りを抱えるより、開発初期のうちに自分たちで先に洗い出して潰しておく方が圧倒的に安い——それが今回スキャンを実施した動機です。
今回やったこと
そこで今回は、Anthropicが公開している Claude Security(Claude Codeのプラグイン)を使って、具体的には、2リポジトリをまるごとスキャンし、検出された脆弱性をパッチまで落とし込み、さらに再発防止のルールを CLAUDE.md 経由でAIに読み込ませるところまでやってみました。
さらに本記事では、実際にかかった時間・トークン数・検出件数・却下されたパッチの理由まで、手元のログから拾った数字をそのまま公開します。「Claude Code のAIセキュリティスキャンって実際どのくらい使えるの?」「コストはどのくらい?」と気になっている方の判断材料になれば幸いです。
1. はじめに・今回やりたいこと
先にお断りしておくと、本記事に出てくる「脆弱性72件」は本番稼働中のシステムの話ではありません。リリース前の開発初期コードに対する内部スキャンの結果であり、検出された指摘は第三者監査の前にすべて対応する前提で動いています。件数の多さは「リリース前にこれだけ先回りできた」と読んでいただければと思います。
このように考えて、今回のゴールは次の3つに絞りました。
- 2リポジトリを develop ブランチの状態でフルスキャンする — 差分ではなく全体。今まで誰も「全部」を見たことがなかったからです。
- HIGH / MEDIUM の指摘すべてにパッチ案を作らせ、人間がレビューしてから適用する — 自動コミット・自動PRは禁止。そのかわり、パッチファイルをディスクに出させて、自分たちで
git applyする運用にしました。 - 見つかった「間違いのパターン」をルール化し、Claude Codeが次にコードを書くときに自動で守らせる — 一回きりの監査で終わらせないのが本当の目的です。
1.1 Claude Securityとは
Claude Security は、Claude Code上で動く「エージェントチーム型」のセキュリティ監査ツールです。要するに、AIが複数人のレビュアーチームとして動くイメージです。一方、従来のSAST(静的解析)との一番の違いは、1つのモデルにコードを読ませるのではなく、役割の違う複数のエージェントをパイプラインとして走らせる点にあります。マルチエージェント構成そのものは当ブログでも Autogen でマルチAIエージェントを動かした記事 で扱っていますが、それをセキュリティ監査に特化させたのが Claude Security です。
スキャンは5つのフェーズで進む
私の環境(v0.10.2.3)では、スキャンは次のフェーズで進みました。
- Inventory:まず、リポジトリをコンポーネントに分割し、すべてのトップレベルディレクトリを「走査する/除外する」に振り分ける
- Threat model:次に、コンポーネントごとに脅威モデルを作る
- Research:コンポーネント × 脆弱性カテゴリのマトリクスで、リサーチャーを1セルにつき1体ずつ投入する
- Sweep:マトリクスで拾いきれなかった隙間を埋めるパス
- Panel:最後に、候補1件につき独立した検証者3体が「本当に成立するか」を投票する。そのため、ここで落ちた候補はレポートに載らない
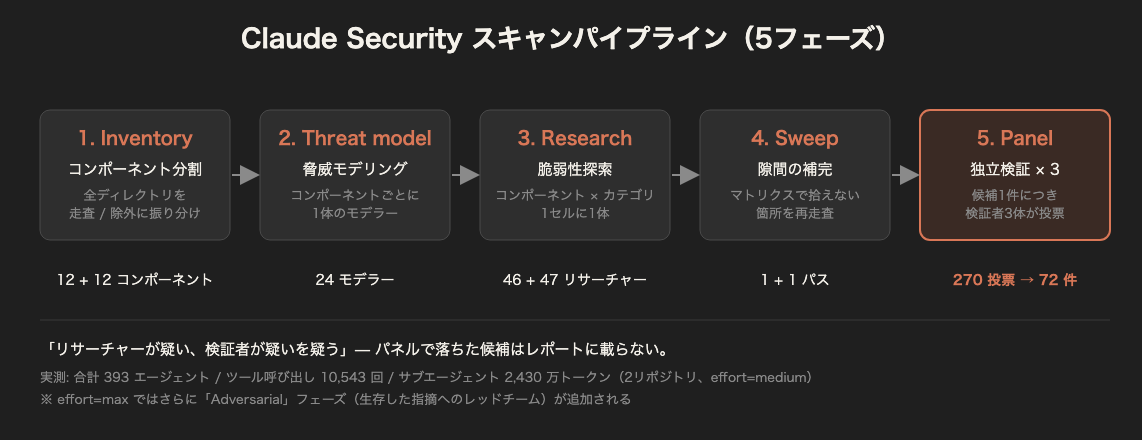
「リサーチャーが疑い、検証者が疑いを疑う」という構造です。そのため、誤検知(false positive)で人間の集中力を消費させない設計になっています。実際、これは後述する結果で体感できました。
2. 開発環境とプロジェクトの規模
2.1 実行環境
| 項目 | 内容 |
|---|---|
| マシン | MacBook(Apple M5 / 32 GB RAM) |
| OS | macOS 26.5.2 |
| Claude Code | v2.1.251 |
| claude-security プラグイン | v0.10.2.3(claude-plugins-official) |
| security-guidance プラグイン | v2.0.7(claude-plugins-official) |
| Node.js | v22.23.2 |
| Python | 3.9.6(システム)/ 3.14(Homebrew、レポート生成用) |
| uv / Docker | uv 0.12.0 / Docker 29.6.1(パッチ検証用のスクラッチ環境に使用) |
| 契約プラン | Claude Max 20x($200/月。トークン従量課金ではない) |
2.2 対象プロジェクトの規模
スキャン対象は2リポジトリです。ただし、node_modules・.venv・生成物・他ブランチのworktreeを除いた、ファーストパーティのコードだけを数えました。
| リポジトリA | リポジトリB | |
|---|---|---|
| Python ファイル数 | 589 | 424 |
| TypeScript / TSX ファイル数 | 394 | 264 |
| Python 行数 | 約100,600行 | 約86,900行 |
| TS/TSX 行数 | 約63,200行 | 約39,100行 |
| バックエンド | FastAPI + SQLAlchemy(async) × 4サービス | FastAPI + SQLAlchemy(async) × 2サービス(HTTP + WebSocket) |
| フロントエンド | Next.js(利用者向け + 管理画面) | Next.js(利用者向け + 管理画面) |
| インフラ | AWS CDK (TypeScript) | AWS CDK (TypeScript) |
| スキャン時に認識されたコンポーネント数 | 12 | 12 |
合計で 約1,670ファイル・約29万行。個人開発のサイズではなく、「小規模な業務系Webサービス」といったところです。
3. Claude Security Pluginのセットアップ手順
3.1 プラグインのインストール
とはいえ、セットアップ自体は拍子抜けするほど簡単で、Claude Code内でプラグインを2つ入れるだけです。
# Claude Code を起動して、プラグインをインストール
/plugin install claude-security@claude-plugins-official
/plugin install security-guidance@claude-plugins-official

# 対象リポジトリのルートでセッションを開き、スキャンのメニューを呼び出す
/claude-security
例えば、/claude-security を実行すると、「Scan codebase / Scan changes / Suggest patches」の3択メニューが出て、対話形式でスコープと effort(low / medium / high / max)を決めていきます。
3.2 無人実行のためのプロンプト
ただし、今回は「2リポジトリを順番に、無人で回したい」という要件があったので、メニューを使わずに最初のプロンプトに条件をすべて書き込んで投げました。具体的には、実際に投げたプロンプトの要点(内部パスは省略)は以下のとおりです。
プロジェクトの2リポジトリを全体スキャンして。effort は medium、逐次実行。

  1. <repo-A のパス>
  2. <repo-B のパス>

時間もトークンも大量に消費することは理解している。確認は不要、
送信後は離席する。

準備:
- 両リポジトリで develop をチェックアウトしてからスキャン
- ローカルの develop が origin より古い場合はレポートに明記(fetch はしない)
- 実際にスキャンしたコミットハッシュを記録
- 今回のセッションIDを記録(後でトークン集計に使う)

順序:
- A を完全に終えて(レポートをディスクに書いてから)B に進む
- 2リポジトリを並列に走らせない

両方終わったら:
- HIGH / MEDIUM の全指摘についてパッチファイルを提案。
  コミット・push・PR作成はしない
- 各指摘に「具体的な攻撃経路」「成立条件」「サービスへの実影響」を書く

トークンと費用:
- 用意済みの集計スクリプトを実行し、出力をそのまま報告に含める
- 費用は API 定価での「参考換算値」であり請求額ではない、と必ず明記
ポイントは「時間とトークンを消費することを理解している」と明示している点です。なぜなら、Claude Securityはスキャン開始前に必ずコスト確認を挟む設計だからです。依頼文でそれを了承しておくと確認をスキップして、無人でも止まらずに走ってくれます。
例えば、このプロンプトは内部的に次のようなワークフロー呼び出しへ変換されていました(ログから抜粋)。
{
  "scanRoot": "<repo-A のパス>",
  "runDir":   "<セッションのスクラッチ領域>/secscan/repo-a",
  "mode":     "full",
  "effort":   "medium",
  "scope":    "Entire repository at branch develop, commit <sha>. EXCLUDE the untracked .worktrees/ directory entirely."
}
プラグインの仕組み全般は Claude Code 公式ドキュメント(Plugins) に、security-guidance の仕組みは 公式ドキュメント(セキュリティガイダンス・日本語) に、導入手順の実例は Zennの Claude Code security-guidance 入門記事 がとても分かりやすいです。さらに詳しく知りたい方は、あわせて参照してください。
4. AIセキュリティスキャンの実行結果(所要時間・トークン費用・検出数)
ここからが本題です。なお、すべてスキャン実行時のワークフロー結果ファイル(*-result.json)と、セッションのトランスクリプトから集計した実測値です。
4.1 所要時間とエージェント数
| リポジトリA | リポジトリB | |
|---|---|---|
| 実行日 | 2026-08-11 | |
| 開始〜終了(JST) | 10:20 → 12:19 | 12:20 → 14:03(中断) 14:03 → 15:50(再開) |
| 所要時間 | 約1時間59分 | 約3時間30分(中断込み) |
| 投入エージェント数 | 197 | 196 |
| リサーチャー数(計画値) | 46 | 47 |
| ツール呼び出し回数 | 5,545 | 4,998 |
| サブエージェントのトークン消費 | 13,107,826 | 11,201,085 |
ただし、リポジトリBは検証パネルの途中で Claude Max 20x のセッション上限に達して中断しました。その後、上限がリセットされてから再開しました。なお、最終的な数値は完走した再開後の run から取っています。Max 20x でも上限に当たったので、Max 5x では1リポジトリ分すら完走できない可能性が高いです。したがって、「無人で回すなら、セッション上限のリセット時刻を意識して開始する」というのが一つ目の学びです。
一方、リポジトリAでは検証者2体が「API Error: Connection lost mid-response」で落ちましたが、ワークフローが自動で再試行(retry 1/2)して復帰しました。エージェントのクラッシュは致命傷ではなく、スキャン全体の失敗にはならない——リトライで済む、という設計は安心感がありました。
4.2 候補 → 検証 → 報告のファネル
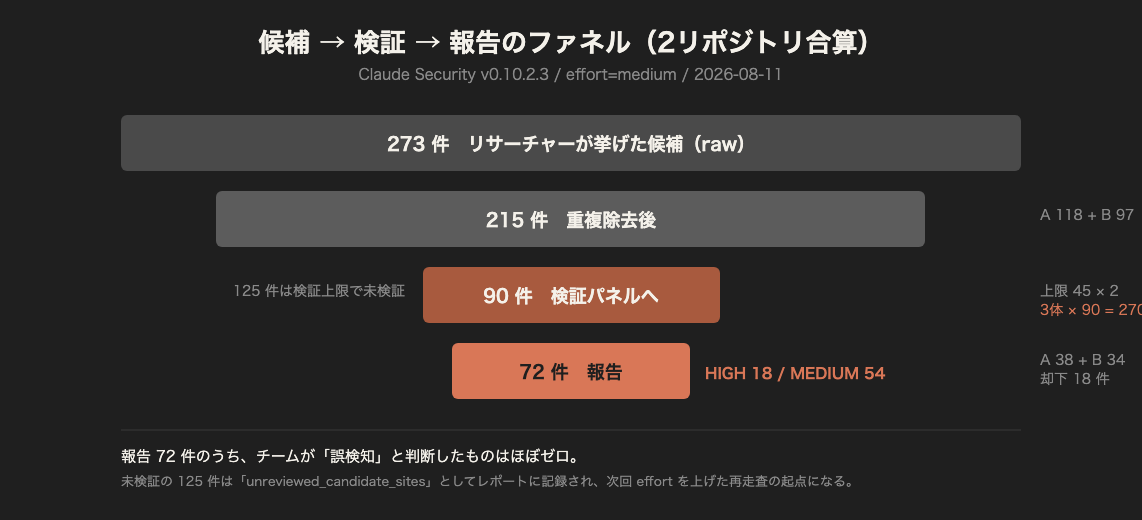
実際、「誤検知でレビュアーの時間を溶かさない」という設計思想が、数字にそのまま出ています。
| リポジトリA | リポジトリB | |
|---|---|---|
| リサーチャーが挙げた候補(raw) | 150 | 123 |
| 重複除去後 | 118 | 97 |
| 検証パネルに回った候補 | 45 | 45 |
| 検証者の投票数(3体 × 候補) | 135 | 135 |
| 検証を通過して報告された件数 | 38 | 34 |
| 検証上限により未検証(未報告) | 73 | 52 |
ただし、注意点があります。effort=medium では検証パネルに回る候補数に上限(45件)があります。そのため、優先度の低い候補(Aで73件、Bで52件)は検証されず、レポートにも載りません。ただし、その一覧は「未検証リスト」としてレポートに記録されるので、次回 effort を上げて再走査するときの起点になります。
4.3 検出された脆弱性の内訳(合計72件)
| 深刻度 | リポジトリA | リポジトリB | 合計 |
|---|---|---|---|
| HIGH | 15 | 3 | 18 |
| MEDIUM | 23 | 31 | 54 |
| 計 | 38 | 34 | 72 |
カテゴリ別の傾向
カテゴリ別の詳細な内訳は伏せますが、傾向だけ共有します。最も多かったのはIDOR(組織間参照の不備)で、次いでDoS・情報漏えい・認証バイパス・XSS・プロンプトインジェクションと続きました。CWEで見ると、CWE-639(認可の不備)系が突出して多かった、という結果です。
開発初期のコードとしては、この件数は想定の範囲内でした。むしろ、「第三者監査で一気に72件指摘されて、リリース直前に全部直す」というシナリオを回避できたことの方が大きい、と受け止めています。
結果をどう受け止めたか
検出カテゴリの多くは OWASP Top 10:2021 を解説した過去記事 の A01(アクセス制御の不備)と A03(インジェクション)に対応します。正直に言うと、SQLインジェクションは0件でした。なぜなら、ORMを徹底していたからです。逆に、「ORMだから安全」と思っていた組織間の境界の見落としが最多カテゴリになったのが、最大の反省点です。
4.4 トークン消費と費用(参考換算値)
次に、セッション全体(スキャン2本 + 第1ラウンドのパッチ生成・検証を含む約7時間40分)のトランスクリプトを、用意していた集計スクリプトで合算した結果です。具体的には、メインのトランスクリプト1本+サブエージェント745本が対象です。
| モデル | 呼び出し回数 | 入力 | 出力 | キャッシュ書込 | キャッシュ読取 | 合計トークン |
|---|---|---|---|---|---|---|
| Claude Opus 5 | 29,158 | 1.32M | 10.20M | 108.9M | 1,498.9M | 1,619.3M |
| Claude Sonnet 5 | 708 | 0.01M | 0.18M | 2.9M | 29.3M | 32.4M |
| 合計 | 29,866 | 1.33M | 10.38M | 111.8M | 1,528.2M | 約16.5億 |
これをAPI定価に換算すると 約 $1,715 USD(うちキャッシュ読取が $755、出力が $257、キャッシュ書込が $697)。
これは請求額ではない
ただし、これは請求額ではありません。 なぜなら、私たちはClaude Max 20xプラン($200/月)で、トークン従量課金ではないからです。実際の追加費用は0円です。「もしAPI従量課金で同じことをやったら」の参考値として載せています。
トークンの92.5%はキャッシュ読取
注目すべきは 全トークンの92.5%がキャッシュ読取だという点です。多数のエージェントが同じコードベースのコンテキストを共有するため、プロンプトキャッシュが極めて効くのです。従量課金の場合、キャッシュ読取は通常入力の1/10の単価なので、「16.5億トークン」という字面ほどには高くなりません。
一方、スキャンだけに絞ると、サブエージェント消費は A: 13.1M + B: 11.2M = 約2,430万トークン、合計の1.5%程度です。費用の大半は、スキャンではなくその後のパッチ生成・検証ラウンドで発生しています——これは次の章の内容と直結します。
5. Claude Code が検出した脆弱性の修正フロー
まず、72件を33のパッチグループにまとめ、Claude Security の「Suggest patches」ジョブでパッチを生成しました。そして、各パッチは次のループを通ります。
- 生成:まず、スクラッチ用のクローンで Patch Generator が修正を実装する。本体の作業ツリーには触れない。
- 検証:次に、Patch Verifier が「脆弱性が本当に消えたか」「修正が指摘の範囲に留まっているか」「新しい弱点や挙動変更を持ち込んでいないか」の3点を審査する。もし3点すべてに自信を持てなければ、そのパッチはファイルとして書き出されない。
ここまでが AI 側の自己検証です。そのうえで、さらに2段階あります。
- 敵対的再チェック:通過した差分だけを新しいリサーチャーに渡し、「この変更で攻撃者に新しくできることはあるか」を問う。
- 人間のレビュー:最後に、出力はディスク上の
.patchファイルとして受け取る。そして、冒頭に書いたとおり、検出された指摘は第三者監査までにすべて対応する計画です。ただし、コミット・push・PR作成はプラグインが一切行わず、自分たちでgit applyして PR を作る。
5.1 却下されたパッチ9本から学んだこと
数字の決め方の落とし穴
一番の学びは「AIが脆弱性を塞ぐこと」ではなく、「AIの検証者が、AIの書いたパッチを却下した理由」でした。これは人間のセキュリティ修正PRでもそのまま起きる話です。
- 閾値を「感覚」で決めた — サイズ上限を置いたパッチが、上限よりはるかに小さい入力でまだメモリを使い切った。増幅率は入力の「サイズ」ではなく「形」で決まる。攻撃を作って、ピーク使用量を測ってから数字を選ぶ。
- 新しい制限が正規ユーザーを弾く — 製品が公開している上限より厳しい制限を入れたパッチは、正当な操作を拒否した。仕様を読んでから数字を決める。
コードとテストの落とし穴
- ガードのテストに陰性対照がない — メモリ不変条件のテストが、脆弱なコードに対しても通っていた。セキュリティ性質を証明するテストは、未修正コードで落ちることを示す。
- エスケープが偽造可能 — プロンプトの区切りマーカーの各文字に、Unicode 正規化で一致する別のコードポイントが十数個ある。正規化してからエスケープする。
副作用と範囲の落とし穴
- サニタイザが日本語やコードを壊す — 不可視文字を一律削除したら、その結果、日本語の固有名詞や
std::vector<int>のようなコードが壊れた。この一行は本当に防御に効いているか?を、外して再テストして確認する。 - スコープ外の変更を同梱 — 認証連携のパッチに無関係なタイムアウト変更が混ざっていた。修正は指摘の範囲に留める。
git apply が通っても正しいとは限らない
もうひとつ、忘れられない教訓が「git apply が通っても正しいとは限らない」です。例えば、スキャン後に develop が20コミット以上進んでおり、あるパッチはきれいに当たるのに実行時に落ちました。なぜなら、呼び出し側が変わっていたからです。したがって、リベース後は必ずテストを回す——当たり前ですが、AIが出したパッチだと油断しがちでした。
6. CLAUDE.md と security-guidance による再発防止策の自動化
ここが今回一番やりたかったことです。監査結果を「レポート」で終わらせず、Claude Codeが次にコードを書くときに自動で読むルールに変換しました。
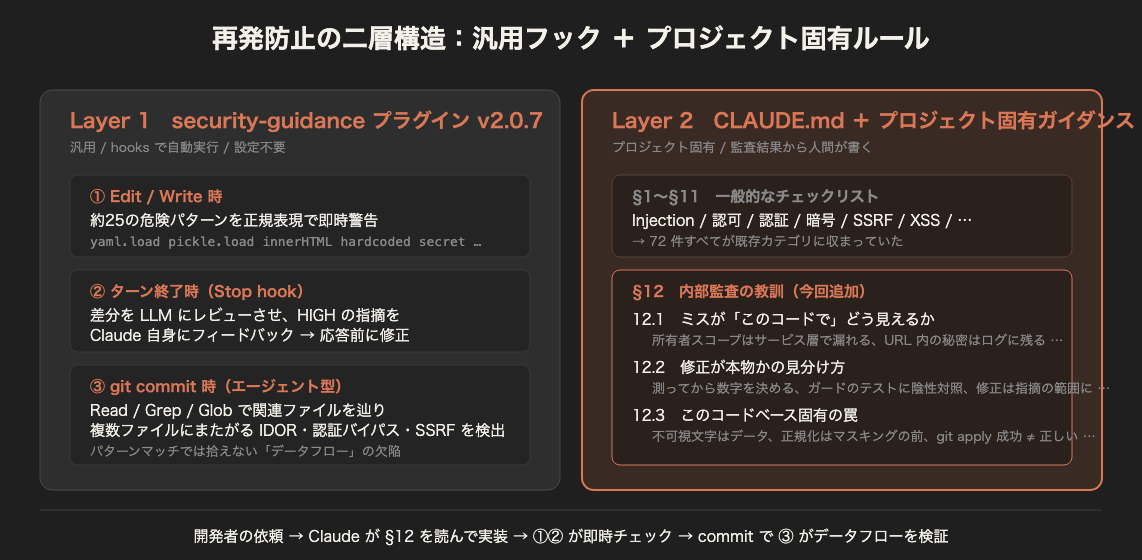
6.1 二層構造:security-guidance(汎用)+ CLAUDE.md(プロジェクト固有)
Layer 1:security-guidance プラグイン
- security-guidance プラグイン(v2.0.7):hooks で動く汎用レイヤーです。
具体的には、次の3段階で動きます。
Edit/Writeのたびに、約25の危険パターン(yaml.load、innerHTML、ハードコードされたシークレット等)を即時警告する。- ターン終了時には、差分をLLMでレビューし、HIGHの指摘をClaude自身に戻す。そのため、応答前に修正が入る。
git commit時には、関連ファイルを辿るエージェント型レビューが走る。その結果、IDORのような複数ファイルにまたがる脆弱性まで見つかる。
Layer 2:プロジェクト固有のガイダンス
.claude/claude-security-guidance.md:一方、こちらはプロジェクト固有のレイヤーです。各リポジトリの.claude/配下に置き、CLAUDE.mdから参照します。そして、今回のスキャン結果をもとに、汎用ルールでは書けない「このコードベースではミスがどう見えるか」を書きました。
6.2 実際に追加したルール(抜粋)
ガイダンスファイルは12セクション構成です。具体的には、§1〜§11 はインジェクション、アクセス制御、認証、暗号、SSRF、ファイル処理、XSS/CSRF、データ整合性、LLM固有リスク、ログ、レート制限——というよくあるチェックリストで、正直なところ、このレベルは監査前から書けていました。
しかし、72件すべてが既存のカテゴリに収まっていたのです。足りなかったのは「話題」ではなく、「ミスが実際にどう見えるか」と「修正が本物かどうかの見分け方」でした。そこで、それを §12 として追加しました。以下は実際のファイルから、内部名を汎用化した抜粋です。特に、§12.2 の「修正が本物かどうか」は人間のレビューにもそのまま使えます。
# Security guidance for <service>

(§1〜§11: 一般的なチェックリスト。略)

## 12. Lessons from the 2026-08-11 internal audit

72 findings survived independent verification across both repos. Every one
falls under a category already listed above — the checklist was not missing
a topic. What it was missing is **what the mistake actually looks like here**,
and **how to tell a fix is real**. The audit's own patch review rejected 9
fixes that closed the vulnerability but broke production or introduced a new
one; the sub-sections below are drawn from those rejections.

### 12.1 The shapes these defects actually took

- **Ownership scoping is missed in the service layer, not the route.** Every
  cross-organization finding had a correct role check at the route and a
  `select(Model).where(Model.id == x)` in the service with no ownership
  predicate. Reviewing the route's decorator tells you nothing. Follow the
  call into the query.
- **A credential in a URL path is a credential in your logs.** Scrubbing the
  app logger alone is not enough — the ASGI server's own access/error loggers
  and any traceback that embeds the URL still carry it. Prefer not putting the secret
  in the path at all.
- **A credential persisted in a record staff can read is a leak even if the
  transport was safe.** Ask, for every new secret: where does it come to
  rest, and who can read that?
- **A client-declared Content-Type used as the stored/served type is stored
  XSS.** Derive the served type server-side from the extension, and allow a
  magic-byte override only into a fixed set of non-scriptable types.
- **A size cap after `await file.read()` is not a cap.** The body is already
  resident. Bound the read itself.
- **A ZIP header's declared size is attacker input.** Count the bytes the
  decompressor actually produces, chunk by chunk.
- **A floating `@latest` from a CDN is remote code execution on a delay.**
  Pin, or self-host from the integrity-checked `node_modules` copy when the
  loader exposes no SRI option.

### 12.2 How to tell a fix is real

- **Measure, don't pick a number.** Build the attack, measure peak RSS, then
  choose the limit.
- **A new limit must be checked against what the product can actually
  produce.** Read the form before choosing the number.
- **Every guard test needs a negative control.** Run it against the unpatched
  code and show it failing.
- **A guard must read the data exactly as the consumer does.** A byte-level
  check of a manifest and an XML-parsed read of the same manifest can be
  split by a character reference.
- **Redact by exact value, not by pattern.** Pass the actual minted token
  down and replace that string — attacker input never reaches the redaction
  list.
- **Ask whether each defensive line is load-bearing.** Remove it, re-run the
  forgery matrix, and keep it only if something breaks.
- **Keep the fix to the finding.** Out-of-scope hardening belongs in its own PR.

### 12.3 Traps specific to this codebase

- **Some Unicode whitespace is data, not noise to discard.** Map `Zs`/`Cc`
  to a space; never delete them.
- **Normalization order versus masking.** Normalize first, mask second —
  otherwise text in a non-canonical form reaches the provider unmasked.
- **`git apply` succeeding says nothing about correctness.** After any
  rebase, re-run the tests rather than trusting the merge.
6.3 CLAUDE.md からの参照とプラグイン有効化
具体的には、各リポジトリの .claude/settings.json でプラグインを有効化し、CLAUDE.md からガイダンスファイルを参照させています。
{
  "enabledPlugins": {
    "security-guidance@claude-plugins-official": true
  }
}
# CLAUDE.md(抜粋)

## Security
すべての変更は `.claude/claude-security-guidance.md` のチェックリストに
対してレビューすること。インジェクションだけでなく §1〜§12 を通して見る。
特に §12(内部監査の教訓)は、このコードベースで実際に起きた形をまとめている。
例えば、この仕組みにすると、次に開発者がClaude Codeで「一覧取得のAPIを追加して」と頼んだとき、Claudeは §12.1 の「所有者スコープはサービス層で漏れる」を読んだ上でコードを書き、さらに、commit 時には security-guidance のエージェントレビューがクエリまで辿ってチェックしてくれます。要するに、監査で見つけたパターンを、AIの手癖として定着させるのが狙いです。
7. まとめ
7.1 数字で振り返る
今回の実測値を改めて整理します。まず、規模と検出結果からです。
- 規模:2リポジトリ、約1,670ファイル・約29万行(Python + TypeScript)
- 所要時間:リポジトリA 約2時間、リポジトリB 約3.5時間(セッション上限による中断込み)。設定は effort=medium
- プラン:Claude Max 20x。この規模を無人で回すなら 20x が前提で、Max 5x では途中で止まる可能性が高い
- エージェント:計393体、ツール呼び出し 約10,500回
- 検出:候補273件 → 検証通過 72件(HIGH 18 / MEDIUM 54)。SQLi は0、IDOR が最多
修正とコスト
- 修正:33パッチグループをPR化して順次マージ。9本は検証者に却下され、作り直した
- トークン:セッション全体で約16.5億トークン(92.5%はキャッシュ読取)
- 費用:API定価換算で約$1,715 USD(キャッシュ読取 $755 / キャッシュ書込 $697 / 出力 $257)。ただしMax 20xプランのため実請求は0円。スキャンのみに絞れば約2,430万トークン(全体の約1.5%)で、費用の大半はパッチ生成・検証ラウンド
7.2 使ってみての感想
結局のところ、使ってみての率直な感想は3つです。前提として、これはリリース前・開発初期の内部スキャンであり、本番リリース前には別途、第三者によるセキュリティ監査を受けて全指摘を修正する運用になっています。言い換えると、今回のスキャンは、その第三者監査を「手戻りの山」ではなく「最終確認」にするための先行投資という位置づけです。
- 検証パネルの価値が大きい。 273の候補が72に絞られました。しかも、72件のうち「これは誤検知だ」と私たちが判断したものはほぼありませんでした。レビュアーの集中力を守る設計は本物です。
次に、コストと運用面です。
- 本当に高くつくのはスキャンではなく修正。 トークンの98%以上はパッチの生成・検証ラウンドで消費されました。ただし、その過程で却下された9本のパッチは、人間がレビューしていたら見逃していた可能性が高いものばかりです。ここに払う価値はあると感じています。
- レポートを CLAUDE.md に変換するところまでが監査。 72件が既存カテゴリに全部収まっていた、という事実が示すとおり、足りないのはチェックリストではなく「自分たちのコードでのミスの形」の言語化でした。それをAIに読ませることで、次の開発サイクルから効き始めます。
7.3 参考リンクと次のステップ
Claude Securityは 公式ページ から利用でき、security-guidance は 公式ドキュメント(日本語) に詳しくまとまっています。また、導入の実例としては Zennの記事 も参考になります。
「専任のセキュリティ担当がいないチームが、開発初期の段階で全体スキャンを1日で回し、翌週から再発防止を自動化する」——このように、半年前なら考えられなかった運用が現実に手に入りました。ですので、同じ悩みを持つチームの参考になれば嬉しいです。
最後まで読んでいただき、ありがとうございました。
宣伝
最後に、次世代システム研究室では、最新のテクノロジーを調査・検証しながらインターネットのいろんなアプリケーションの開発を行うアーキテクトを募集しています。募集職種一覧 からご応募をお待ちしています。

グループ研究開発本部の最新情報をTwitterで配信中です。ぜひフォローください。
Follow @GMO_RD