2026.10.14
Contrastive Language Model(CLM)を使ってみた:System Oneモデルとの比較と追加学習の効果
こんにちは、グループ研究開発本部・AI研究開発室のA.Zです。
直近の数週間で、素早い意思決定に特化した「System 1モデル」が注目を集めています。なかでもTypeSafeが発表したJevをきっかけに、オープンソースの実装や異なるアーキテクチャのモデルが登場し、この分野の議論が活発になっています。
今回は、その一つであるContrastive Language Model(CLM)に焦点を当てます。仕組みを紹介したうえで、Jevと、Jevに似た形式の質問を扱える独立したオープンソース実装Layaと比較します。
CLM(Contrastive Language Model)について
CLMを理解するうえで重要なのは、文章を生成する問題を「今の状態に合う行動を、候補の中から選ぶ問題」に置き換えることです。状態(state)は判断に必要な文脈、行動(action)は次に取る選択肢を表します。例えばゲームでは画面と操作履歴が状態になり、「左へ進む」「ジャンプする」が行動候補です。金融ニュースの分類なら、記事本文を状態、「ポジティブ」「中立」「ネガティブ」を候補として考えられます。ただし、候補を選べることと、その判断が正しいことは別です。後半ではこの違いを実データで確認します。
図1は、学習から実行時の選択までを左から右へ示しています。まず左側では、過去の状態とそのとき実際に取られた行動を組にします。例えば、マリオが障害物の前にいる画面と「ジャンプする」という操作が一組です。状態と行動をそれぞれエンコーダでベクトルに変換し、バッチ内のすべての状態と行動の組み合わせについて類似度を計算します。図中の行列で濃い対角成分は正しい組、対角線以外は別の状態に対応する行動との組み合わせです。学習では、正しい組の類似度を上げ、それ以外との類似度を下げることで、状態に合う行動を見分けられるようにします。
次に中央では、実行時に比較する行動候補を文章として用意します。図の例なら「左へ進む」「ジャンプする」「右へ進む」です。これらは固定されたクラス番号ではなくテキストなので、学習時に使っていない行動でも候補に追加できます。右側では、新しいゲーム画面を状態エンコーダに、各候補文を行動エンコーダに通し、状態ベクトルと各行動ベクトルの類似度を比べます。図では「ジャンプする」のスコアが最も高いため、その行動を選びます。このように、そのゲームの正解例で追加学習せずに候補を選ぶ使い方が、ここでいうゼロショット行動分類です。
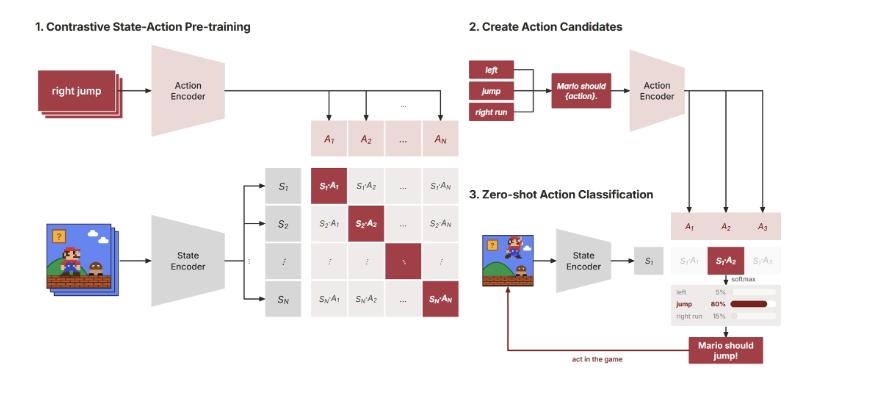
図1:状態・行動の対照学習から、候補を使ったゼロショット分類まで。図はCLM開発元の公開資料に基づきます。
アーキテクチャ:大きな言語モデルと二つの小さなヘッド
「状態エンコーダ」と「行動エンコーダ」と聞くと、大きな言語モデルを二つ丸ごと持つように見えます。しかし公開されたCLM-8Bでは、一つのQwen3-8Bを共通の基盤とし、その後に状態用と行動用で別々の射影ヘッドを置く構成です。状態文と行動候補文はそれぞれ独立にQwen3-8Bへ入力し、最終トークンから4096次元の表現を取り出してL2正規化します。状態文の表現は状態ヘッドへ、候補文の表現は行動ヘッドへ送ります。二つのヘッドは形こそ同じですが、重みは共有しません。
公開チェックポイントの各ヘッドは、4096次元の入力を「4096 → 1536 → 1536 → 512」と変換する小さな多層パーセプトロン(MLP)です。中間ではGELUによる非線形変換とLayerNormを使い、出力された512次元ベクトルを再びL2正規化します。状態と行動のベクトルの内積はコサイン類似度になり、これに学習済みの倍率を掛けて候補のスコアとします。学習で更新するのは主にこの二つのヘッドで、Qwen3-8Bの重みは固定されています。二つのヘッドの合計は約1,889万パラメータです。つまり、大きな言語モデルが文章の意味を表現し、小さなヘッドが「その状態にどの行動が合うか」を比較しやすい空間へ写します。
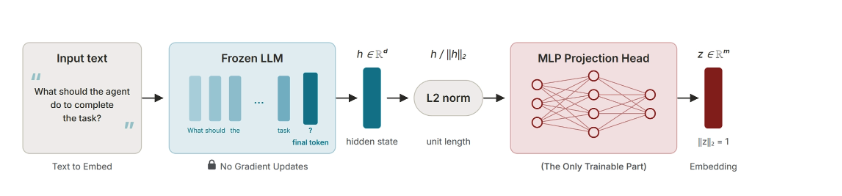
図2:一つのテキストをベクトルに変換する経路。状態と行動で同じ基盤モデルを使いますが、射影ヘッドは別々です。図はCLM開発元の公開資料に基づきます。
この分離には実用上の利点があります。候補文が同じなら、行動側のベクトルを一度計算してキャッシュできます。新しい状態が届くたびに状態側だけを計算し、候補との内積を取ればよいため、候補が多い、あるいは同じ候補を繰り返し使う場面に向きます。一方、状態と候補を一つの入力として同時に読んでいるわけではありません。否定や条件、数値の微妙な関係を十分に区別できるかは、学習内容とタスクで確かめる必要があります。これは構造上の特徴であり、個別の誤答の原因をそれだけで特定するものではありません。
学習データはどのように準備するのか
対照学習には、正しい状態・行動のペアが必要です。公開資料によると、CLMは次の三段階で、一般的な知識の対応づけから実際の行動選択へとデータを難しくしています。件数は開発元が公表した概数です。
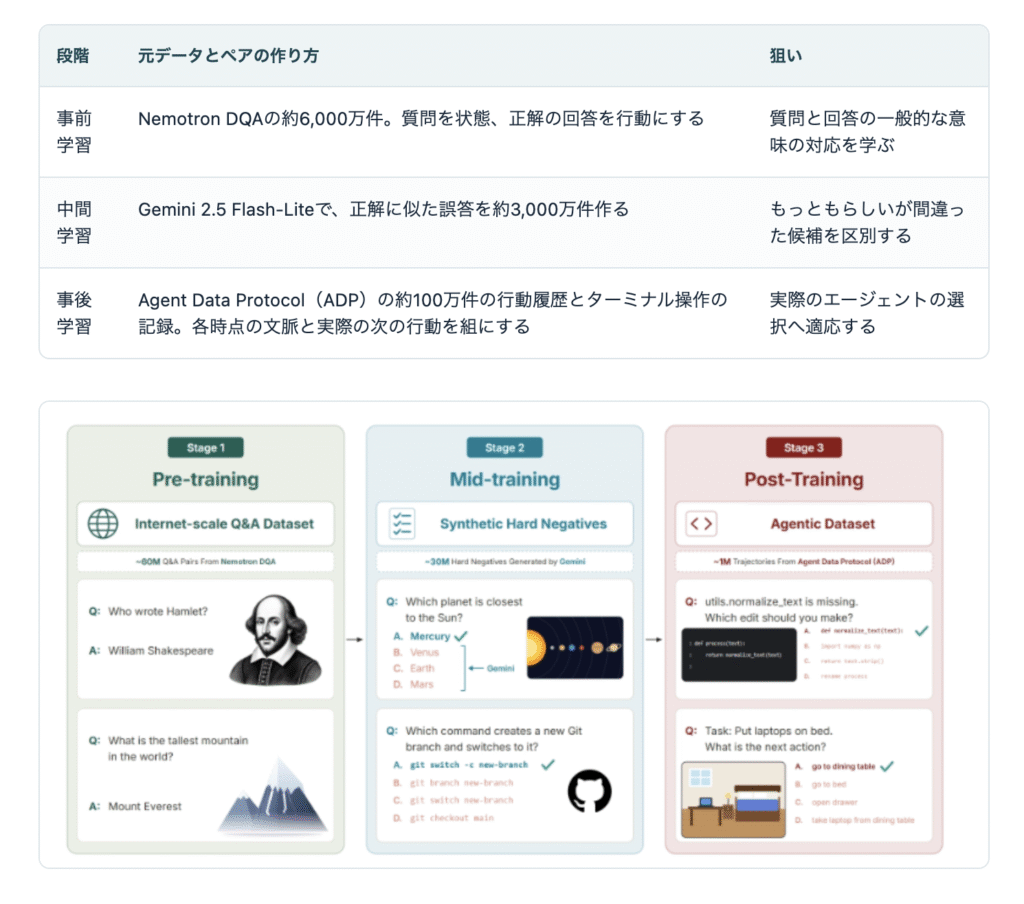
図3:CLM開発元が説明する三段階のデータ準備。中間学習の「難しい負例」は、単に無関係な誤答ではなく、正解と意味が近い誤答です
例えば、ある質問への正解とまったく無関係な回答なら、モデルは比較的容易に区別できます。しかし、数字が一つ違う、条件だけが逆、似た道具を選んでいる、といった誤答は難しくなります。CLMは一般的な質問回答で土台を作ってから、こうした難しい負例を追加します。事後学習では、一般的な質問回答を40%、エージェントの行動履歴を60%混ぜて再学習することで、元の識別能力が大きく崩れるのを抑えたと報告しています。
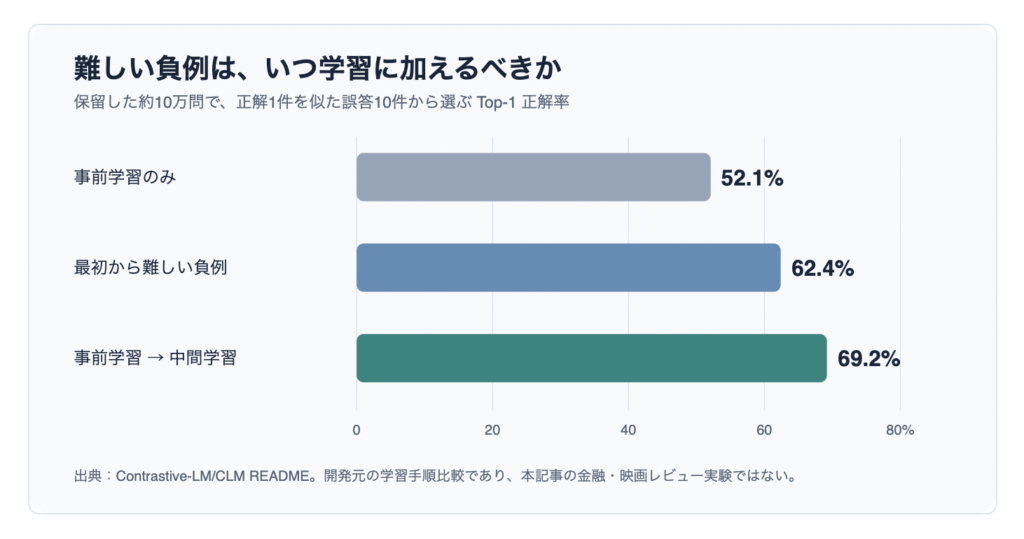
図 4 難しい負例の学習情報
学習アルゴリズム
バッチにB個の正しい状態・行動ペアがあるとします。各状態をすべての行動と比較すると、B行×B列のスコア行列ができます。例えば3組なら、1行目には「状態1と行動1・2・3」の三つのスコアが並び、正解は行動1です。同様に、2行目の正解は行動2、3行目の正解は行動3なので、正解は行列の対角線上に並びます。各行をsoftmaxで候補間の相対的な値に変え、正解の行動に割り当てた値が大きくなるように学習します。これが「状態から行動を探す」方向です。
CLMは行列を転置して、逆に「ある行動に対応する状態はどれか」も学習します。例えば行動1について状態1・2・3を比較し、状態1を正解として扱います。実装では、二つの射影ヘッドの出力を正規化して行列の各スコアを計算し、対角線上の組を正解ラベルとする交差エントロピー損失を元の行列と転置行列の両方に適用します。最後に二つの損失を平均したものが双方向InfoNCEです。こうすると正しい組のスコアを単独で上げるだけでなく、同じバッチにある紛らわしい組より高くするようにヘッドを学習できます。
ここでいうInfoNCEは、正しい組(正例)を、比較対象の組(負例)の中から識別するための損失関数です。下の式では、分子のexp(Sᵢᵢ)が正例のスコア、分母のΣⱼ exp(Sᵢⱼ)が同じ状態と組み合わせた全行動のスコアの合計です。分子を分母で割ると、正例がその候補集合の中でどれだけ優勢かが分かります。その値の対数にマイナスを付けるため、正例が選ばれやすいほど損失は小さくなります。逆方向の式では、状態と行動の役割を入れ替えて同じ計算をします。
例えば状態1に対する行動1・2・3のスコアが2、1、0なら、正例である行動1に割り当てられるsoftmaxの値は約0.67、損失は約0.41です。行動1のスコアだけが4に上がると、その値は約0.94、損失は約0.07に下がります。これらは同じバッチの候補間での相対値であり、実世界でその行動が正しい確率をそのまま表すものではありません。
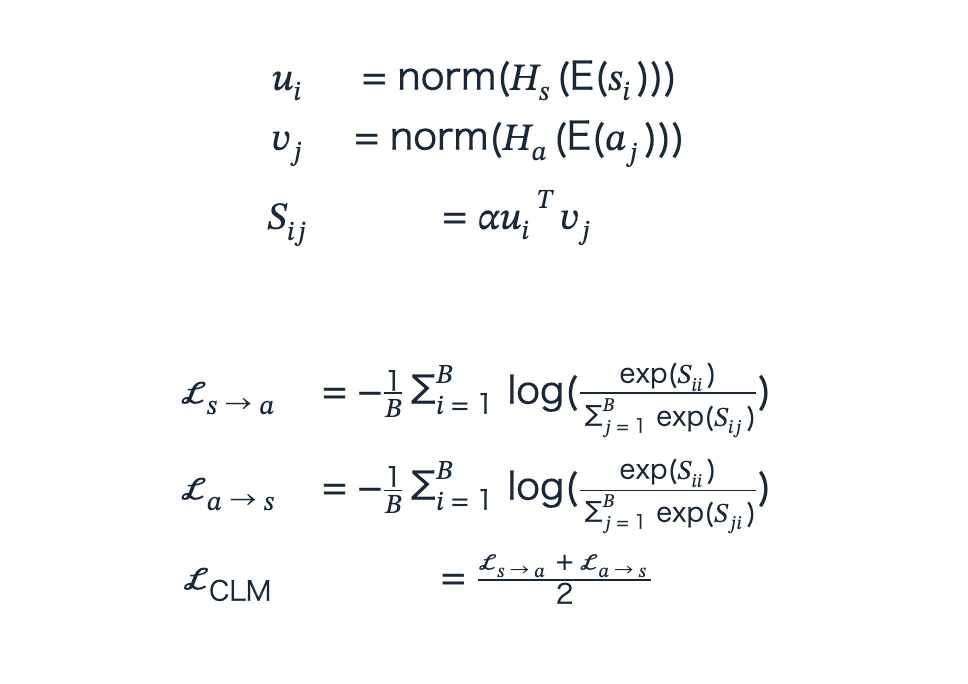
ここでEは状態と行動に共通の言語モデル、HsとHaはそれぞれ状態用・行動用の射影ヘッド、normはL2正規化、Bはバッチ内のペア数です。αは学習されたスコアの倍率です。正しい組のスコアを高くするだけでなく、同じバッチ内の他の組と相対的に区別する点が重要です。難しい負例を使う中間学習では、正解によく似た誤答も分母の比較対象に加えます。公開された追加学習コードでは、同じタスクの同じ時点に属する別の正解ペアを誤って負例として扱わないよう、該当する組をマスクします。
推論
推論時には、学習用の正解ペアは不要です。まず状態に質問文を加えて状態ベクトルを作り、候補ごとの説明文から行動ベクトルを作ります。金融ニュースなら、状態を「A社が通期売上高の見通しを上方修正した」という文、質問を「この発表は好材料か」、候補を「ポジティブ/中立/ネガティブ」とするイメージです。各候補には「ポジティブ」のようなキーと、「事業見通しの改善を示す」のような説明文を設定できます。モデルがベクトル化するのは説明文で、説明が空の場合に候補キーを使います。これは推論の説明用の例であり、この文への実測確率ではありません。
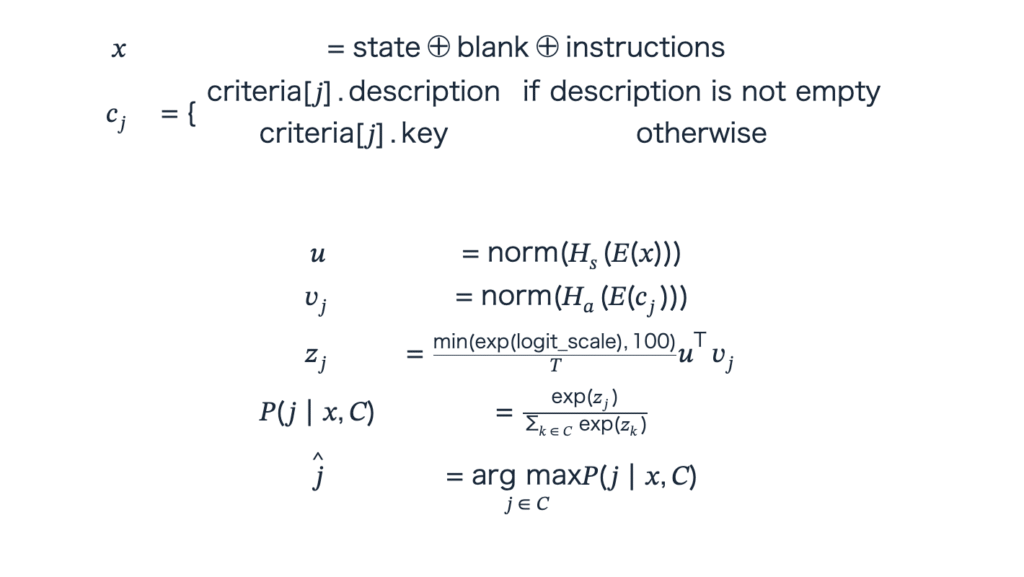
ここで⊕は文字列の連結、blankは状態と指示の間の空行、Cは候補集合です。Eは共通エンコーダ、HsとHaはそれぞれ状態用・行動用のヘッドを表します。二つのベクトルは正規化されているため、内積はコサイン類似度になります。式中のexp(logit_scale)は前節の倍率αに相当し、公開実装では最大100に制限されます。Tはsoftmaxに入れる前のスコアを調整する温度で、今回の実験では1に固定しました。最後に候補間のスコアをsoftmaxで相対的な分布に変え、最大の候補ĵを返します。
公開チェックポイントをその分類タスクのラベルで追加学習せずに使う場合を、ここでは「ゼロショット」と呼びます。新しく渡した候補を採点できますが、正解率や確率の校正は保証されません。例えば説明用にα=100、二候補のコサイン類似度が0.31と0.30なら、softmax後は約73%対27%になります。僅差でも倍率で確信度が高そうに見えるため、返った値をそのまま「正答する確率」と受け取るべきではありません。候補の数や説明文を変えれば分母も変わり、返る値も変化します。これらは、後で見る金融データの評価では特に重要です。
公開チェックポイントを用いた本記事のMacでの実験では、状態と候補の埋め込み生成にMLX上の4-bit Qwen3-8Bを使いました。入力の組み立て、射影ヘッドによる採点、回答の生成にはCLMの公開Engineを使っています。ただし、公開手順で使うbf16/vLLM構成と埋め込みが数値的に一致することは確認していません。金融ニュースで全件を中立と判定した結果は、このチェックポイント、候補文、実行環境における観測として読みます。
System Oneのモデルの比較
今回比較するのは、次の三つのモデルです。
- Jev(TypeSafe AI):状態と型付きの質問を受け取り、選択肢ごとの確率を返す商用サービス。
- Laya(オープンソース実装):Jevに似た質問形式を扱える、独立して開発されたモデル。TypeSafeがJevの重みを公開したものではありません。
- CLM(Contrastive Language Model):状態と候補を別々にベクトル化し、類似度から答えを選ぶ公開モデル。
JevとLayaの基本的な仕組みや使用例は、Jevの紹介記事とLayaの紹介記事でも説明されています。ここでは、CLMとの技術的な違いを比較します。
三つのモデルは、状態を読み、用意した選択肢から答えを返す点では似ています。違いは、候補をどう比較するかと、その仕組みを利用者がどこまで確認・変更できるかです。CLMは状態と候補を別々に符号化します。Layaは状態・質問・候補を一緒に読んで採点します。Jevは型付きの回答を返すサービスですが、内部のエンコーダや採点方法は公開されていません。
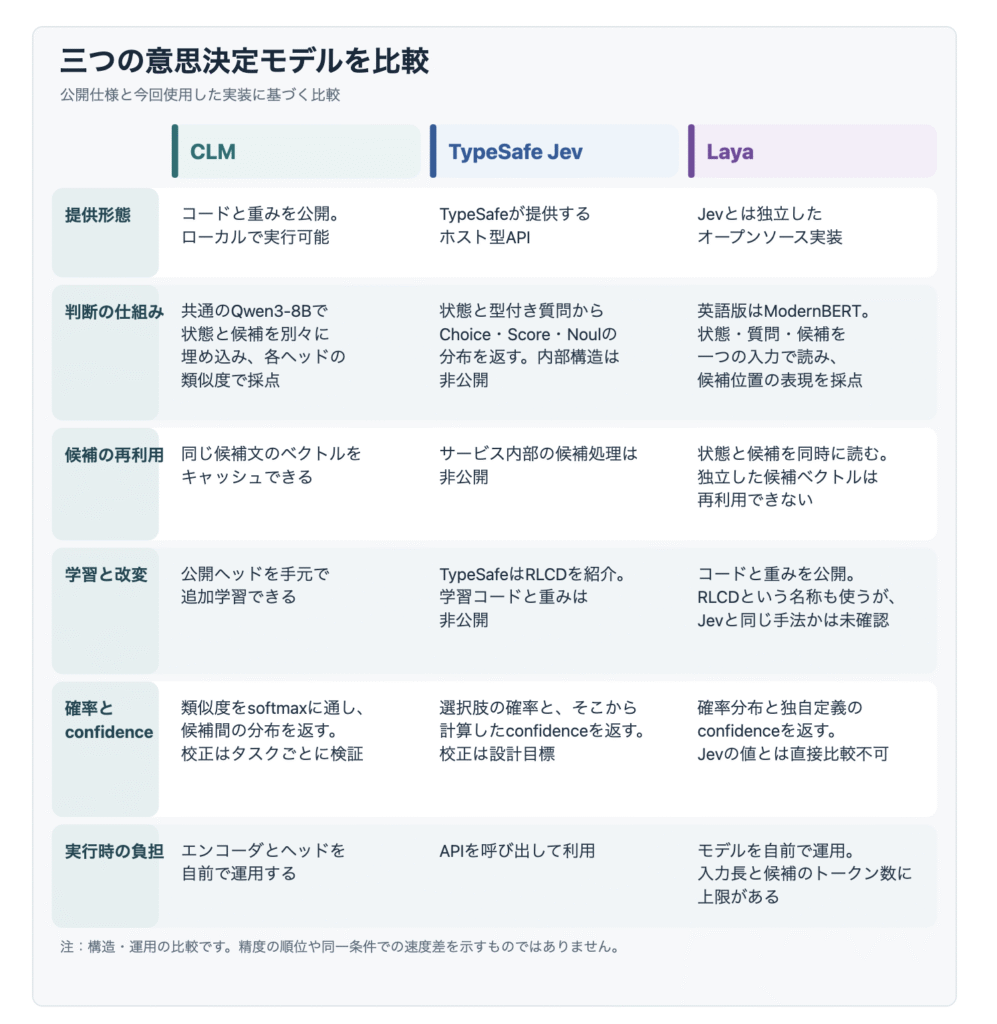
図 5 モデル比較:公開仕様と今回使用した実装に基づきます。
ここで「RLCD」という同じ名称だけを根拠に、JevとLayaの学習内容まで同一とは扱いません。また、Jevの内部が非公開だからといって、対照学習を使っていないとも断定できません。
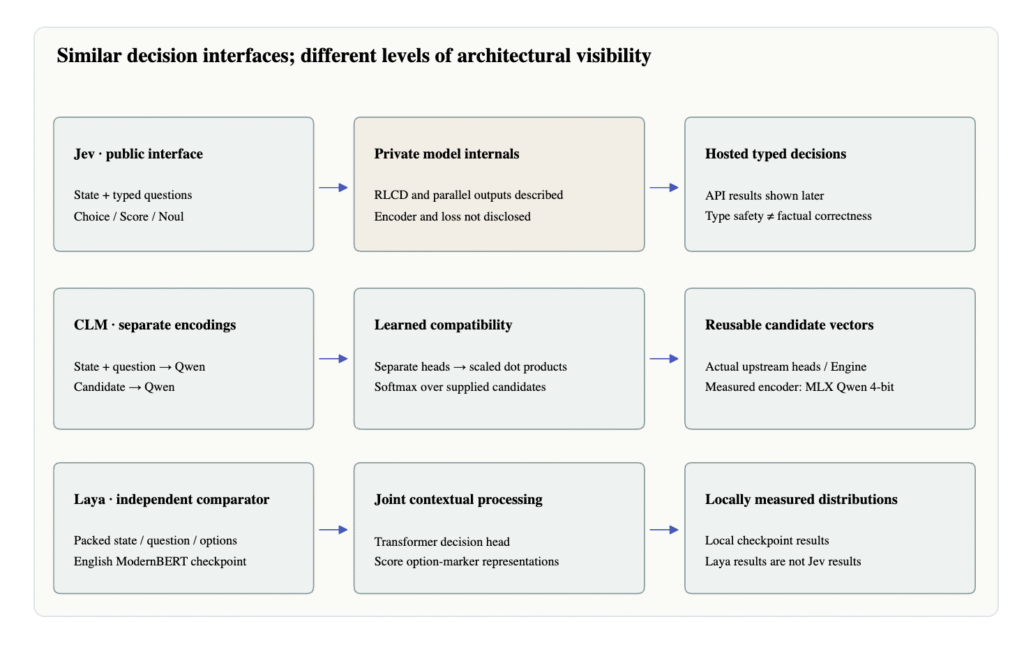
図6:三つのモデルで公開されている処理の範囲。Jevの欄はAPIから見える入出力を示し、非公開の内部構造を推測して描いてはいません。LayaはJevの公開版ではなく、独立した比較対象です。
候補を繰り返し使う場面では、CLMの候補ベクトルをキャッシュできる設計が利点になり得ます。一方、Layaは状態と候補を同時に読めます。ただし、これだけで回答の正しさや実際の応答時間は決まりません。CLM開発元はコンピューター操作・ゲーム・ツール選択でJevと同程度の性能、最大9倍の速度を報告していますが、本記事のMac上のCLMと外部APIのJevでその速度差を追試したわけではありません。後の実験では、同じ正解付き入力への回答を比べます。
ここで比べるChoice回答のconfidenceは、同じ名前でも計算方法が異なります。候補数をK、最大の選択確率をpmaxとすると、TypeSafeは(pmax − 1/K) / (1 − 1/K)を返します。均等に分かれた場合を0、一つの候補に確率が集中した場合を1とする値で、最大確率以外の内訳は見ません。一方、Layaのconfidenceは確率分布全体のエントロピーH(p) = −Σi pi log piを使い、1 − H(p) / log Kで計算します。最大確率が同じでも、残りの候補への配分が違えばLayaの値は変わります。Layaは最大確率を基にした別のanswer_confidenceも返しますが、これもTypeSafeのconfidenceと同じ定義ではありません。したがって以下ではconfidenceを横並びにせず、各選択肢に返された確率と正解ラベルから評価します。
実験と評価
目的
CLMは、現在の状態に合う候補を選ぶモデルです。ここでは、その仕組みを金融ニュースの感情分類に使ったとき、商用のJevや公開モデルのLayaとどの程度違うかを調べます。金融ニュースだけでは結果がその分野特有のものか分からないため、同じ感情分類を映画レビューでも試します。どちらも人手の正解ラベルがあるデータです。
最初に比較するのは、追加学習していないCLMとLayaの公開チェックポイント、およびTypeSafeのJevです。問いは「どのモデルが何件正解したか」だけではありません。少数クラスを拾えるか、間違えたときに高い確率を付けていないかも見ます。その後、別タスクのFLSデータでCLMとLayaを追加学習し、公開モデルからどの程度変わるかを調べます。FLSではJevを実行していないため、追加学習後の結果をJevとの直接比較には使いません。どちらも株価の上昇や売買益を予測する実験ではありません。 CLM開発元が報告したコンピューター操作・ゲーム・ツール選択での性能や速度差も、このデータからは検証できません。
評価データ
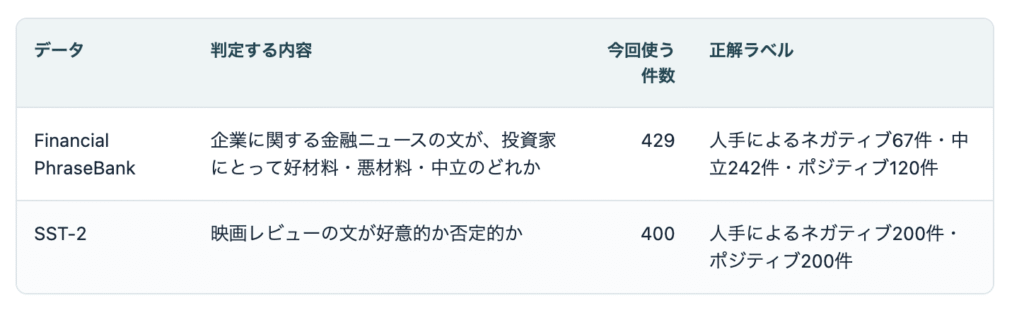
Financial PhraseBankは、金融ニュースを投資家の視点から3クラスに分類したデータです。元データには公式のtrain/test分割がないため、今回は注釈者が全員一致した文を使い、重複やよく似た文をまとめてから作成済みのテスト分割429件を採用しました。中立が242件と半数を超えるので、全件を中立と答えるだけでも正解率は56.4%になります。モデルの値を読む際には、この対照が欠かせません。
- ホームページ(配布ページ):https://huggingface.co/datasets/takala/financial_phrasebank
- データURL(今回取得した固定版ZIP):https://huggingface.co/datasets/takala/financial_phrasebank/resolve/8d3fe0c36d5feec6b3cc5e455b0fcb4820fb9964/data/FinancialPhraseBank-v1.0.zip
SST-2は、映画レビューから作られた2クラスの感情データです。公開されているラベル付きvalidation分割872件から、文のSHA-256順で各クラス200件ずつ選びました。したがって、ここでの400件は公式testセットのスコアではありません。金融と無関係な文でもCLMが候補を区別できるかを見る対照ですが、PhraseBankとはクラス数もラベルの意味も違います。
- ホームページ(Stanford Sentiment Treebank):https://nlp.stanford.edu/sentiment/
- データセットの配布ページ:https://huggingface.co/datasets/stanfordnlp/sst2
- データURL(今回取得した固定版validation):https://huggingface.co/datasets/stanfordnlp/sst2/resolve/8d51e7e4887a4caaa95b3fbebbf53c0490b58bbb/data/validation-00000-of-00001.parquet
実行手順
- 正解ラベルをモデルへのリクエストから分離し、829件の本文・質問・候補文を先に固定しました。金融ニュースでは「この文は企業にとってネガティブ・中立・ポジティブのどれか」、映画レビューでは「作品への評価はネガティブかポジティブか」を尋ねます。将来の株価を予想させる質問はしていません。
- 同じ829件をCLMの元モデル、Layaの元モデル、Jev 1.13.0へ送りました。各モデル829回答、計2,487回答をこの主比較に使います。Jevは版を固定したAPIを呼び、CLMは公開EngineとMac上の4-bit Qwen3-8B、Layaは公開された英語版チェックポイントを使用しました。CLMのエンコーダは開発元のbf16/vLLM構成と数値的に同一とは確認していません。
- 各回答の選択肢ごとの確率を保存した後、分離していた正解ラベルと突き合わせました。この二つのデータで追加学習、温度調整、閾値探索、候補文の変更はしていません。Jevの丸められた確率が合計1からわずかにずれる場合だけ正規化し、確率の再校正は行っていません。
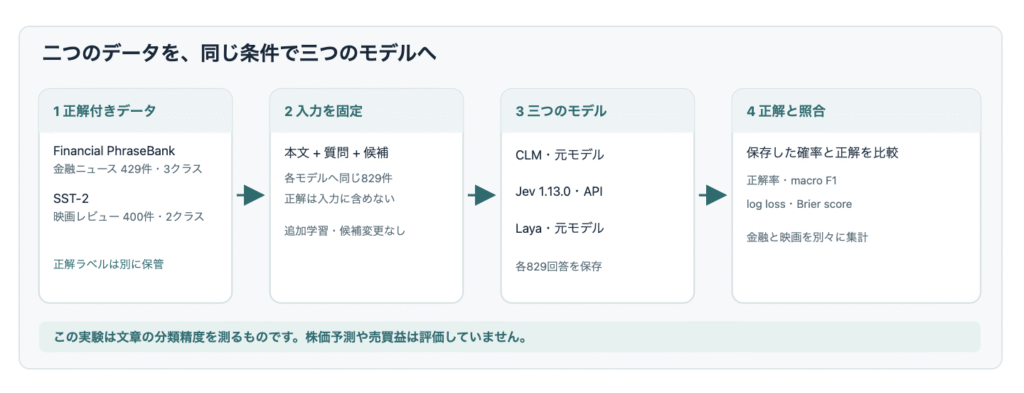
図7:同じ入力を3モデルに送り、正解は回答を保存した後にだけ使います。結果はデータごとに集計します。
評価指標
正解率は全件のうち正解した割合です。ただし、PhraseBankでは「常に中立」でも56.4%になるので、これだけでは他の二クラスを読めたか分かりません。そこでmacro F1も使います。まず各クラスについて、そう予測した文のうち正しい割合(適合率)と、そのクラスの文を拾えた割合(再現率)からF1を計算し、最後にクラス間で単純平均します。中立だけを当ててネガティブ・ポジティブを見逃すと、残る二クラスのF1が0になり、macro F1は大きく下がります。
確率の質は、正解ラベルに低い確率を付けるほど悪化するlog lossと、全候補の確率が正解の分布からどれだけずれたかを見るBrier scoreで測ります。いずれも小さいほど良い値です。例えば正解クラスに90%を付けたときのlog lossは約0.11ですが、10%しか付けなければ約2.30になります。正解率では勝っていても、誤答時に極端な確率を付ければlog lossでは負けることがあります。
比較の基準:source-training majority
表の「訓練分割の多数派」は、英語の実験記録でsource-training majorityと呼んでいる単純な対照です。評価する429件や400件の正解を見て答えを決めるのではなく、元データの訓練分割で最も多いクラスを先に一つ選び、評価対象の全文にそのクラスを返します。文の内容は読みません。したがって、これを上回らなければ、正解率の高さが文の理解によるものか、クラスの偏りに乗っただけなのかを区別できません。
PhraseBankの訓練分割は中立724件、ポジティブ260件、ネガティブ154件なので、対照は常に「中立」です。今回の評価429件には中立が242件あり、正解率は242/429=56.4%、macro F1は0.240になります。SST-2の訓練分割はポジティブ37,569件、ネガティブ29,780件なので、対照は常に「ポジティブ」です。ただし今回の評価400件は各クラス200件ずつに揃えたため、正解率は200/400=50.0%、macro F1は0.333です。つまり、SST-2の50.0%は訓練分割が均等だったという意味ではありません。
この対照はクラスを固定して返すため、表では正解率とmacro F1だけを示します。評価コードには便宜的に選択クラスを確率1、他を0と置いたlog lossとBrier scoreも記録されていますが、確率を推定するモデルの出力と同列には扱いません。
モデル間の正解率差には、同じ事例を対応づけて2,000回再標本化した95%区間を示します。これは固定した事例集合で差がどの程度揺れるかを見る記述的な区間で、未知の金融ニュース全体への性能保証ではありません。金融ニュースは3クラス、映画レビューは2クラスなので、指標を二つのデータで合算して総合順位にはしません。
結果
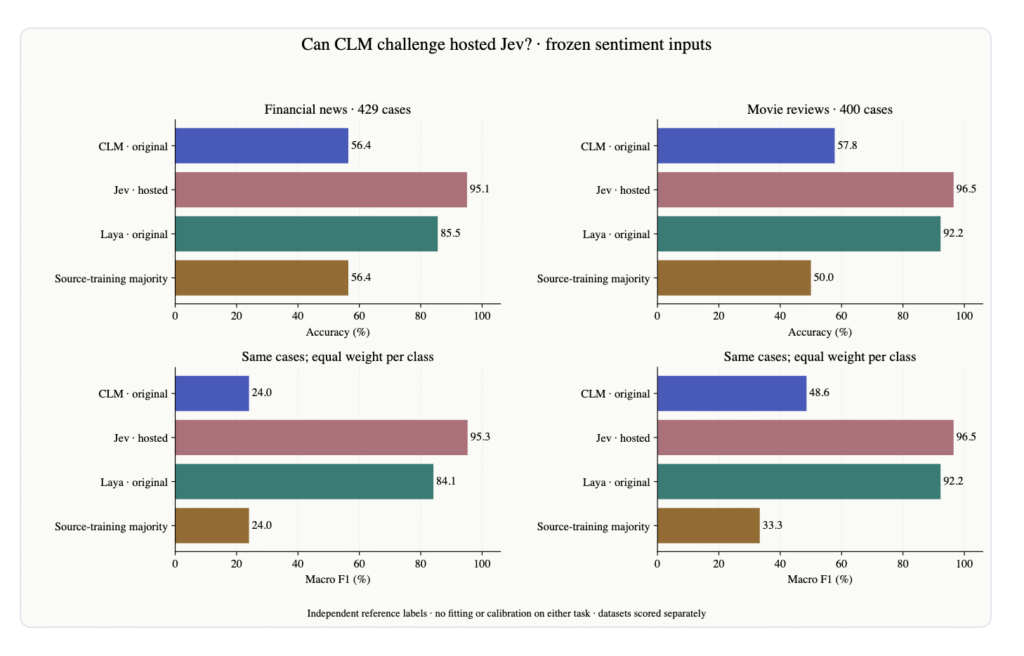
図8:CLM, JEV, Layaの精度比較
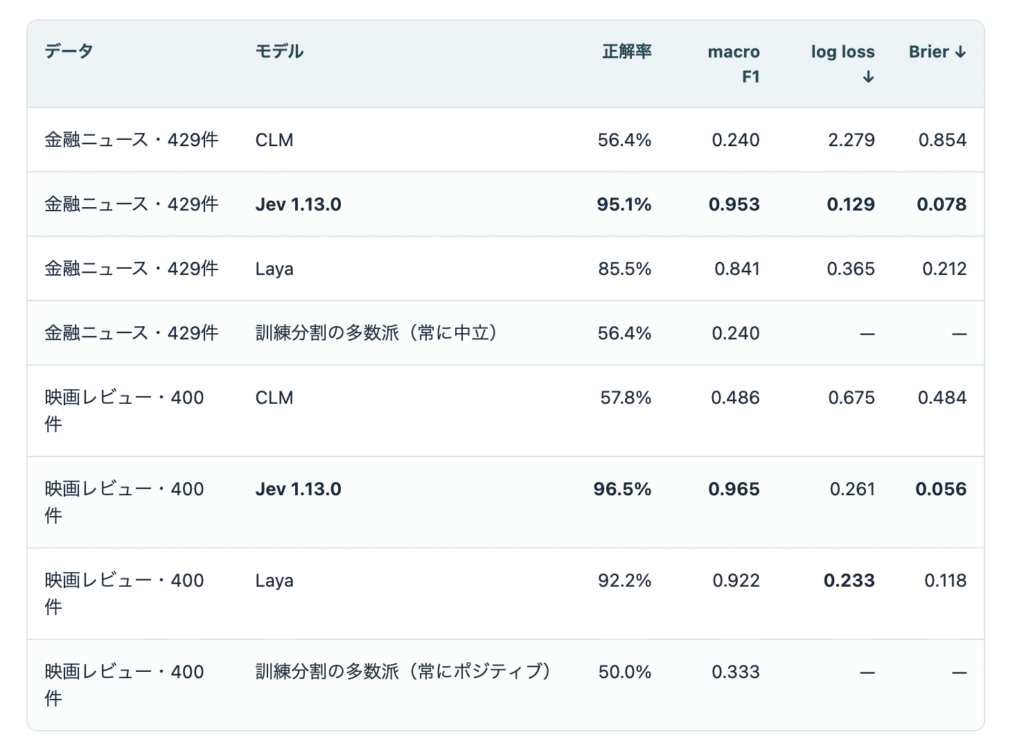
下の表は、同じ正解付き事例に対する追加学習前の三つのモデルの結果です。正解率とmacro F1は大きいほど、log lossとBrier scoreは小さいほど良好です。多数派の行は、予測クラスの偏りを見分けるための対照です。
金融ニュース:CLMは中立だけを選んだ
Jevは408/429件、Layaは367/429件を当てました。CLMは242/429件ですが、429件すべてに「中立」と答えて得た数字です。したがって正解率56.4%は「常に中立」と同じで、macro F1も0.240にとどまります。ネガティブ67件とポジティブ120件は一件も拾えていません。この設定では、CLMが金融ニュースの三つの意味を実用的に区別したとは言えません。
Jevは三クラスを使い分け、macro F1も0.953でした。LayaはJevより低いものの、三クラスを区別して85.5%を正解しました。たとえば中立の文をLayaがネガティブと読んだ事例は52件あり、モデルごとに異なる誤り方をしています。
映画レビュー:金融以外でもCLMは偏った
映画レビューではJevが386/400件、Layaが369/400件、CLMが231/400件を当てました。CLMはネガティブを369件と予測し、実際のポジティブ200件のうち31件しか拾えませんでした。金融ニュースだけでなく、この映画レビューでも候補間の判断が一方に偏っています。
ただし、確率指標の順位は正解率と完全には一致しません。映画レビューのlog lossはLayaが0.233で、Jevの0.261より小さい値です。一方、Brier scoreはJevの0.056が最も小さくなりました。「どの候補を選んだか」と「各候補にどの確率を付けたか」を分けて読む必要があります。
同じ事例で直接比べると
JevとCLMの正解率差は金融ニュースで+38.69ポイント、映画レビューで+38.75ポイントでした。対応づけた再標本化による95%区間は、それぞれ+33.57〜+44.06、+33.75〜+43.50ポイントです。金融ニュースではJevだけ正解した事例が183件、CLMだけ正解した事例は17件。映画レビューでは160件対5件でした。CLMだけ正解した少数の事例も、金融ニュースではすべて正解が中立だった文です。全件を中立にする偏りが、Jevの一部の誤りを偶然避けた面があります。
この差は今回のデータ、候補文、モデルの版、実行環境における観測です。公開文が各モデルの事前学習に含まれた可能性は確認しきれず、モデルの規模や学習データも揃えていません。CLMの4-bitエンコーダと開発元の構成にも差があります。また、発表時刻のある金融開示を時系列で追ったわけではありません。したがって、この結果からCLMのアーキテクチャだけを失敗の原因と断定したり、売買成績を推定したりはできません。
CLM開発元が報告するコンピューター操作・ゲーム・ツール選択ではJev並みで最大9倍高速という主張は、今回の感情分類と評価対象が異なります。本記事では速度を同じ条件で測っていないため、その主張への賛否もこの結果だけでは決まりません。一方、少なくともこの二つの感情データでは、CLMの元モデルをJevの精度上の代替とは言えません。次は、CLMの重みを業務に近いデータで更新できるという別の強みを、財務報告書の分類で確かめます。
FLSで追加学習するとどう変わるか
FLS(Financial Forward-Looking Statements)は、財務報告書などの文を具体的な将来見通し、将来見通しではない記述、具体性のない将来見通しの3種類に分類するデータです。たとえば翌年度の設備投資額を明示する文と、将来の不確実性を一般的に述べる文は、どちらも未来に触れていますが別のクラスになります。金融ニュースの好材料・悪材料判定より、文の用途に即した細かな区別が必要です。正解はデータセットに付いたラベルであり、後からモデルが作った正解ではありません。
- ホームページ・データセットの説明:https://huggingface.co/datasets/FinanceMTEB/FLS
- 今回使った固定版の訓練データ:https://huggingface.co/datasets/FinanceMTEB/FLS/resolve/39b6719f1d7197df4498fea9fce20d4ad782a083/data/train-00000-of-00001.parquet
- 今回使った固定版の公式testデータ:https://huggingface.co/datasets/FinanceMTEB/FLS/resolve/39b6719f1d7197df4498fea9fce20d4ad782a083/data/test-00000-of-00001.parquet
追加学習の手順
1. 入力とデータ分割を固定する。 公開FLSの訓練データ2,600件と公式test 1,000件を取得し、取得したファイルのハッシュを記録しました。文面が同じ、あるいは非常によく似た文が訓練側とtest側をまたがないよう、訓練側から24件を除外しています。残る2,576件を、学習1,676件・モデル選択301件・確率校正299件・検証300件に分けました。公式testの1,000件は最後まで学習や設定選択に使いません。 同じ文面の仲間が別の分割に入らないようにした一方、元データには企業IDと発表時刻が十分なく、企業・時系列単位の分離までは確認できません。
2. 3択の質問を両モデルで揃える。 各文を「現在の状態」とし、「この文の将来見通しを分類する」というChoice質問と、3種類の候補説明を与えます。候補には、具体的な計画・予測、過去や現在の事実、条件付きのリスクや一般的な可能性という違いを書き分けました。CLMにもLayaにも同じ文・質問・候補・正解ラベルを渡します。ただし、正解ラベルを使うのは学習分割とモデル選択分割だけです。推論時の入力には入れません。
3. CLMの二つのヘッドを更新する。 元のCLM-8Bを初期値とし、Mac上の4-bit Qwen3-8Bで状態文と候補文の埋め込みを一度作って保存します。Qwen本体は固定し、状態用ヘッドと行動用ヘッドだけをAdamWで更新します。各文について3候補の類似度をsoftmaxに通し、正解候補に付いた値の負の対数を小さくする教師あり交差エントロピーを用いました。これは前半で説明した、バッチ内の状態・行動ペアを比べる双方向InfoNCEの再学習ではありません。バッチサイズ32、4エポック、学習率は0.0001と0.0003を試し、公開チェックポイントのスコア倍率は固定しました。301件のモデル選択分割で正解率を優先し、同点ならlog lossで選ぶと、学習率0.0003・4エポック目が選ばれました。
4. Layaはエンコーダも含めて更新する。 Layaは状態・質問・候補を一つの入力として読み、候補位置を採点します。こちらは英語版の公開モデルから始め、ModernBERTエンコーダと決定ヘッドをともに学習しました。損失は同じ3択の教師あり交差エントロピーです。2エポックを上限に、エンコーダの学習率を0.00001、ヘッドを0.00005、実効バッチサイズを16として実行しました。モデル選択分割では1エポック目の保存済み重みが最良でした。CLMとは更新するパラメータ範囲も計算量も異なるので、この二つの正解率差を「ヘッドだけの学習」と「全体の学習」の純粋な因果効果とは読みません。
5. 選択を終えてからtestを評価する。 元モデルと選ばれた追加学習後モデルを、残しておいた分割に通します。299件の確率校正分割では出力確率の温度だけを調整し、300件の検証分割では自動処理に回す確信度の基準を別に決めました。以下の正解率とmacro F1は全1,000件の分類結果であり、確信度によって難しい文を除いた成績ではありません。温度を変えても最大スコアの候補は変わらないため、この二つの指標は校正前後で同じです。最後のtestの正解を見て学習率やエポックを選び直していません。
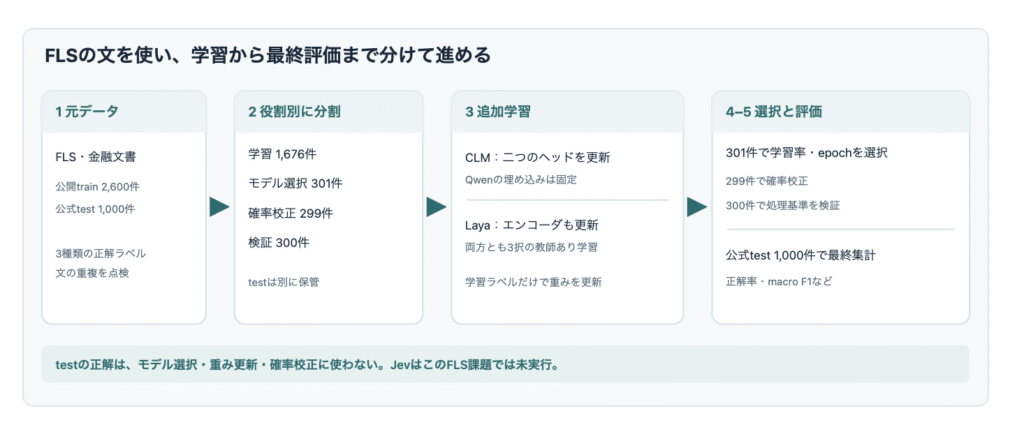
図9:ファインチューニングの手順
追加学習後の結果
以下は公式testの全1,000件で測った結果です。正解率とmacro F1は温度調整で変わりません。表のlog lossは温度調整前の確率から計算しています。
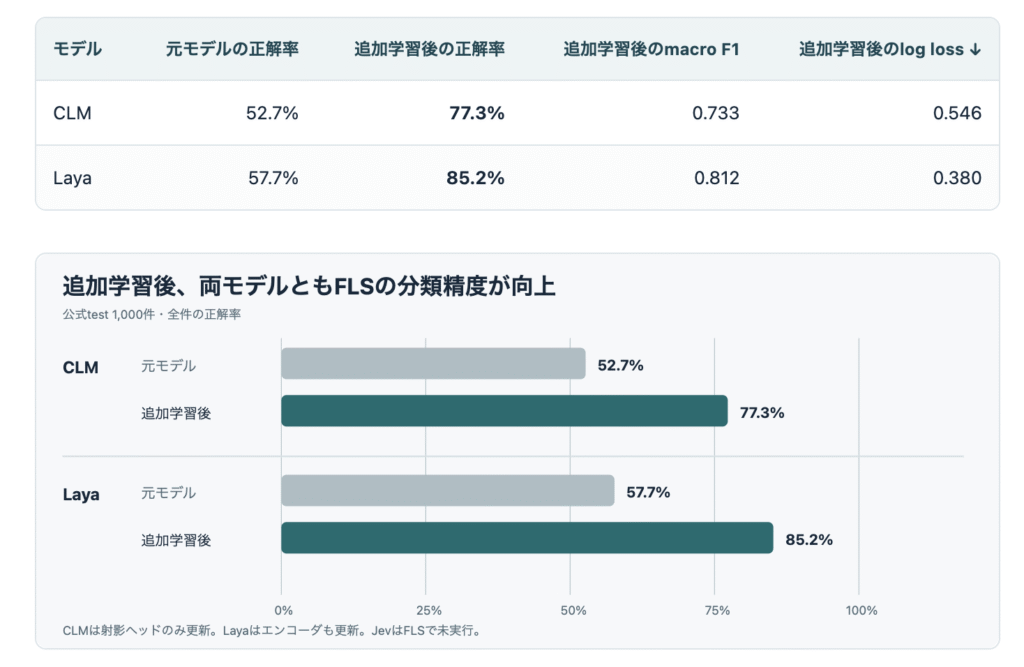
図10: ファインチューニングの結果の比較表
CLMは527件から773件、Layaは577件から852件へ正解数が増えました。改善幅はそれぞれ+24.6ポイントと+27.5ポイントです。同じtest事例を対応づけ、似た文のグループを単位に1,000回再標本化した95%区間は、CLMが+21.2〜+27.8ポイント、Layaが+24.2〜+30.8ポイントでした。元モデルのCLMは「将来見通しではない」というクラスへ強く偏っていましたが、追加学習後は3クラスすべてに回答し、具体的な将来見通し169件のうち95件、具体性のない見通し292件のうち199件を拾いました。
この結果は、CLMの公開ヘッドを対象文書で更新すると、ゼロショットの弱さをかなり補えることを示します。ただし、Layaの85.2%には届かず、JevはFLSで未実行です。FLSで学習したCLMが金融ニュースの感情判定でも良くなる、あるいは取引成績を改善するという結論にもなりません。公開文がモデルの事前学習に含まれた可能性と、企業・時系列単位の分離を確認できない制約も残ります。
CLMはJevの代替と言えるか
今回の英語の感情分類に限れば、精度を理由にCLMをJevの代替とは言えません。 金融ニュースの56.4%は全件中立で得た多数派対照と同じ数字です。映画レビューでもポジティブの大半を見落としました。一方、Jevは同じ入力で95.1%と96.5%、Layaも85.5%と92.2%でした。CLMだけ正解した事例はありますが、金融ニュース17件・映画レビュー5件に対してJevだけ正解した事例は183件・160件です。
しかし、これはCLM開発元の「コンピューター操作・ゲーム・ツール選択ではJev並みで高速」という元の主張そのものを検証した試験ではありません。公開ベンチマーク上の感情分類へ用途を広げたときの結果です。モデルの事前学習で公開文に触れた可能性や、Jevの非公開な学習データ・モデル規模、今回のCLM用4-bitエンコーダの差も残ります。この差を二塔型という構造だけの因果効果とは言えません。
CLMを選ぶ理由は別にもあります。コードと重みを点検・改変でき、固定候補の埋め込みを再利用し、自分のデータでヘッドを更新できます。実際、FLSでは52.7%から77.3%へ改善しました。ただし、これは別タスクの結果であり、金融ニュースや映画レビューでJevとの差が埋まったことを意味しません。Jevの成功829応答について公開単価から見積もると入力トークン分は約0.014米ドルでしたが、CLMのGPU運用費や同条件の応答時間は測っていません。
まとめ
今回の英語の感情分類では、公開チェックポイントのCLMはJevとLayaの精度に届きませんでした。一方、財務報告書のFLSでは、CLMのヘッドを追加学習すると正解率が52.7%から77.3%に改善しました。ただし、追加学習後のLayaの85.2%には及ばず、両者で更新したパラメータの範囲も異なります。
CLMには、状態と候補行動を別々に表現し、候補を差し替えたり、その埋め込みを再利用したりできる柔軟性があります。
最後に
グループ研究開発本部 AI研究開発室では、データサイエンティスト/機械学習エンジニアを募集しています。ビッグデータの解析業務などAI研究開発室にご興味を持って頂ける方がいらっしゃいましたら、ぜひ募集職種一覧からご応募をお願いします。皆さんのご応募をお待ちしています。
参考資料

グループ研究開発本部の最新情報をTwitterで配信中です。ぜひフォローください。
Follow @GMO_RD