2026.09.29
今さら聞けないコンテキスト管理
こんにちは。グループ研究開発本部 次世代システム研究室のY.Uです。
今回の記事は、普段からLLMを活用した作業を行う上で、コストとアウトプット品質の両方の問題を解決するコンテキスト管理の方法について紹介します。
結論:
コンテキストは、コストと品質の両方に響く、重要なリソースである。必要な時に必要なだけの情報を載せること
具体的なイメージを持ってもらうために、一つの場面を想定しながら話を進めます。本番環境でエラー率が急上昇し、原因調査をClaude Codeに任せることになった、という場面を一緒に考えてみましょう。
コンテキストはAIの作業机
コンテキストとは、そのセッションでAIに与えた情報の全部です。送ったプロンプトだけでなく、読ませたファイル、Web検索の結果、Gitの履歴。それらはすべて、次の応答を生成するたびにAPIへの入力としてまるごと送り直されます。イメージとしてはAIが使う作業机に近く、机の上に広げた資料がコンテキスト、机の広さがコンテキストウィンドウです。AIは毎回机の上の資料全部に目を通してから出力を書いているというわけです。
メッセージを送るたびに、AIの机の上には資料が少しずつ増えていきます。何なら、最初の一言を打つ前から机はすでに一部埋まっています。システムプロンプト、CLAUDE.md、メモリ、スキルの一覧。画面に見えていないだけで、最初から資料は広がっているのです。そこにプロンプトが重なっていきます。
机が埋まってくると、主にふたつの悪影響があります。一つ目は、コストが嵩んでしまうこと。LLMのAPIはstatelessなので、会話を継続させるには毎回それまでのやり取りを丸ごと入力として送り直す必要があります。会話が続くほど、この入力トークン数は累積して増えていき、課金額もそれに比例して膨らみます。
もう一つの悪影響は、精度が落ちることです。読ませたファイルの山に本当に探してほしかった情報、重要な情報が埋もれてしまい、AIが見落とす(書いてあっても指示を無視するなど)ことがあります。散らかった机では作業をしにくいのは人間もAIも同じで、実際にClaude Code公式ベストプラクティスにも「コンテキストウィンドウはすぐ埋まり、埋まるにつれて性能が落ちる」という内容が書かれています。
具体例: 障害調査の場面でも、最初はエラーログを何度も机の上に広げてしまい、本当に見るべきエラーメッセージが分厚いログの山に埋もれて見落とされる、ということが起こりそうです。
机を片付ける操作は、3つしかない
厄介なことに、このAIの机はすぐに散らかってしまいます。
なぜなら、コンテキストに物を増やすのが非常に簡単だからです。とりあえず読ませれば勝手に机に載ります。
では片付けるほうは、というと――全部消す(clear)、要約する(compact)、巻き戻す(rewind)。この3つしかありません。
そうです。「このファイルはもう使い終わったから忘れて」という操作は存在しないのです。
これは決定的な事実です。あとから特定のものだけ抜くことができない以上、机を散らかさないためにできるのは「不要なものは載せてしまう前にブロックする」ことだけということになります。
では載せるものを減らせば減らすほどいいのかというと、そう単純な話でもありません。必要な情報はちゃんと渡さないとパフォーマンスは落ちます(情報不足の机では仕事ができません)。目指すべきは必要十分なものだけ渡す、つまり机の上の情報密度をできる限り高く保つことなのです。
具体例: 障害調査の例でも、途中で不要になった古いログの断片を個別に消すことはできません。片付けるとしたら、セッションごと畳むか、要点だけ残して仕切り直すことになります。しかし、もちろんログなしでは障害の原因究明は無理ですよね。
まず、見ることで把握
コンテキスト管理の第一歩は可視化です。
Claude Codeなら/contextで現時点のコンテキスト内訳が確認できます。体感として、埋まり具合が5割を超えてくると、目に見えてコスト効率が悪化し、情報の抜け落ちも目立ち始めます。
ただし/contextはあくまで「いま見た瞬間」のスナップショットです。「そろそろ埋まってきたかな、打ってみるか」と思ったときには、たいてい手遅れです。だからこそ、常に見えている状態にしておくほうが望ましいといえます。
CLIにはステータスラインという機能があり、入力欄の下にモデル名・コンテキスト量・コスト・キャッシュ状況などを常時表示できます。実体は、モデル名・トークン数・コストなどの状態がJSONで標準入力に渡され、それを加工した文字列を標準出力に返すだけのスクリプトで、LLMは使われていません。
/statuslineと打てばClaudeが自動で設定してくれます。まだ試していない方は、一度使ってみることをおすすめします。
残念ながら、現在のところこの機能はCLIにしかありません。やや極端な見方かもしれませんが、この機能があるというだけでCLIを使う価値があると個人的には思っています。
情報の階層化という考え方
では、実際にどうやって賢くコンテキストを管理すれば良いかを考えていきましょう。とは言っても、基本の考え方は一つです。必要な情報を、必要なときだけ載せること。
今回は、机の上、引き出し、倉庫、そして別の机の4つに情報を分けるという例を使っていきたいと思います。ここからはClaude Codeを想定した話になりますが、考え方は他のAIでも共通です。
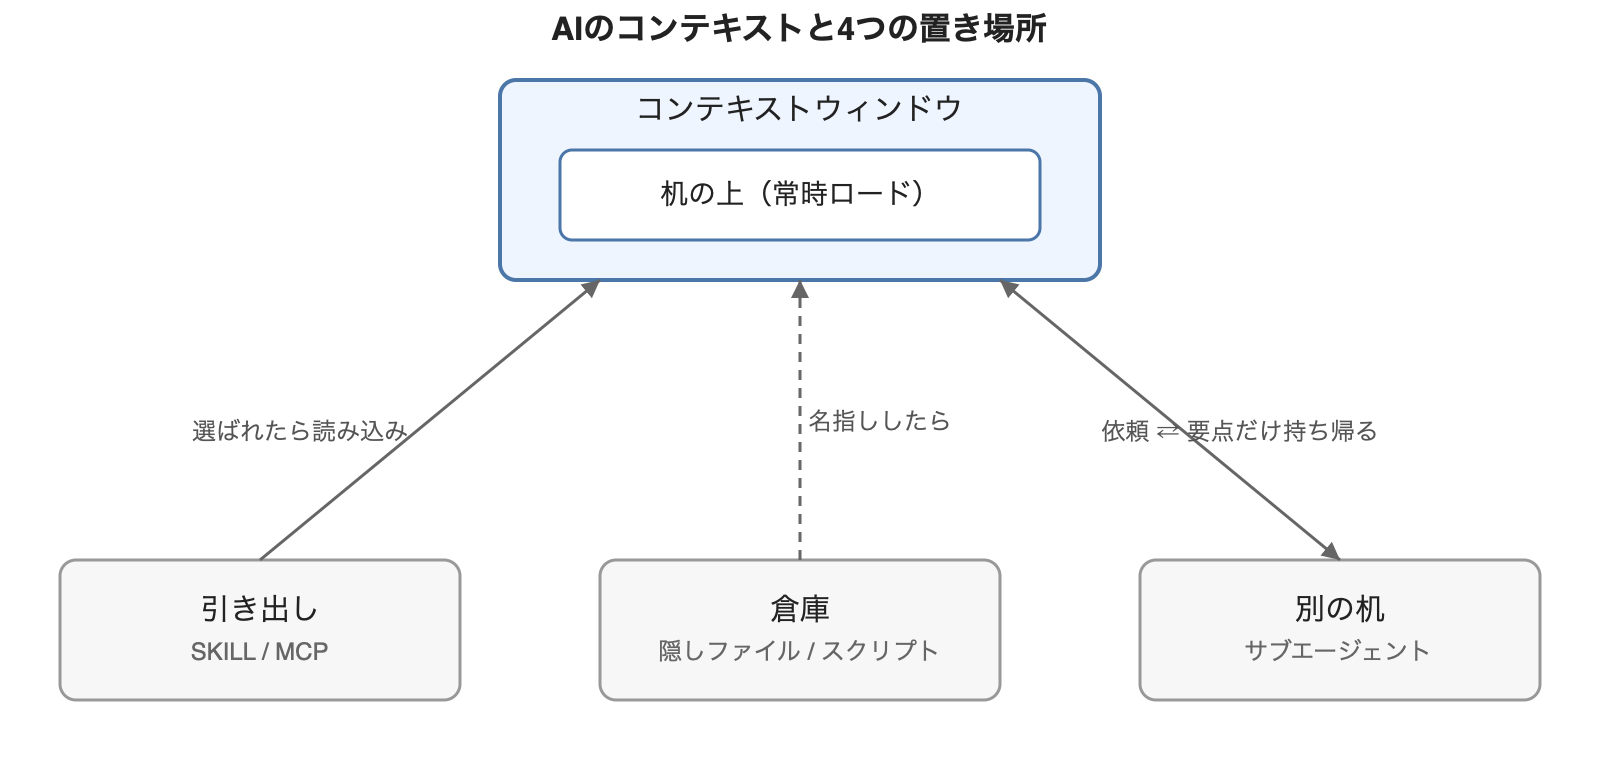
机の上
机の上に置くものは、常に今その瞬間必要な情報だけであるべきです。
入力欄に長文のログをそのまま貼り付けてしまうことはないでしょうか。それは本当に全部必要か、一度立ち止まって考える価値があります。一旦ファイルに書いておき、AIに必要な部分だけ検索させるという手もあります。
具体例: この障害調査でも、長いログをそのまま貼り付けるのではなく、ログをファイルに保存しておき、AIにはエラーに関係する部分だけをgrep(検索)させる、という進め方ができます。
意外と見落とされがちなのはAIの出力です。これも全部机に載ります。不必要に長い回答は控えさせるべきです。出力スタイルを設定する、プロンプトで指示する、プラグインを使うなどの工夫ができます。
そして忘れてはならないのがCLAUDE.mdです。これは毎回必ず読まれるもので、その文章量はコンテキストにダイレクトに響きます。公式の推奨は200行以下で、私のものはおおよそ90行くらいでした。CLAUDE.mdを短くするコツはこのあと紹介します。
引き出し
今すぐ必要でないものは引き出しにしまっておき、必要になって初めて取り出すのが良いです。わかりやすい実例がSKILLです。
個々のスキルには具体的な手順や参照ファイルがありますが、最初から全てを把握する必要はありません。「何があるか」と「いつ使うか」さえ分かっていれば、あとは必要になった時に手順を確認すればいいのです。
Claudeのスキルは実際にこの思想に沿った構造になっていて、SKILL.mdのYAMLフロントマターにあるnameとdescriptionだけが常時コンテキストに載り、本体のMarkdownは該当スキルが選ばれたときに初めて読み込まれます。ちなみにMCPのツールも、定義自体はロードされていても実行時の詳細なロジックは呼び出すまで展開されないという点で同じ構造です。
---
name: incident-log-search
description: 障害調査でログからエラーパターンを絞り込みたいときに使う
---

(本体はここから。選ばれたときだけ読み込まれる)
具体例: この障害調査でよく使う調査手順は、incident-log-searchのようなSkillにまとめておけば、次に似た障害が起きたときも毎回説明し直す必要がなくなります。
意識すべきことはシンプルで、SKILL.mdのdescriptionには「いつ使うか」だけを書き、「どう使うか」「何をするものか」などの残りの情報はすべて本体に書くということです。スキルの存在と使い時さえ最低限把握しておけば、それ以外は使う時に読めばいいからです。あとは、特定のタイミングでのみ必要なルールはCLAUDE.mdからスキルへ移すことも有効ですね。
それともう一つ。実は、CLAUDE.mdは複数あってもいいということをご存知でしたか。ルートフォルダに置く大元の共通ルール以外にも、例えばプロジェクトのフォルダごと、さらにその中のフロントエンドとバックエンドのフォルダ別など、フォルダ階層ごとに置くことができます。
階層化されたCLAUDE.mdは、カレントディレクトリがそのフォルダ配下に入ったタイミングで自動的に読み込まれる仕組みなので、その場所固有のルールや情報を置くことで効率よくコンテキストを管理することができます。
倉庫
スキルやMCPは存在だけは常に把握してもらいたいところですが、情報の中にはそもそも存在さえ知らなくていいものもあります。過去の詳細な文書や大きなログは普段見せないでおき、必要な時に人間側が名指しで指定することでAIの意識が逸れることを防げます。ちなみに、スキルのfrontmatterにdisable-model-invocation: trueを設定すれば、name/descriptionごとモデルからは見えなくなり、ユーザーが/スキル名で明示的に呼び出したときだけ動く状態にできます。
AIから隠すという観点では、スクリプトも非常に強力です。スクリプトはあらかじめ決められた手順どおりに動作し処理を行うプログラムで、LLMは入力と出力さえ知っていれば使えます。わざわざコードの中身を読んで理解する必要はありません。
具体的な実装例の一つとしては、スクリプトと説明書をまとめてSkillとし、SKILL.mdの本体には使い方と入出力仕様だけを書いて実装の中身には触れないようにする、というものがあります。モデルはその説明だけを見てスクリプトを呼び出せばよく、ソースコード自体を開く必要がなくなります。(開くことを禁止できるわけではありませんので注意)
具体例: この障害調査でも、ログから特定のエラーパターンだけを抽出するスクリプトをあらかじめ用意しておき、AIにはスクリプトの使い方だけを伝えて中身は読ませないようにする、という運用が考えられます。
これまではスクリプト制作は面倒な作業でしたが、最近はAIによって簡単に作成できるようになりました。決まった作業は積極的にスクリプト化していくとよいでしょう。
別の机
調べ物や設計のために一度資料を広げる必要はあるものの、必要な結果はたった3行で、そのほかはもう使わない、ということがあります。
このような場合は、そこだけ別の机で作業して、結果だけ持ち帰るというのが有効です。Claudeには「サブエージェント」という形で実装されていて、実体は独立したコンテキストウィンドウを持つ別のLLM呼び出しです。親のセッションとは、渡したプロンプトと返ってきた結果以外は一切共有されません。
調査を別の机でやらせれば、向こうの机が散らかっても、こちらは散らかりません。作業自体に必要な資料の総量は変わりませんが、メインの机に積んでしまうと以降のターンでも毎回すべて読み直されることになります。メインで作業している机に直接大量の資料を載せるよりも、要点だけまとまった紙一枚を持ち帰るほうが作業しやすいといえます。
このサブエージェントはデフォルトで設定されたものがありますが、別途自分で定義することもできます。.claude/agents/配下にMarkdownファイルを置き、frontmatterで名前・使う場面の説明・使えるツール・使用モデルなどを指定するだけです。よく使う調査パターンを専用のサブエージェントとして用意しておけば、毎回プロンプトで手順を指示し直さなくても呼び出せるようになります。
---
name: log-investigator
description: エラーログの原因調査を任せたいときに使う
tools: Read, Grep, Bash
model: sonnet
---
具体例: この障害調査でも、ログの深掘り自体はlog-investigatorのようなサブエージェントに任せて、原因の要約だけを持ち帰らせる、という使い方ができます。
サブエージェントが有効に使える場面としては、独立した調査やレビュー、テストの実行といった、最終結果だけがわかればいいものが主に挙げられます。ただし、あまりにも細かい作業は伝達のオーバーヘッドが勝ってしまうのと、並列で書き込みを伴うような作業は競合が発生するので注意が必要です。
キャッシュの話
最後に一つだけ、ちょっとコンテキストから離れてキャッシュについて紹介させてください。冒頭で、今までの分を毎回全部送っていると書きました。ですが実際は、前回と変更がない部分はプレフィックス単位のキャッシュという仕組みで再利用されています。キャッシュが成功した入力は通常の10分の1のコストで計算されます。ただし、前から見ていって1か所でも変われば、そこから下は全部キャッシュの作り直しです。しかもこのキャッシュにはTTLがあり、一定時間操作がなければ切れてしまいます。
ところで、コンテキストを圧縮する方法の一つにcompactがあります。これまでの内容を全部読んで、その要約を作成しそれを新たなコンテキストとする、というものです。便利なコマンドですが、一つ問題があります。
それは、compactはキャッシュを破壊するということです。今までの内容が大きく変化するので、圧縮した直後から作業を続けると、キャッシュが効かずに意外と高くつくことがあります。
これは個人的な考えですが、私はcompactがあまり好きではありません。理由は二つあり、一つは前述のとおりキャッシュを失うからです。
もう一つは、コンテキストを均等に圧縮するため、最初に決めておいたワークフローが削られてしまうからです。1から10まで指定している手順のうち、3と7だけが抜け落ちる、といったことが要約後にたびたび起こります。
だから私は、コンテキストが詰まってきたらcompactなどで無理にセッションを継続せず、セッションを新しくする前提で引き継ぎ資料を早めに書かせます。そのあと、新しいセッションで必要な情報とハンドオフだけ読ませて再開すれば、本当に大事な部分だけを持って作業を継続することができます。
終わりに
ここまで、コンテキストについてさまざまな観点から述べてきました。
重要なのは一点だけで、「必要な分を、必要な時だけ」という基本原則です。
真に最適な運用は、人によってもタスクによっても異なります。最後に必要になるのは、自分の作業を見直し、一つずつ改善していくことだと思います。うまくいかないときは、「余計なものを持っていないか」を疑ってみるとよいでしょう。現実のデスクもAIのデスクも整理整頓し、コスパよく仕事を進めていきたいものです。
今回は技術的にはあまり深入りしない内容になりましたが、もし皆さんも「もっとこうすればいい」などの情報がございましたら、ぜひコメント等で共有していただけますと嬉しいです!
GMOインターネットグループでは、次世代システム研究室で一緒に働くエンジニアを募集しています!募集職種一覧は以下をご覧ください。
募集職種一覧

グループ研究開発本部の最新情報をTwitterで配信中です。ぜひフォローください。
Follow @GMO_RD