2026.08.25
AIコーディングエージェントのための、ファイルベースのメモリシステム
こんにちは、次世代システム研究室のN.M.です。
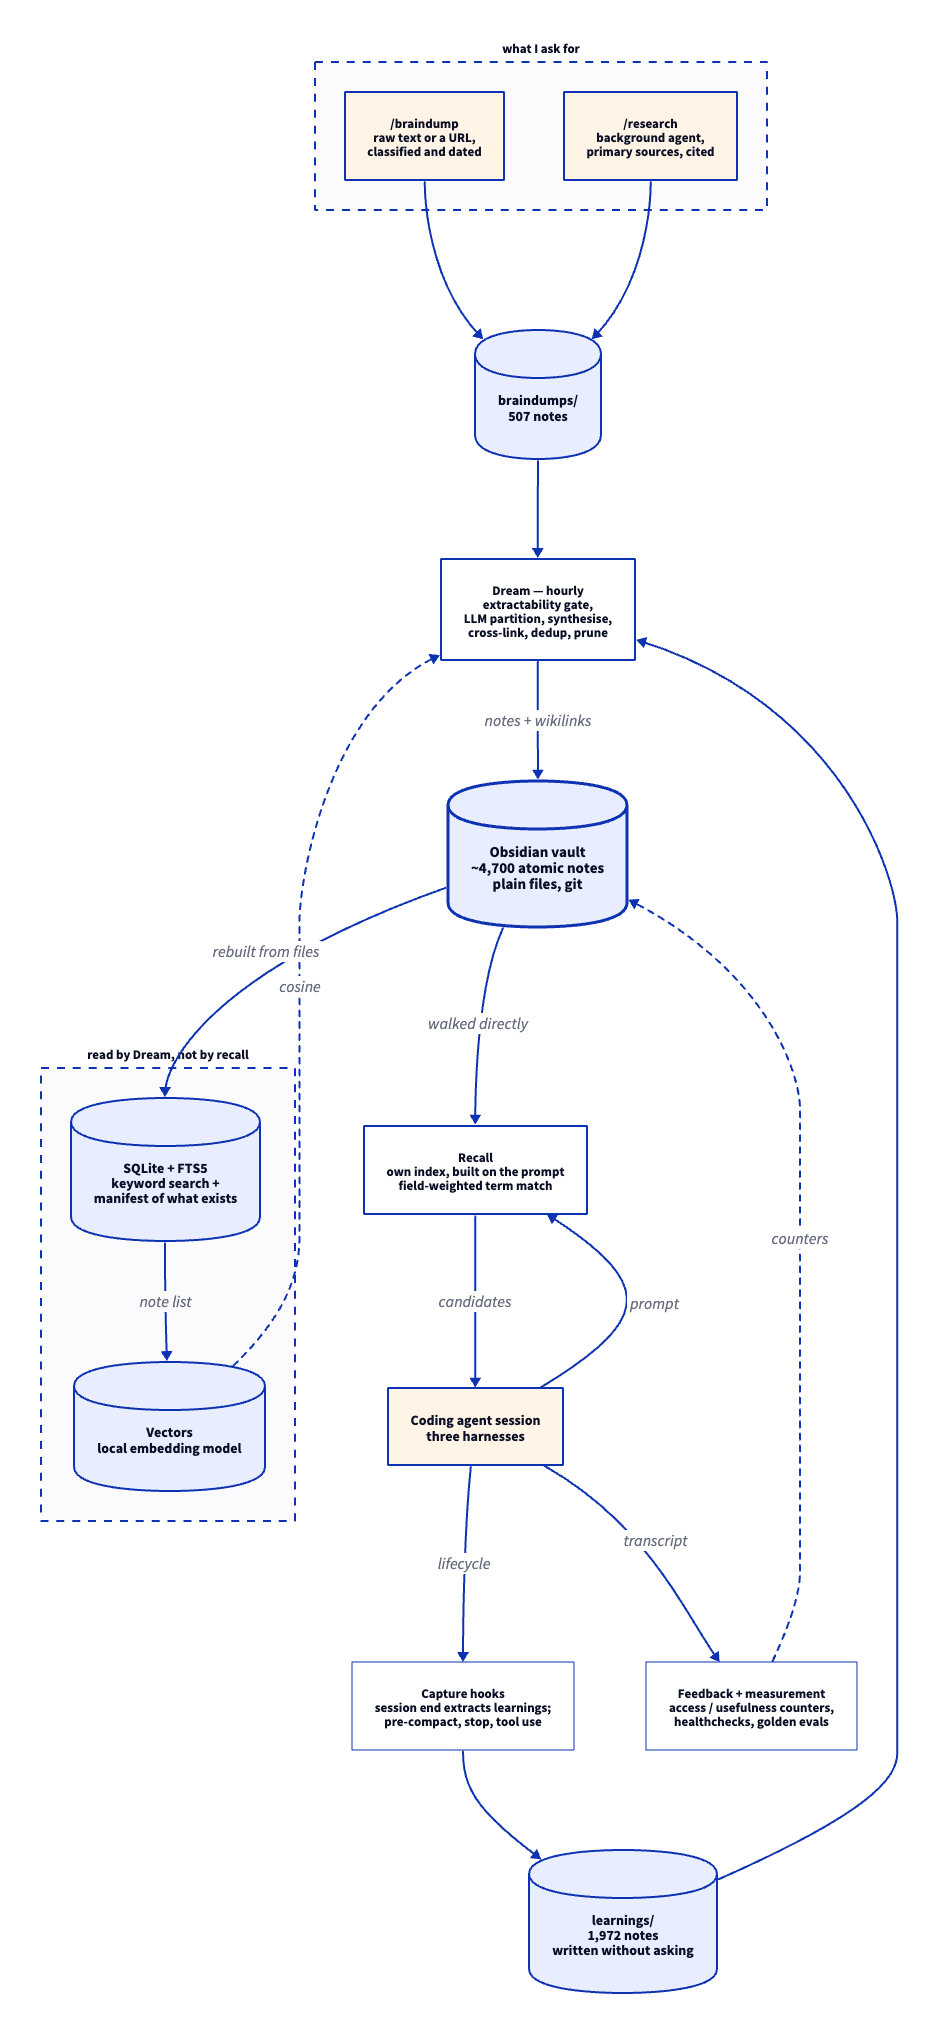
この半年、日常的に使っているコーディングエージェントのために、メモリシステムを作り続けてきました。約4,700個の Markdown ノートからなる Obsidian vault、エージェントハーネスに仕掛けたフック、2つの検索インデックス、モデルが見る前に関連ノートをプロンプトへ注入するリトリーバル層、そして「それが本当に機能しているか」を測るための仕組みです。
特別な部品は使っていません。Obsidian、SQLite、そして llama.cpp か Ollama で動かすローカルの埋め込みモデルだけです。以下ではまず設計判断を述べ、そのあとデータが流れる順に、ノートがどこに置かれるかからリトリーバルの品質をどう確認するかまでを追っていきます。
vault は Markdown の git リポジトリ
ノートは YAML フロントマター付きのプレーンな Markdown で、git リポジトリに置かれています。以下で説明するツール群が一つもなくても読めますし、編集できます。全文インデックス、埋め込み、単語辞書、スコアリングログ。これらは全部消しても、ファイルから数分で再構築されます。
cron ジョブが10分ごとに、変更があれば vault をコミットします。「この変更は記録する価値があるか」を私が判断しなくても履歴が積み上がっていく、という仕掛けです。現時点で3,500コミット、うち36件が今日のものです。
生き残る必要があるのがファイルだけなので、マイグレーションは未来永劫発生しません。ディレクトリを読めるツールなら何でも参加できます。インデックスが壊れてもデータ損失ではなく単なる不便で済みます。最悪の日でも手元には Markdown のフォルダが残ります。
整理はプロジェクト単位ではなく、ノートが「何であるか」に従います。恒久的な知見、生のキャプチャ、意思決定記録、runbook、ワークトラッカー、デイリーノート。この区別は書類棚の些事に見えますが、リトリーバルがそこで絞り込みを始めた瞬間に「これは braindump ではなく runbook だ」がランキングのシグナルに変わります。
ポータビリティ
3種類のエージェントハーネスが、同じファイル群の上に薄いアダプタを1枚ずつ被せてこの vault を読んでいます。そして vault はそのどれにも属していません。Obsidian にも属していません。Obsidian は単に、最も出来の良いクライアントというだけです。
これは美意識ではなく実務上の理由です。エージェントのツール群は速く入れ替わる一方、ノートはゆっくり積み上がります。何年も持ち続けるつもりのコーパスを、特定ベンダーの保存形式に置くべきではありません。git 上のプレーンファイルがそのヘッジです。
なぜアトミックノートで、なぜフォルダではなくリンクなのか
整理のルールは Obsidian ユーザーの間では一般的なものです。完成した知識ノートは1つのトピックだけを扱い、vault のルートに置かれ、「どのフォルダに入れたか」を思い出すのではなくリンクをたどって見つけます。構造は wikilink、タグ、MOC から生まれます。ファイル階層からは生まれません。
ファイル名もそれに従います。小文字、ハイフン区切り、文書の種類ではなくトピックで命名します。[[obsidian-cli]] は文中の語句として自然に読めますが、[[Obsidian CLI Reference]] はそうならないからです。存在するフォルダはカテゴリではなく処理段階であり、キャプチャはそこを通り抜けてルートの知識ノートになります。
Zettelkasten の議論の下には、リトリーバルの議論が敷かれています。1つのことについての1つのノートは、1つの意味を持つ1つの埋め込みを生みます。3つのトピックにまたがるノートは、その3つの中間に位置してどれにも近くない埋め込みを生むため、本来ヒットすべきあらゆるクエリに対して弱くしかヒットしません。ここでのアトミック性は整頓の話ではありません。グラフの辺を意味あるものに保つための条件であり、そしてそのグラフの辺こそが、プロンプトが来たときにノートをランキングの上へ押し上げるものです。
この設計はどこから来たか
vault のレイアウトは Obsidian の一般的な作法です。パイプラインは COG(Cognition + Obsidian + Git)から来ています。Huy Tieu 氏が5つのセカンドブレインを放棄したあとに作ったものです。Notion は3週間、Obsidian とプラグイン20個は1ヶ月、自作の React アプリは完成すらしませんでした。氏の 記事 はその転回をこう書いています。「5回目の失敗のあとで気づいた。私に必要なのは別のノートアプリではない。私の散らかりを整理してくれる AI だ」。COG がユーザーに求める確実な行動はひとつ、生の思考を吐き出すことだけで、分類と統合は git 上のプレーン Markdown に対するスキルへ渡されます。ここでの braindump から知識ノートへの流れは、ほぼそのままの設計です。
そもそもスケジュール実行のパスが存在する理由は Nate B Jones 氏から来ています。氏は、セカンドブレインとは訪問されるまでじっと待つものではなく、こちらが別のことをしている間に分類し、振り分け、浮かび上がらせ、こづくものであるべきだと論じます。これを8つのブロックに分解しており、その多くがこのシステムに生き残りました。摩擦のないキャプチャ、分類の判断をキャプチャ時から取り除くソーター、思考を失っていないと安心できるレシート、確度の低い素材を弾くフィルタ。1時間ごとのパスは氏の「眠っている間に働く」という発想をそのまま実装したものです。名前も独自ではありません。蓄積された知識を統合する背景パスを dream と呼ぶのは、いくつものエージェント型メモリシステムに見られる呼称です。
後半は借り物ではありません。プロンプトへのリトリーバル、インデックス群、有用性ジャッジ、計測スタックはどちらの出典にも存在しませんでした。両者とも、ノートを読むのは人間であってターンの途中でモデルに手渡されるものではない、という前提に立っているからです。
Obsidian が上に足してくれるもの
この先のセクションはすべて機械側の話ですが、私はいまもこれらのノートを手で読み書きしていますし、Obsidian はそれを快適にしてくれます。しかもデータの所有権は奪いません。vault はディレクトリです。Obsidian はそれを開くだけで、中身に Obsidian 独自形式のものは一つもありません。リンクは [[wikilink]]、メタデータは YAML、本文は CommonMark です。
- ネイティブ CLI(Obsidian v1.12.4 以降、全ユーザー無料)。ファイル操作、フロントマターのプロパティ、デイリーノート、コマンド実行をシェルから行えます。
- Local REST API(コミュニティプラグイン)。スコアとコンテキスト付きのランク検索、および Dataview DQL クエリを HTTP 経由で提供します。
- Dataview。 ノートの中で評価されるライブクエリ。トラッカーが自分の未処理項目を自動で並べ、しかもディスクには何も書かれません。
- Git / Tasks / QuickAdd / Excalidraw。 バージョン履歴、vault 横断のチェックボックスクエリ、テンプレート化されたキャプチャ、編集可能なままの図。
CLI と REST API は私のためのものではありません。どちらも手で開いたことは一度もありません。これらはメモリシステムが vault に到達するための経路であり、私自身は他の Obsidian ユーザーと同じように GUI にいます。両端が同じファイルに着地するので、同期するものがありません。エージェントがノートを書けば私のグラフビューに現れ、私が手で直せば次の更新がそれを拾います。
キャプチャ:私が求めるものと、勝手に取られるもの
素材が入ってくる経路は2つあり、違いは「誰が判断するか」です。
私が能動的に叩く経路はスキルコマンドです。/braindump は、頭の中から思考を出すコストを1行ぶんに抑え、置き場所の判断をゼロにするために存在します。生テキスト、あるいは取得して本文抽出する URL を受け取り、個人・業務・プロジェクトのいずれかに分類し、フロントマター付きの日付ノートとして書き出し、アクションアイテムとテーマを抜き出し、その日のデイリーノートに wikilink を落とします。/research は問いに対してバックグラウンドエージェントを走らせ、一次情報源に当たり、各主張に出典を付けて結果をファイルに残します。どちらも braindump として同じフォルダに着地します。
もう一方の経路は私抜きで走ります。セッションが終わるたびにフックがトランスクリプトの直近部分を読み返し、そこに会話ではなく技術的な発見が含まれていたかをローカルモデルに尋ね、候補それぞれを vault の既存内容と突き合わせ、生き残ったものを learnings として書き出します。そのソース自身がこれを「書き込み経路のセーフティネット」と呼んでいます。
セーフティネットには1,972件のノートがあります。私が能動的に叩く2つの経路は、合わせて507件です。
この比率こそが設計の論拠です。その瞬間の私は別の何かを終わらせようとしていて、たったいま理解したことは発見には感じられず、当たり前のことに感じられます。すべてを取り込んで後から仕分ける経路が、4対1で勝ちます。
| イベント | 何をキャプチャするか |
|---|---|
| プロンプト送信時 | リコールを実行(読み取り経路であり、書き込みではない) |
| ツール使用(ファイル読み取り) | 実際に読まれたノートのアクセスカウンタを加算 |
| ツール使用(リサーチ系スキル) | リサーチ結果を vault に永続化 |
| ターン終了時 | そのターンをキャプチャ |
| コンパクト直前 | コンテキストが要約で消える前に状態をキャプチャ |
| セッション終了時 | 恒久的な学びを抽出し、全文インデックスを再構築して埋め込みを更新 |
事前には絶対に思いつかなかったのが、コンパクト直前のフックです。コンパクションはそのセッションで積み上がった詳細がまさに捨てられようとしている瞬間なので、素材を最も破壊しやすいイベントが、そのまま書き込みの引き金になっています。
フロントマターと、先読みが読む2つのフィールド
フックが素材を vault に入れ、フロントマターがその後にできることを決めます。各ノートはタイトル、description、日付、タグ、スコープ、内容種別、利用カウンタを持ちます。
description フィールドは飾りではありません。ノートがプロンプトに注入されるとき、スニペットとして描画されるのがこれです。description が曖昧なノートは検索されにくくなります。モデルが「本文を開くかどうか」を判断する材料が、その1行しかないからです。
締め切りは2つのフィールドに入ります。アクションアイテム用とトラッカー用です。先読みスクリプトがその2つを vault 全体から読み、事前に警告します。そしてここで設計に噛まれました。
実際にあったこと。 今年、ある締め切りをすり抜けさせてしまいました。ノートは存在していて、内容も具体的でした。
しかし日付は本文の散文の中にあり、締め切りフィールドには入っていませんでした。それを捕まえるのが唯一の仕事である先読みは、警告をゼロ件しか出しませんでした。壊れたものは何もありません。すべてのチェックが通っていました。
何でも受け入れるキャプチャシステムは、自分が処理できないものまで黙って受け入れます。対処は賢いパーサではなく、キャプチャの時点で日付をフィールドに入れることでした。いまはキャプチャ側がそうしています。
インデックス群と、実際にそれを読んでいるのは誰か
取り込んだ素材は、また見つけられて初めて価値があります。vault の上には2つのインデックスがあり、さらにリコールが自分専用に持つ3つ目のストアがあります。
字句的(Lexical)。 単一の SQLite ファイルで、vault を走査して各ノートを全文検索テーブルに投入して作ります。これは二役を担っています。キーワードクエリに答えることと、「何が存在するか」の目録であることです。埋め込み生成器は自分で vault を走査せず、このインデックスからノート一覧を読み出します。つまり字句側ができるまで意味側は作れません。クエリは重み付きカラムに対する BM25 でランキングします。
bm25(notes_fts, 10.0, 5.0, 1.0) -- title 10x, tags 5x, body 1x
タイトルの重みを本文より一桁大きくすることが、あるテーマ「について書かれた」ノートを、そのテーマが40段落目に一度出てくるだけのノートに勝たせている要因です。3行から3,000語まで長さがばらつくコーパスでは、重み無しの BM25 はこれを安定して実現してくれません。デイリーノート、テンプレート、添付ファイルは最初から除外しています。量が多く特徴の薄いテキストは関連度ランキングを汚染するからです。
意味的(Semantic)。 ローカルで動くモデルが作るベクトルインデックスです。このプロセスは私が書いたものすべてを読むので、それを従量課金の API に送るかどうかはコストより先にプライバシーの判断だ、という理由でローカルにしています。各ノートはタイトル+冒頭2,000文字から埋め込まれ、キャッシュはファイルの mtime をキーにしているため、更新時は変更されたものだけに触れます。
この2つはプロンプトではなく統合パスのためにあります。クラスタリング、相互リンク、重複排除、アトミック性ゲートがこれらを読みます。リコールはどちらにも触れません。
リコールは自前のインデックスを持っています。vault を直接走査して作り、ファイルごとに mtime とサイズで無効化します。他の2つと違い、これを作るスケジュールは存在しません。必要になった最初のプロンプトがその費用を払い、以降のプロンプトが差分で更新していきます。その最初のプロンプトが高くつかないのは、インデックスが実行をまたいでディスクに残るからです。再起動時はファイルを1つ読み直し、変わったものだけを解析し直します。この vault では、ゼロから作ると約40秒、保存済みのコピーから再開すると約1秒です。ランキングは BM25 ではなく、重み付けしたフィールドに対する語の一致です。同じ語でもタイトルにあれば最も高く、本文では最も低く、しかも本文の繰り返しは4回で頭打ちになります。そのうえで、クエリのどれだけを実際にカバーできたかで候補をスケールします。これにより、異なる6語に当たったノートが、1つのハブ語を全フィールドに積み上げただけのノートに勝ちます。最後に、最近読まれたか、これまで有用と判定された回数が多いか、という加点が乗ります。この経路に埋め込みが登場するのは一度だけ、入力プロンプトをリトリーバルモードに分類するときで、ノートのスコアリングには使われません。
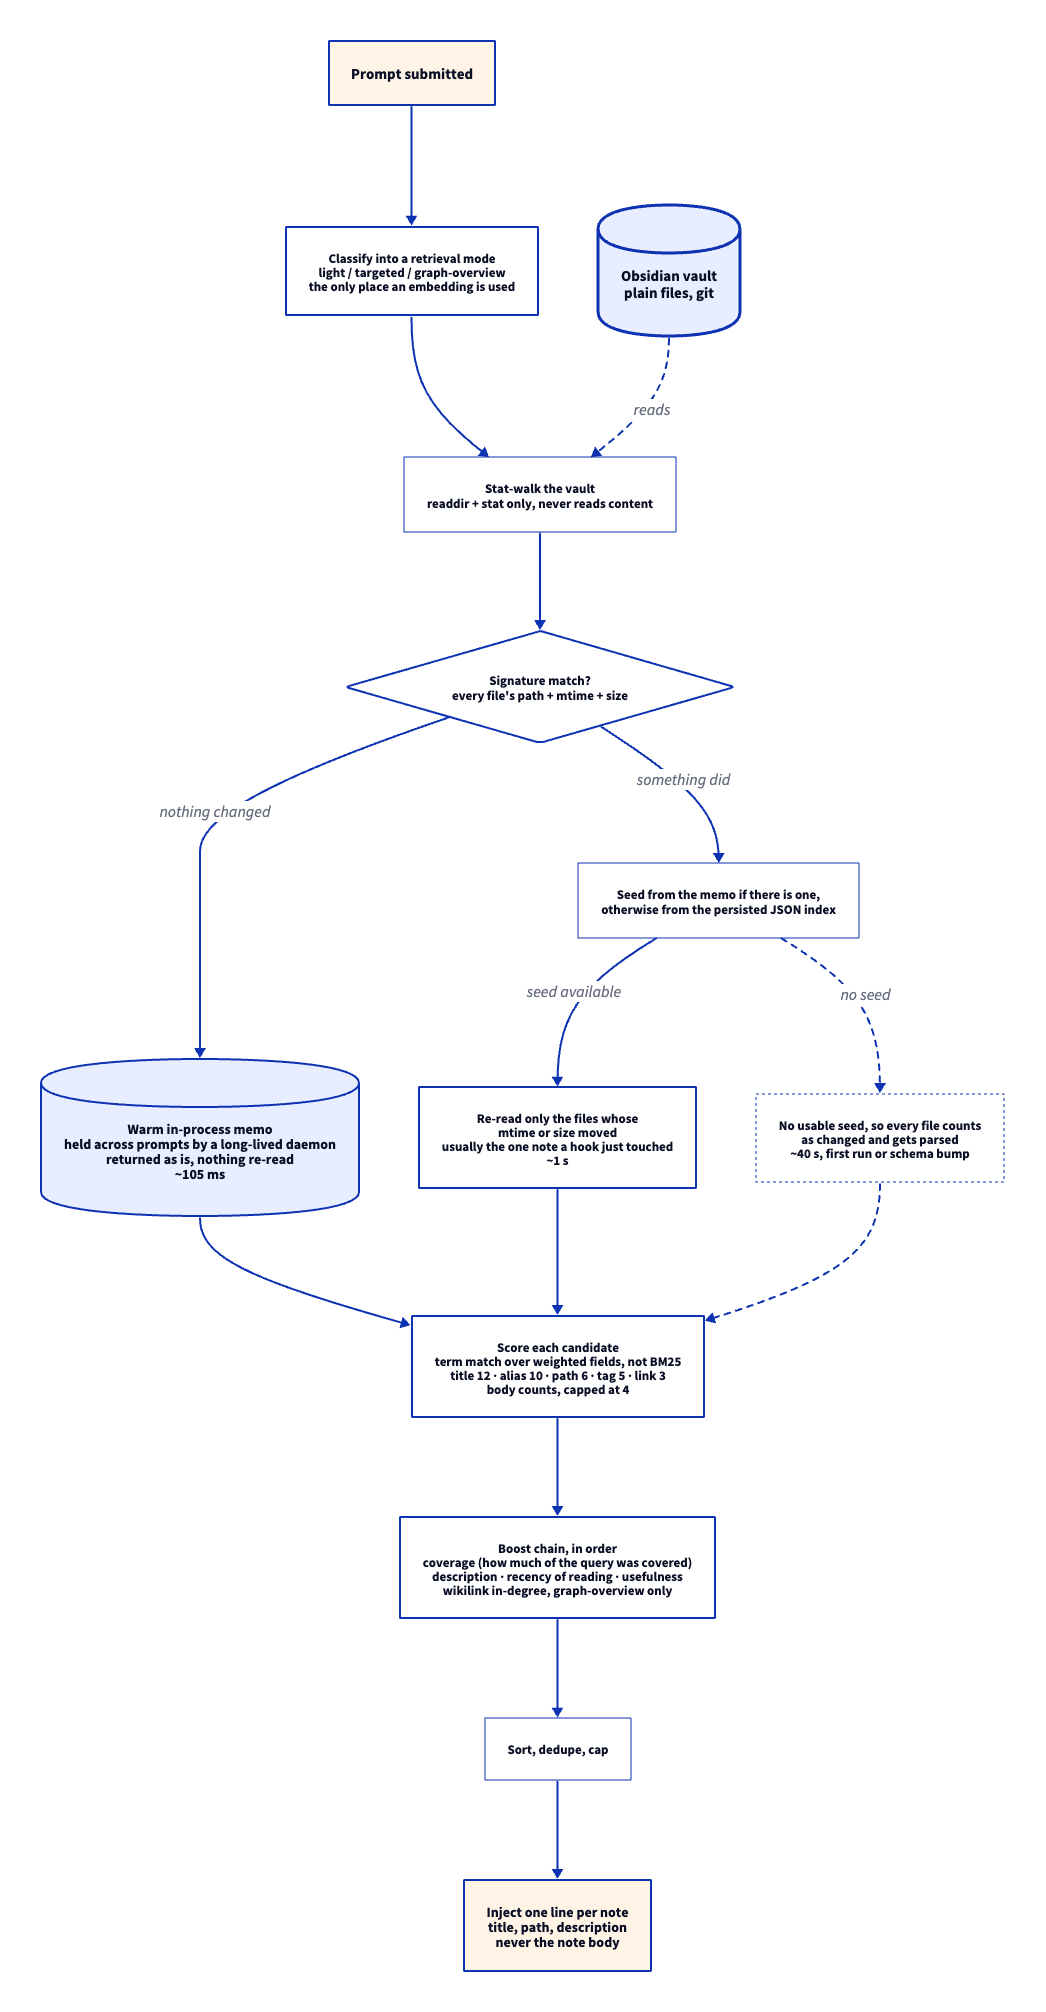
統合パスがプロンプトに届く主な経路は、それが書いたノート自体です。書かれたノートはリコールが検索するコーパスに加わるからです。wikilink の効き方はもっと限定的で、物事のつながりを問う質問でリコールが選ぶ graph-overview モードでのみ、ノートの被リンク数が数えられランキングに反映されます。通常のターンでは被リンク数は計算されません。
Dream:グラフを作るパス
キャプチャとインデックス作成は、互いに何の関係も付けられていないノートの山を生みます。その関係付けをするのが Dream です。約3,200行あり、システム内で最大の構成要素で、launchd の下で毎時実行され、1回のパスに5分から25分かかります。
まず「何を無視するか」を決めるところから始まります。7日より新しいキャプチャは先送りされます。単独のキャプチャは、近くに2つ3つ落ちてくるまでたいして意味を持たないからです。生き残ったものは、そのノートに引き上げる価値のある中身があるかを採点するゲートを通り、リンクだけのキャプチャや中身のないキャプチャを下流全部から締め出します。
クラスタリングはかつて弱点でした。当初は braindump のペアを関連度で採点し、それを推移的に併合していたため、280件のバックログが2つのクラスタに潰れ、大きい方が279件を抱えました。類似度の指標を差し替えると塊は小さくなりましたが、消えはしませんでした。ペア単位の関連度シグナルを推移閉包に流し込めば、グラフが密になった時点で必ず数珠つなぎになります。何がそのスコアを出したかは関係ありません。
いま動いているものは、ペア採点自体をやめました。1回の呼び出しでモデルにタイトルの一覧を渡し、トピックに分割させます。分割は、あとから群を併合する処理が存在しないので数珠つなぎになりようがありません。8件を超える群は寄せ集めとみなし、単独に分解し直します。
生き残った各クラスタは新しいルートノートに統合されるか、既存のノートに畳み込まれ、元のキャプチャは削除ではなく「処理済み」と出力先へのポインタを付けて残されます。続くプロヴェナンスの工程が、新しいノートが元素材を引用し損ねている箇所に ## Sources セクションを追記し、生の素材から切り離された孤児が生まれないようにします。
そしてグラフ本体の作業です。相互リンクの発見は、候補ペアを2つの軸で同時に採点します。テキストがどれだけ似ているかと、そのノート同士が既にどれだけ同じものにリンクしているかです。そして片方だけでなく合成スコアで基準を超えることを要求します。これが、語彙が共通しているだけの2つのノートがリンクされるのを防いでいます。ハブノートはタイトルで除外します。home という名前のノートは何にでも関連してしまうからです。
続いてクリーンアップ。ニアデュープが併合され、負けた側の wikilink は張り替えられます。アトミック性ゲートは各ノートの段落を個別に埋め込み、その凝集度を採点し、0.50 を下回りかつ2つ以上の明確な段落クラスタを示すノートを分割します。弱リンクの剪定が最も脆い辺を削りますが、ブリッジは保持します。スコアだけで剪定すると、1本のリンクだけで繋がっていた領域を切り離してしまうからです。
毎時の実行はほとんどが全部ゼロを報告します。生産的な回は、数件のノートと30〜60本の接続を作ります。
設計で織り込むべき失敗のかたち。 埋め込みの更新は、このシステムの中で最も「どこも赤くならないまま劣化する」経路です。埋め込み生成器は件数をログに出して終了コード0で終わるため、呼び出し側から見ると「1件も埋め込めなかった実行」と「全部埋め込めた実行」が区別できません。しかも更新に失敗したノートは古いベクトルを失わずに保持するので、症状は「壊れる」ではなく「静かに古びる」になります。死活のチェックにこれは見えません。ジョブは走っており、インデックスも書き直されているからです。見えるのはカバレッジのチェックだけです。最新のベクトルを持つべきノートが何件で、実際に何件あるのか。いまそれが入っているのは、バックエンドを移した際にコンテキスト長だけを引き継いでバッチサイズを引き継がなかったことがあるからです。
実際にプロンプトへ注入されるもの
プロンプト送信時、リコール層は入力プロンプトをリトリーバルモードに分類し、自前のインデックスから候補を集め、ランキングし、ユーザーのメッセージの手前にコンパクトなブロックを注入します。モードは意図的に粗くしています。通常ターン向けの light、プロンプトが対象を明示している場合の targeted、物事のつながりを問う場合の graph-overview です。分類はプロンプトだけを埋め込むので安価に済みます。
入るのはノート1件につき1行で、ノート本体は決して入りません。
<vault-memory>
m=targeted
1|Cache invalidation on deploy|learnings/2026-05-02-cache-invalidation.md|Deploys...
2|Blue-green rollback checklist|runbooks/blue-green-rollback.md|Ordered steps...
</vault-memory>
この注入は本文ではなく目次です。だからこそモデルは、行を見て開く価値がありそうなときだけノート全文を開き、1ターンあたりのコストは vault がどれだけ大きくなっても上限内に収まります。この性質がなければ、この設計はノート1,000件あたりで破綻します。
これも私の発想ではありません。エージェントスキルが既にこう動いています。モデルは各スキルの1行の説明だけを見て、実際に呼び出したときにはじめて全文の指示を読み込み、その指示が参照ファイルを指したときにはじめてそれを読み込みます。プログレッシブ・ディスクロージャを、ツールではなくノートに向けたわけです。
リトリーバルは unix ソケット上の常駐デーモンが提供します。プロセスを温めたままインデックスを常駐させ、プロンプトごとにコールドスタートを払わないためです。この vault では、それが3秒と100ミリ秒の差になります。プロンプトのたびにインデックスを作り直しているわけでもありません。走査はファイルを stat するだけで、mtime かサイズが変わったノートだけを読み直します。定常状態では、直前にフックが触れた1件だけです。デーモンが起きていない場合は CLI にフォールバックします。イベントにはどちらの経路が処理したかが刻まれるので、後の分析でウォームとコールドを区別できます。
同一ターン内のヒントと、レイテンシが実際どこにあったか
小さなモデルに先にプロンプトを見せ、何を探すべきか提案させると、ランキングは目に見えて良くなります。明らかな問題はレイテンシです。これはすべてのプロンプトの手前に入るので、私の直感は「もっと速いモデルを探す」でした。計測は違うことを言いました。
| 経路 | レイテンシ |
|---|---|
| ローカルモデル、ヒントのみ | 約1秒 |
| ローカルモデル、構造化プラン全体 | 約4秒 |
| ウォーム状態のホスト型 SDK デーモン | 約5秒 |
| CLI 呼び出し | 10〜30秒 |
レイテンシを決めていたのはモデルではなく、出力サイズでした。同一のローカルモデルが、ヒントなら約1秒、フルプランなら約4秒です。リモート経路はすべて完敗でした。従量課金のものは、負けたうえに費用がかかり、テールのばらつきが増え、vault の内容がマシンの外に出ます。
そこで設計は、同期的なリトリーバルが使える候補をすでに出した後で、ヒント専用の軽い呼び出しをハードな期限と競争させます。勝てば候補が再ランキングされ、追加のリトリーバルが走ります。間に合わなければ、前のターンで非同期に生成されたプランにフォールバックします。プロンプト自体がブロックされることはありません。この実験以来、私は「もっと速いモデルを探す」より先に「モデルに求める量を減らす」に手を伸ばすようになり、そちらのほうが有用な手でした。
事後にリトリーバルを採点する
自己採点しないリトリーバルは劣化します。ループを閉じるカウンタは2つあり、その2つの違いこそが価値のありかです。
アクセスは、ノートの本文が実際に読まれたときに上がります。フックがやるので忘れようがなく、ノートが検索結果に現れただけでは明示的に発火しません。結果に現れることはリトリーバの性能を測り、読まれたことは有用性を測ります。
有用性はセッション終了時に判定されます。バックグラウンドワーカーがローカルの instruct モデル(JSON 出力、temperature ゼロ)に、注入された各ノートをアシスタントが実際に使ったかを尋ねます。引用したか、そこにあるルールを適用したか、言い換えたか、ファイルを開いたか。注入ブロックに現れただけでは該当しません。通ったノートはカウンタが加算され、そのカウンタが以降のランキングに効きます。
ここで実際に効いている実装上の詳細が2つあります。判定モデルの出力は候補集合に対して検証されるので、幻覚で生成されたパスがフロントマターに書き込むことはできません。知識ベースへの書き込み権限を持つ LLM に必要なのは、信頼ではなくホワイトリストです。そしてワーカーは detached で走ります。この呼び出しはフックのタイムアウトよりはるかに長いためです。フックは入力を保存し、ワーカーを起動して、道を空けます。
ヘルスチェック、ゴールデン評価、テレメトリ
ここまでのすべては、正しく動いたまま悪化していくことがあり得ます。
ヘルスチェックはサブシステムの死活を確認します。インデックスの存在と鮮度、埋め込みの最新性、デーモンの応答です。ゴールデン評価は死活チェックには確認できないこと、つまりリトリーバルが今も良いかどうかを確認します。固定のクエリと期待ノートの対で構成され、期待ノートのいずれかが上位 K 件に入れば合格、しきい値は評価可能ケースの80%、実行は毎時です。
これを有用に保つ設計上の要点が1つあります。コーパスは生きていてノートは改名も削除もされるため、期待ノートが消えたケースは失敗ではなくスキップします。恒久的に赤いスイートは、読まれなくなるスイートだからです。ただしスキップは必ず報告されるので、集合は黙って縮むのではなく手入れされます。
これを作る理由は、関連度を破壊するスコアリング変更がシステム内のあらゆる死活チェックを通過してしまうからです。プロセスは起動したまま、インデックスは定刻どおり再構築され、そして答えだけが悪くなります。テレメトリが残りを埋めます。リコールごとの選択モードと最終モード、確信度の帯、結果、フォールバック理由。あるターンがなぜその結果を引いたのかを再構成するには、これで十分です。
トークンに見合う価値はあるのか
注入されたメモリは毎ターン、永遠に課金されます。そして常時オンで動いています。そのターンに必要かどうかに関係なく、すべてのプロンプトが候補ブロックを受け取ります。
1ターンあたりの総コンテキスト中央値は数万トークン規模で、使っている2つのハーネス間で約6倍ばらつきます。この差があるため、2つはプールせず別々に測る必要があります。注入を完全に抑止する形も試しましたし、モデルが必要と判断したときだけ呼ぶツールとしてメモリを提供する形も試しました。どちらも明確な優位性は示さなかったので、いまも動いているのは常時オンです。
これから作る人へ
- プレーンファイルを git に。それ以外はすべてキャッシュ。 以降のあらゆる判断を可逆にしてくれる判断です。
- キャプチャは自分の規律ではなくフックに置く。 人は覚えていられませんし、覚えている必要がある瞬間は、たいてい最も忙しい瞬間です。
- 本文ではなく目次を注入する。 1ターンあたりのコストに上限があることが、請求額を膨らませずにコーパスを育てられる条件です。
- 自動処理させたいものは必ず構造化する。 散文はスクリプトから見えません。
- スコアリングに手を入れる前に、評価を書く。 リトリーバルを悪化させるフィールド重みや加点でも、死活のチェックはすべて通ってしまいます。ゴールデンセットが無ければ、それを教えてくれるものは何もありません。
これは半年かけて出来上がったものです。すでに同じものを作った人たちが正しくやっていた部分を取り入れ、残りは問題が出るたびに直してきました。自分で作る人も、だいたい同じ道筋をたどることになると思います。
次世代システム研究室では、最新のテクノロジーを調査・検証しながらインターネットのアーキテクチャを繋いでいくエンジニア・アーキテクトを募集しています。募集職種一覧は こちら をご覧ください。

グループ研究開発本部の最新情報をTwitterで配信中です。ぜひフォローください。
Follow @GMO_RD