2026.09.25
Jevのオープンソース版「Laya」を使ってみた:考えずに、直感で即答する元祖「System One Models」
TL;DR
- Convai Innovations の Nandakishor Mukkunnoth 氏が公開したオープンソースの意思決定モデル Laya は、状態 (State) と型付きの質問 (Choice / Score / Noul) を受け取り、テキストを生成せずに較正された確率を1回のフォワードパスで返すモデルです。機能的には Jevと同等のコンセプトのモデルですが、Laya はローカルで実行可能な上に速度面でも Jev を大幅に上回ります。Mac向けに最適化されたLaya-MLXも開発され、Apple Silicon上での高速動作も可能です。その一方で、Layaにはコンテキストウィンドウのサイズが小さい点などの制約・限界も存在します。
- Layaのモデル構造はModernBERT/mmBERTをベースにしたエンコーダー型の非自己回帰型の判断モデルです。選択肢毎に
[MASK]トークンを割り当て、そのトークンの表現から判断を行います。学習方法はStrictly Proper Scoring Rulesに基づく較正された確率を最大化する形で、Reinforcement Learning for Calibrated Decisions (RLCD) が用いられています。
はじめに
こんにちは、グループ研究開発本部 AI研究開発室のT.I.です。
さて、先日(昨日)のブログでは、TypeSafe AIが発表した「System One Models」の第一弾 Jev を紹介しました(参考:Jev を使ってみた:考えずに、直感で即答する「System One Models」)。Jevは、状態 (State) と質問 (Questions) を受け取り、Choice / Score / Noul の3種類のプリミティブに対する判断を、確率と確信度付きの構造化データとして返す、テキストを生成しないモデルです。Jevの発表を受けて世界中で注目が集まり、Jevの応用や派生モデルの開発が活発になっています(参考:高速判断AI Jevのユースケースとオープン実装を雑にまとめる)。
そんな、Jev祭といえる状況下で、Dev.toに「1年も前に非自己回帰型の意思決定モデルを強化学習で作っていたのに、とあるフロンティア・ラボがそれを『ブレイクスルー』と発表した件」という(相当にご立腹な様子の)投稿がありました(I built non-autoregressive decision models a year ago. Then a frontier lab called it a breakthrough. – DEV Community、同様の内容の記事が改めてI Built Non-Autoregressive Decision Models with RL a Year Ago. Then a Frontier Lab Called It a “Breakthrough”.としても公開されています)。投稿者はConvai Innovations の創設者兼CEOの Nandakishor Mukkunnoth 氏で、同氏の1年以上前からの研究成果とJevの発表を経て生まれた成果物が今回紹介するオープンソースモデル Laya です。
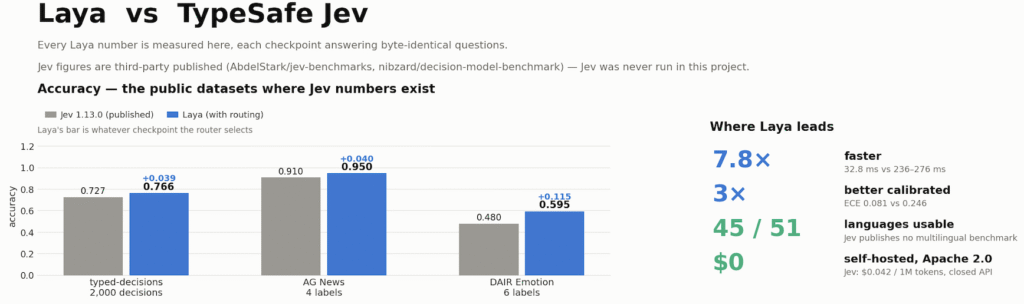
LayaはModernBERT/mmBERTをベースにしたエンコーダー型の非自己回帰型の判断モデルで、オープンウェイトでローカルで実行可能な点がJevと異なる特徴です。推論速度に関しても、Jev以上の高速化が報告されています。以下はGitHubレポジトリで報告されているLayaとJevの性能比較の図です。速度に関して、Layaは32.8 msに対して、Jevは、236-276 msとLayaが7.8倍と圧倒的に高速です。そしてコストについては、Jevが低コスト $0.042/1M tokensに対して、セルフホストであるLayaは無料で利用可能です。
オープンソースですので、Layaをベースとした移植や派生モデルの開発、カスタマイズが容易です。Laya-MLX(https://github.com/mizorewww/laya-mlx)は、mizorewww氏がLayaの重みをMLX形式に変換し、Apple Silicon向けに最適化した非公式の移植版です。GitHubのレポジトリの情報によるとその速度は、英語版が13.4 ms、多言語版が7.4 ms とさらに高速です。
上の動画は、Laya-MLXを用いてテトリスのプレイしている様子(GPT 6 Astraを利用してテトリス+Laya-MLXを実装したものです)。20ms程度で判断を下し、操作をしています。
Layaに至る技術の流れ
まずは簡単にNandakishor Mukkunnoth 氏の研究とJevの発表について時系列で整理してみます。
- 2025年3月30日: Nandakishor Mukkunnoth 氏がarXivにSalesRLAgentを投稿(arXiv:2503.23303)。営業会話の成約確率をリアルタイムに予測する強化学習フレームワーク
- 2025年9月23日: 同氏がConfidence-Aware Routing for Large Language Model Reliability Enhancementを投稿(arXiv:2510.01237)。生成前に信頼度を評価し、クエリの処理経路を切り替える手法
- 2026年9月15日: TypeSafe AIがJevを発表(Introducing System One Models & Jev)
- 2026年9月18日: Nandakishor Mukkunnoth 氏がLayaを公開(https://github.com/NandhaKishorM/laya)とDev.toに投稿(I Built Non-Autoregressive Decision Models a Year Ago. Then a Frontier Lab Called It a “Breakthrough”.)。Jev公表値との比較も掲載
つまり、文章を生成するのではなく、質問に対する判断と確率を出す、そして信頼度が低ければ人間に回すといった一連の発想は、Jev発表よりも前から作者の中にあった、という主張になります。ただ、これらの論文ではJevのような3種類のPrimitivesや強化学習手法が明示的に定義されているわけではありません。Jevの大々的な登場によって、所謂、System One的なAIへの注目が集まり、LayaのインターフェースなどはJevに合わせて開発されたというようです。
Laya/Laya-MLXを使ってみる
では、Laya-MLXを動かしてみようと思います。インストール自体は簡単です。
$ pip install laya-mlx
実行に際して、重みもダウンロードしておきます。
$ hf download aac6fef/laya-multilingual-mlx
ECサイトのレビュー分析
先日のブログのデモでも利用したECサイトへのレビューを分析するユースケースを例に進めていきます。Laya-MLXでの実装例は以下の通りです。ほぼ、Jevの例と同じ形で書けますが、primitives を dictionary形式に書き換える必要があります。
import laya_mlx as laya

MODEL = "aac6fef/laya-multilingual-mlx"

agent = laya.load(MODEL)

result = agent.predict(
    {
        "document": (
            "使い始めて2週間ですが、バッテリーの持ちが悪く、説明書通りの充電時間でも"
            "半日しか持ちません。ただ、デザインは気に入っているので手放すつもりはないです。"
        )
    },
    {
        "recommend": {
            "type": "noul",
            "instructions": "このレビュアーは他の人にこの商品を勧めると思われますか?",
        },
        "main_complaint": {
            "type": "choice",
            "instructions": "レビュー内で述べられている主な不満点のカテゴリはどれですか?",
            "criteria": {
                "品質・耐久性": "破損、故障、経年劣化、作りの粗さなど本体そのものの品質に関する不満",
                "機能・性能(バッテリー等)": "バッテリー持ち、動作速度、機能不足など性能面の不満",
                "価格": "価格が高い、割高に感じるなどコストに関する不満",
                "配送・梱包": "配送の遅延、梱包の破損、誤配送など受け取りに関する不満",
                "カスタマーサポート": "問い合わせ対応、返品・交換対応など事業者側の対応に関する不満",
                "特になし": "明確な不満点が述べられていない、または肯定的な内容のみ",
            },
        },
        "satisfaction": {
            "type": "score",
            "instructions": "このレビュアーの総合的な満足度はどれくらいですか?",
            "criteria": ["非常に不満", "不満", "普通", "満足", "非常に満足"],
        },
    },
)

answers = result["answers"]
recommend = answers["recommend"]
main_complaint = answers["main_complaint"]
satisfaction = answers["satisfaction"]

# Score は criteria のインデックス(0-4)上の確率加重位置。legend(キーは文字列)で最も近い段階のラベルに変換する。
legend = {int(k): v for k, v in satisfaction["legend"].items()}
nearest_level = min(legend, key=lambda level: abs(level - satisfaction["score"]))

print(f"推奨度 (recommend): 他人に勧める確率 {recommend['noul']:.0%}")
print(
    f"主な不満点 (main_complaint): 「{main_complaint['choice']}」"
    f"(確信度 {main_complaint['confidence']:.0%})"
)
print("main_complaint 内訳:", {k: f"{v:.0%}" for k, v in main_complaint["probabilities"].items()})
print(
    f"満足度 (satisfaction): スコア {satisfaction['score']:.2f}"
    f"(0={legend[0]} 〜 {max(legend)}={legend[max(legend)]})"
    f" → 「{legend[nearest_level]}」に最も近い"
    f"(確信度 {satisfaction['confidence']:.0%})"
)
print(
    "satisfaction 内訳:",
    {legend[int(k)]: f"{v:.0%}" for k, v in satisfaction["probabilities"].items()},
)
さて、実行してみましょう。
% time python product_review_analysis_ja_laya.py
推奨度 (recommend): 他人に勧める確率 0%
主な不満点 (main_complaint): 「機能・性能(バッテリー等)」(確信度 77%)
main_complaint 内訳: {'品質・耐久性': '1%', '機能・性能(バッテリー等)': '90%', '価格': '0%', '配送・梱包': '0%', 'カスタマーサポート': '1%', '特になし': '8%'}
満足度 (satisfaction): スコア 0.97(0=非常に不満 〜 4=非常に満足) → 「不満」に最も近い(確信度 74%)
satisfaction 内訳: {'非常に不満': '7%', '不満': '90%', '普通': '3%', '満足': '1%', '非常に満足': '0%'}
python product_review_analysis_ja_laya.py  0.75s user 0.43s system 82% cpu 1.429 total
前回のJevでの実行がuser 0.15秒(total 0.954秒)だったのに対して、今回はuser 0.75秒(total 1.429秒)と若干遅いようですが、これはモデルのロードとウォームアップが含まれるためです。実験のため類似した以下のようなレビューを追加してみます。
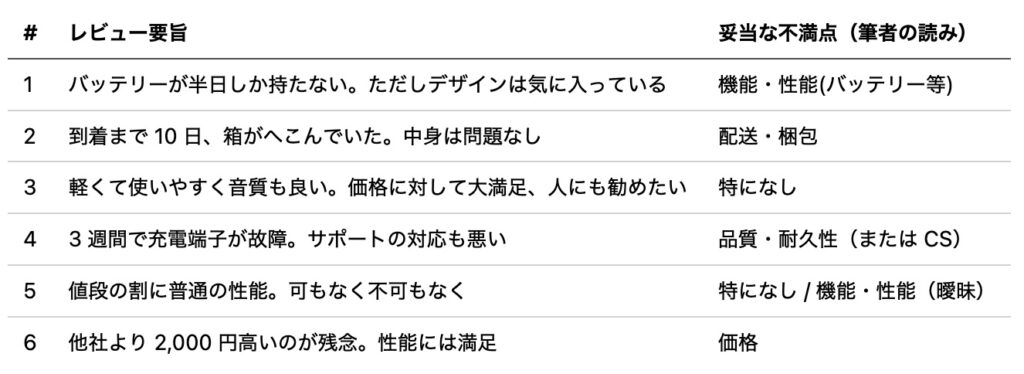
- 使い始めて2週間ですが、バッテリーの持ちが悪く、説明書通りの充電時間でも半日しか持ちません。ただ、デザインは気に入っているので手放すつもりはないです。
- 注文から到着まで10日もかかり、箱もへこんでいました。中身は問題なく動いていますが、配送には不満です。
- 軽くて使いやすく、音質も期待以上でした。この価格でこの品質なら大満足です。友人にも勧めたいです。
- 3週間で充電端子が壊れました。サポートに連絡しても返事が遅く、交換対応も渋られました。二度と買いません。
- 値段の割に普通の性能です。悪くはないけれど、これといった特徴もなく、可もなく不可もなくという感じです。
- 同じ機能の他社製品より2,000円ほど高いのが残念。性能自体は満足しているので、もう少し安ければ星5です。
これらの内容をまとめると以下の表の通りです。
JevとLaya-MLXにこれらのレビューを入力した結果と各々の実行時間は以下の通りです。
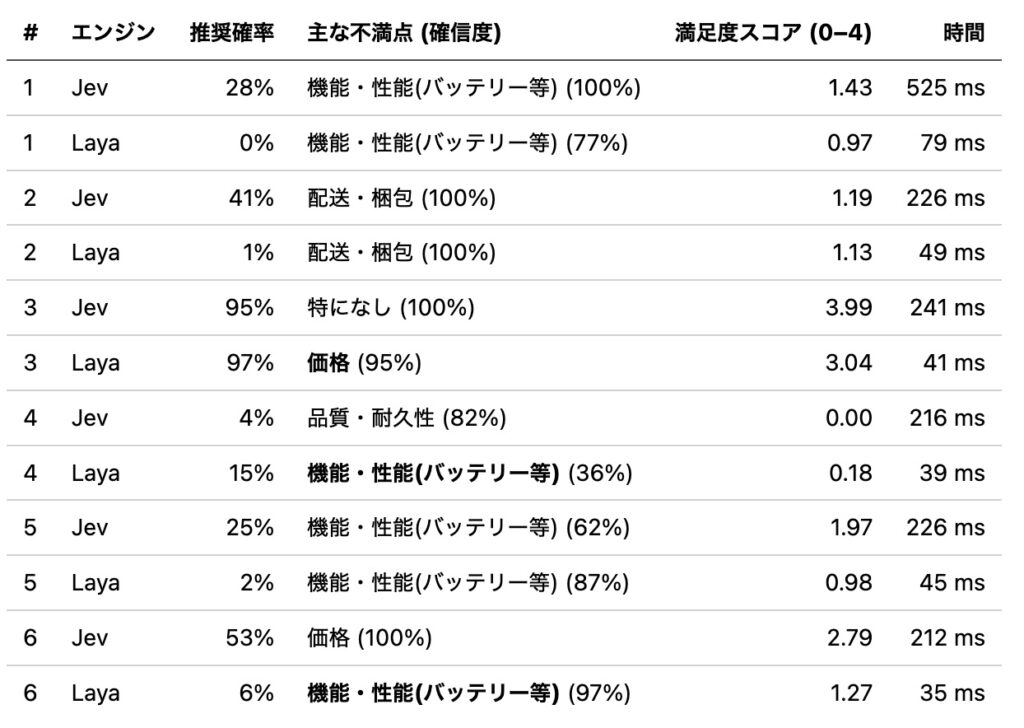
実行時間に関しては、Jevでは初回の525msを除けば210〜240ms程度ですが、対してLaya-MLXでは、初回の79msを除くと35〜50msと大幅に短縮されています。推薦度に関しては元々辛口のレビューが多いので推薦されるものは少なく、大小関係の傾向としては一致しています。ただし、Jevが25〜53%といった中間的な値を返すのに対し、Laya-MLXは0〜6%と系統的に低く、0か1に振り切れる傾向があります。較正を売りにするモデルとしては気になる挙動です。ただ、レビュー3番は、価格に対して不満を述べていないにも関わらず、Laya-MLXでは価格に対する不満が誤って検出されてしまっています。また、レビューの6番も同様に不満点は価格であり、性能には満足とありますが、Laya-MLXでは、機能・性能を不満点として誤って検出してしまっています。モデルのサイズなどの違いにより日本語の細かいニュアンスが正確に捉えられない可能性があります。
ECサイトの問い合わせエスカレーション判定
次に、前回記事で利用したECサイトの問い合わせエスカレーション判定の結果をLaya-MLXで試してみます。お問い合わせ内容は以下の通りです。
- 注文番号#2024-5551234の件で4回目の連絡です!!先週から何度も問い合わせているのに、まともな回答がありません。15万円の高級時計を注文したのに、届いたのは全く違う安物の時計でした。もう我慢の限界です。今すぐ責任者を出してください。SNSで拡散することも考えています。
- お世話になります。来月旅行に行くので、Mサイズのスーツケースを探しています。商品番号TR-789の在庫はありますか?また、色はネイビーとブラックどちらがおすすめでしょうか?空港での預け入れサイズに対応しているかも教えてください。
- 大至急確認をお願いします!!今朝、身に覚えのない注文確認メールが5件も届きました。私のアカウントで合計30万円以上の家電製品が注文されています。すぐにキャンセルしてください。パスワードは変更しましたが、クレジットカード会社にも連絡した方がいいでしょうか?不正アクセスされたようで怖いです。
- 先週のセールで購入したワンピースについて質問です。洗濯表示を見たらドライクリーニング推奨となっていますが、自宅で手洗いは可能でしょうか?素材はポリエステル60%、レーヨン40%です。また、アイロンをかける際の温度設定も教えていただけますか?
- 息子が貴社で購入したプラモデルの小さな部品を誤って飲み込んでしまい、現在救急病院にいます。商品には3歳以上と書いてありましたが、こんな小さな部品が入っているとは思いませんでした。対象年齢の表示に問題があるのではないでしょうか。病院の診断書も準備しています。製造物責任について御社の見解を聞かせてください。
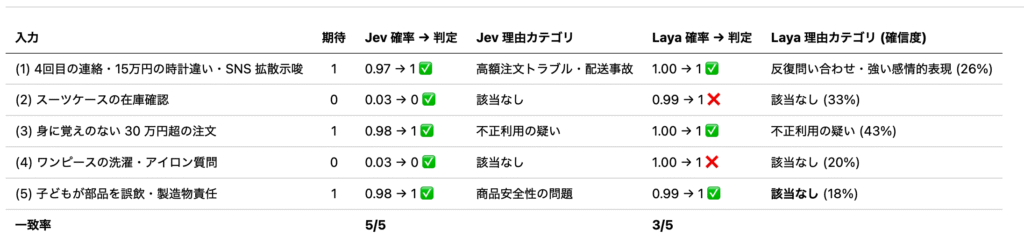
結果は以下の通りとなりました。Laya-MLXの場合、エスカレーション不要なケースでも誤ってエスカレーションが必要と判定されることがあるようです。
なぜうまく分類できないか、もう少し検証してみます。実はこのコードでは、noulの定義で、エスカレーションするかしないのtrue/falseの説明を含めていませんでした。この場合では、true/falseの記述がデフォルトとなり判定基準が正しく反映されません。これをベースラインのパターンA(policy criteriaなし)とします。
# A. policy (criteria なし)

noul question: `state.policy` に定義された基準に照らし、`state.document` の問い合わせは緊急対応(エスカレーション)が必要ですか?
  false: no, the statement does not hold
  true:  yes, the statement holds
state: {"document": "お世話になります。来月旅行に行くので、Mサイズのスーツケースを…",
        "policy": "緊急対応必要: 金銭的損害、…(policy 全文 約 300 トークン)"}
まずは、改良案として、true/falseの記述を追記したパターンB(policy + criteria)です。
# B. policy + criteria

noul question: (A と同じ質問文)
  false: 通常対応(Label 0)。標準的な対応時間(1-3営業日)で処理可能な問い合わせ: 商品の在庫確認・配送状況の確認・注文方法の質問、返品・交換の通常手続き、ポイントやクーポンの使い方、…
  true:  緊急対応(Label 1)。金銭的損害・セキュリティリスク・法的問題があり、24時間以内の対応が必要な問い合わせ: 不正利用の疑い(…)、商品の安全性の問題(…)、10万円以上の高額注文のトラブル…
state: {"document": "…", "policy": "…(A と同じ)"}
また、policyを状態として与えるのではなく、criteriaに与えるパターンも試してみます。(パターン C criteriaのみ)
# C. criteriaのみ

noul question: この問い合わせは緊急対応(エスカレーション)が必要ですか?
  false: 通常対応(Label 0)。…(B と同じ長い説明)
  true:  緊急対応(Label 1)。…(B と同じ長い説明)
state: {"document": "お世話になります。来月旅行に行くので、Mサイズのスーツケースを…"}
最後に、パターンDとして、criteriaを短く要約して与えるパターンも試してみます。
# D. 短い criteria のみ

noul question: この問い合わせは緊急対応(エスカレーション)が必要ですか?
  false: 通常対応: 在庫・配送状況・返品手続き・商品仕様などの一般的な質問
  true:  緊急対応: 不正利用・健康被害・高額トラブル・法的措置の示唆・強い怒りや再三の問い合わせ
state: {"document": "お世話になります。来月旅行に行くので、Mサイズのスーツケースを…"}
最初の結果と合わせて5パターンの分類結果が以下の表となります。バツは誤って分類されたものを示します。
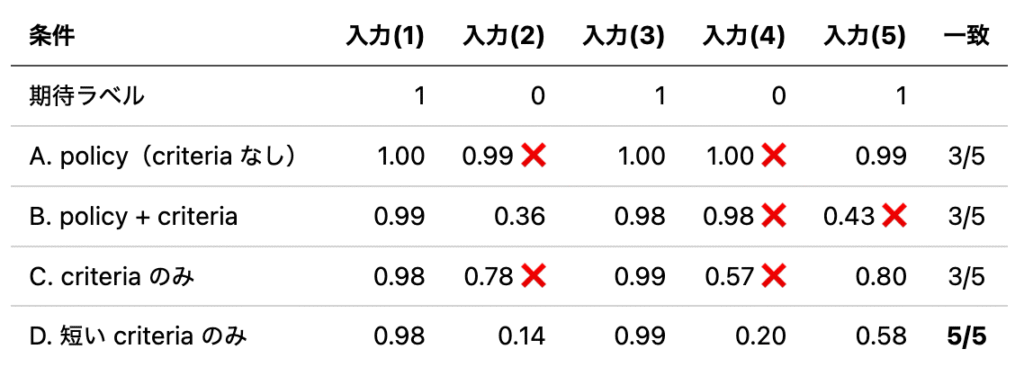
短いcriteriaを与える場合が、最もモデルの判定精度が高くなる傾向にあります。これは、Layaの実装の設計の問題で、各選択肢の説明が48トークンで切られてしまうことが原因です。判断基準を詳しく述べようにもプロンプトがオーバーするため、短く簡潔にまとめることが重要です。Layaを使用する際は、性能を確認しながらプロンプトの設計が必要です。
Layaの技術詳細
Dev.toの投稿とGitHub/Hugging Faceの説明をもとに、Layaの技術要素について紹介します。
アーキテクチャ:ModernBERTと[MASK]トークン
LayaはLLMのようなデコーダー型ではなく、エンコーダー型のモデルです。バックボーンには ModernBERT-large(約395Mパラメータ、28層、隠れ次元1024、RoPE、最大8,192トークン)を使い、その上に小さな判断用のヘッドを載せています。全体では421Mパラメータで、多言語版は mmBERT-base ベースの322Mパラメータです。なお、8,192トークンはあくまでバックボーンの能力値で、Layaのチェックポイントの設定上の入力上限は英語版で512トークン、多言語版で1,024トークンとかなり短く設定されています。モデルの構造とフローは以下の図のようになっています。
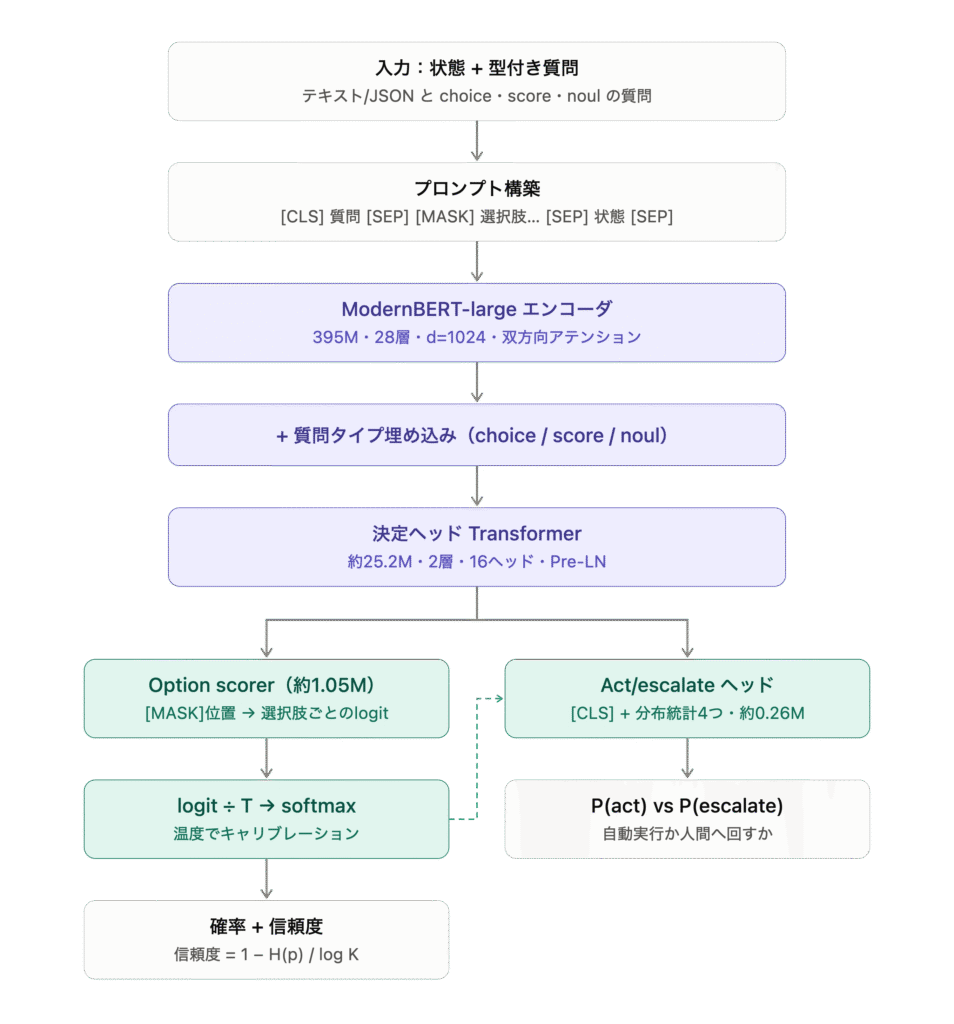
処理の流れは次のとおりです。
- 状態(テキストまたはJSON)と型付きの質問を、1本のプロンプトに整形。入力の冒頭に
[CLS]トークン、選択肢ごとに[MASK]トークンを配置 - エンコーダの双方向注意機構 (Bidirectional Attention) で、状態と全質問・全選択肢を一度に読み込む
[MASK]位置の隠れ状態を取り出し、2層の判断ヘッド (Decision Head, 約25.2Mパラメータ) に渡す- 選択肢スコアラ(約1.05M)が各選択肢のロジットを出し、温度付きソフトマックスでキャリブレーションし、
[CLS]トークンと共にAct/Escalateヘッド(約0.26M)が自動処理してよいかの確信度を出す
つまり何も生成をせずに、穴埋めの位置にある表現を読み取って確率にする設計です。すべての質問を1回のフォワードパスで同時に処理できるため、質問を増やしても1問あたりのコストは下がっていきます(Tesla T4での公表値では1問39.5msに対し、10問をまとめると158.6ms、1問あたり15.9ms)。ただし、選択肢ごとに [MASK] が増えて系列長が伸びるため、全体のレイテンシ自体は質問数に応じて増加します。一方で、選択肢に割り当てられるトークンが少ないため(英語版で192トークン、多言語版では256トークン)、選択肢が多いChoiceでは、個別の選択肢の情報が十分に表現されず対応できません。その点、Jevが最大255択に対応しているのとは対照的です。
RLCD(Reinforcement Learning for Calibrated Decisions):Strictly Proper Scoring Rules による学習
Layaの学習は、Jevのものと同じ呼称の RLCD(Reinforcement Learning for Calibrated Decisions)です。目的は同一ですがJevの実装が不明なため厳密には異なると思われます。一般的な分類問題で利用されるクロスエントロピー損失を使うと確率が過信気味になりやすいため、代わりに「Strictly Proper Scoring Rule (厳密固有スコアリング規則)」を報酬に使う、とのことです。これは、予測者自身が信じる確率を正直に報告した際に、期待報酬が最大になる方式です。
報酬は、次の3つのスコアの合成として説明されています。
Reward = S_log + 0.5 × S_sph − 1.0 × S_rps
- 対数スコア (Logarithmic Score):正解の選択肢に低い確率を付けるほど、強く罰する
- 球面スコア (Spherical Score):0〜1に有界で、極端な勾配を生みにくい
- 順位確率スコア (Ranked Probability Score, RPS):順序尺度のスコア(
Scoreプリミティブ)で、順序の距離を考慮する
また、訓練データについて作者は「実世界の公開データセットの人が付けたラベルのみを使い、合成データは使わない」ことをアピールしています。その理由として、「合成ラベルで較正モデルを訓練すると、LLMの間違いに合わせて較正してしまう」と述べています。較正を売りにするモデルとして、なかなか筋の通った主張だと思いますが、実に手間のかかる作業ですね。
まとめ
今回は、Jevと同じコンセプトを持つオープンソースの判断モデル Laya を紹介しました。Layaは、単純なJevの再実装ではなく、作者が2025年から研究を進めていた独自の判断モデルの研究の成果と主張されています。ただ、事実上、設計としては、Jevを踏襲しており、状態と型付き質問を受け取り、生成せずに較正された確率を返すという設計です。技術的には、ModernBERT / mmBERTのエンコーダに [MASK] トークンで質問を埋め込み、厳密固有スコアリング規則を報酬とするRLCDで訓練する、という組み合わせです。
このLayaをApple Siliconに最適化されたLaya-MLXを実際に動かしてみたところ、速度面は文句のないものでした。一方、前回のJev記事と同じ日本語のエスカレーション判定は 3/5(Jevは5/5)であり、入力トークンの長さの制限などを考慮してプロンプトの設計が重要であることが分かりました。
最後に
グループ研究開発本部 AI研究開発室では、データサイエンティスト/機械学習エンジニアを募集しています。ビッグデータの解析業務などAI研究開発室にご興味を持って頂ける方がいらっしゃいましたら、ぜひ募集職種一覧からご応募をお願いします。皆さんのご応募をお待ちしています。
参考資料
- Jev を使ってみた:考えずに、直感で即答する「System One Models」
- I built non-autoregressive decision models a year ago. Then a frontier lab called it a breakthrough. – DEV Community
- I Built Non-Autoregressive Decision Models with RL a Year Ago. Then a Frontier Lab Called It a “Breakthrough”.
- NandhaKishorM/laya [GitHub]
- convaiinnovations/laya [Hugging Face]
- mizorewww/laya-mlx [GitHub]
- aac6fef/laya-multilingual-mlx [Hugging Face]
- laya-mlx [PyPI]
- SalesRLAgent: A Reinforcement Learning Approach for Real-Time Sales Conversion Prediction and Optimization (arXiv:2503.23303)
- Confidence-Aware Routing for Large Language Model Reliability Enhancement (arXiv:2510.01237)
- Introducing System One Models & Jev – TypeSafe AI Blog
- 高速判断AI Jevのユースケースとオープン実装を雑にまとめる [Zenn]

グループ研究開発本部の最新情報をTwitterで配信中です。ぜひフォローください。
Follow @GMO_RD