2026.09.24
Jev を使ってみた:考えずに、直感で即答する「System One Models」
TL;DR
- 元OpenAIの研究者Diogo Almeida氏率いるTypeSafe AIが、2026年9月15日に新カテゴリ「System One Models」と題した第一弾モデル「Jev」を発表しました。Jevは自然言語を生成せず、入力された状態と質問に対し、事前定義したスキーマに沿った型付き・確率付きの判断のみを返します。公表ベンチマークでは主要LLM比で最大193.6倍高速、444.6倍安価(入力$0.042/1Mトークン、出力無料)とされています。
- 飲食店レビューの評価やECサイトの問い合わせ分類を試したところ、いずれも高速・低コストで正確に判断できました。公式のAgent skillも公開されています。発表当初、利用にはWaitlist登録が必要でしたが、9/21以降は誰でも利用可能になりました。
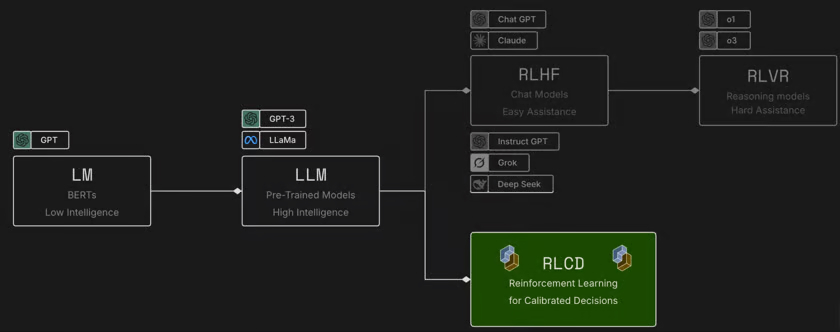
- 技術的な特徴は、構造化出力特化の高速化と、RLCD(Reinforcement Learning for Calibrated Decisions)です。人の嗜好や推論過程ではなく判断の確信度の較正を最適化するため、迎合バイアスのない正確な確信度が得られます。
はじめに
こんにちは、グループ研究開発本部 AI研究開発室のT.I.です。2026年9月15日、ChatGPTの開発にも携わった元OpenAIの研究者 Diogo Almeida氏が創業したスタートアップ TypeSafe AI が、「System One Models」と銘打って「Jev」を発表しました(Introducing System One Models & Jev – TypeSafe AI Blog、TypeSafe AI Emerges From Stealth With $40M in Funding – Morningstar)。
Jevの強みは、超高速かつ低コストで判断を下せる点にあります。System Oneという名前は、ダニエル・カーネマンの心理学理論における直感的・自動的な思考(System 1)に由来します。LLMの発展を振り返ると、初期のChain-of-Thoughtプロンプトによる推論力の強化に始まり、今日のLLMは深く考える、つまりカーネマンのSystem 2的な思考を前提とした設計が主流です。それに対して、熟考せずに直感で即答する、というのがSystem Oneの発想になります。
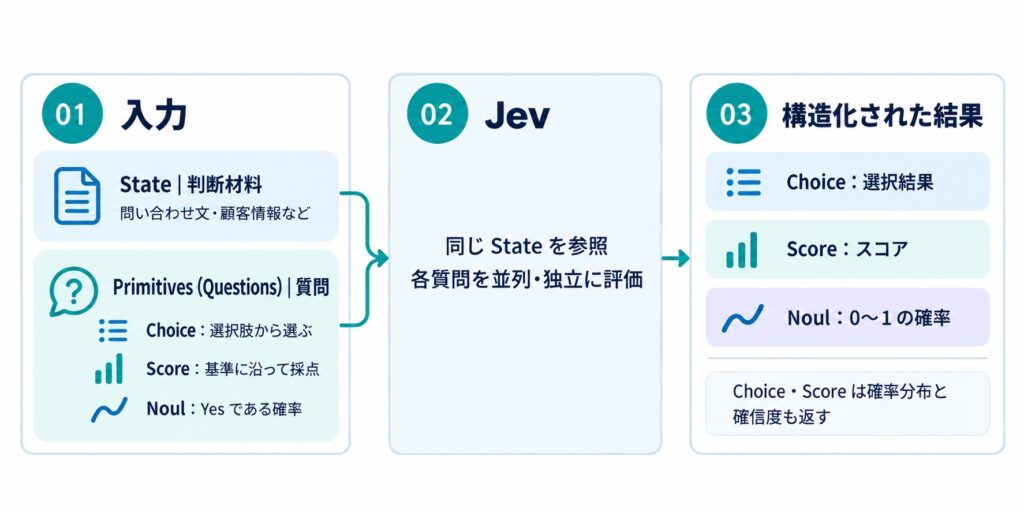
Jevはこの考えを応用し、文章を生成して対話するのではなく、判断を下すことに特化しています。入力として状態 (State) と質問 (Questions) を受け取り、判断をJSON形式の構造化データとして返します。質問の型はPrimitivesと呼ばれ、Choice、Score、Noulの3種類が用意されています。Noulとは一体何語だろうかと思ったのですが、これは2値の判断を表すもので、Bernoulliの略だそうです(参考:Hacker News https://news.ycombinator.com/item?id=49718407)。重要な点として、単純に判断を下すだけでなく、その確信度(confidence)と確率分布(probabilities)も返す点にあります。確信度が高い場合は、その判断をそのまま採用し、低い場合は人間が介入して判断を補完する、といった運用も可能です。
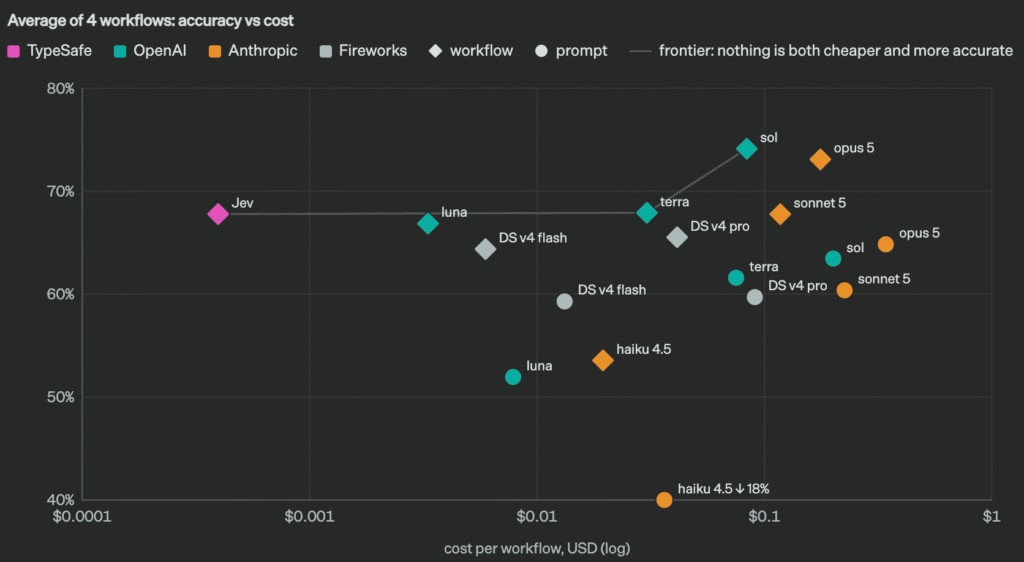
従来のLLMでも、Structured Outputを用いれば構造化された判断を行えます。ですが、あくまで文章生成を前提とするLLMと比べ、JevはJSONで構造化されたデータ出力に特化しており、より高速かつ低コストでこなせる、というのが売り文句です。Jevの精度とコストを他のモデルと比較した結果が以下の図で、横軸がlogスケールのコスト、縦軸が精度を示しています。OpenAIのGPT-5.6 TerraやAnthropicのClaude Sonnet 5に匹敵する精度(Geminiは何処へ)を保ちながら、コストは2桁以上低い、という位置取りになっています。
Jevのスペックについて、以下に整理しておきます。
- コンテキストウィンドウ:リクエストあたり64,000トークン、Stateと最大長の質問の合計32,000トークン
- 入力:テキストのみで画像などは非対応
- 入力コスト:$0.042 / 1Mトークン
- 出力コスト:無料
- 速度:End-to-end response time 70ms-500ms(40-200倍一般的なLLMより高速とのこと)
出力が短い構造化データということもあり、出力コストは無視できるレベル (too cheap to meter) として無料になっているのがおもしろい点です。too cheap to meter つまり「わざわざ測定するには安すぎる」とのことで、元は原子力発電のコストの見通しについての(楽観視する立場からの)演説で使われた表現だそうです(Wikipedia: Too cheap to meter)。まあ現実はそう甘くはなく、電気代と同じように生成AIサービスの利用も従量課金が主流で、トークンマネージメントと称して日々コストを気にしなければならないのが世知辛いところです。
また、なぜJevという名前が付けられたかというと、公式ブログに以下の記述があります。
We named Jev after William Stanley Jevons. We expect machine intelligence to follow a similar path to coal, after steam-engine efficiency led to an increase in demand. Every order of magnitude drop in the cost of intelligence unlocks orders of magnitude more use cases.
ウィリアム・スタンレー・ジェヴォンズは、19世紀のイギリスの経済学者で、「ジェボンズのパラドックス」として知られています。これは、技術の進歩によって資源利用の効率が向上すると、消費量は減るどころか逆に増加する、という逆説的な現象を指します。AIの利用コストが下がることにより、更なる利用の拡大を期待しての命名なのでしょうか、これは。
Jevを使ってみる
では、実際にJevを使ってみたいと思います。発表当初、利用にはWaitlist登録が必要でしたが、9/21以降撤廃されております(自分の場合は、Waitlistに深夜に登録すると翌朝には招待メールが届きました)。現在は誰でも利用可能です。公式サイト(https://typesafe.ai)からアカウントを作成してログインすれば、すぐにJevを試すことができます。
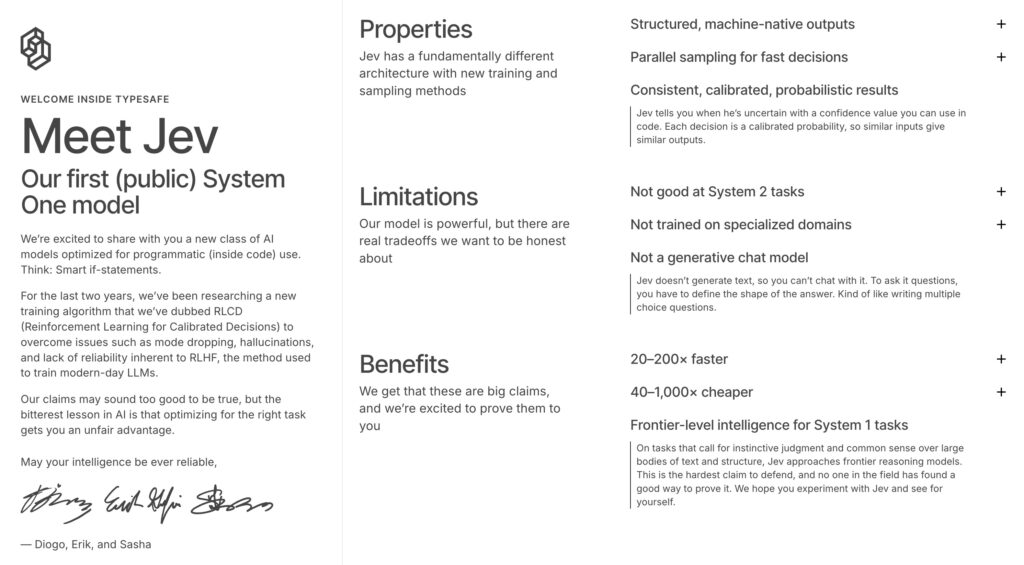
ログインしてみると、以下のようなメッセージが表示され、最初のSystem One Modelであることを強調する内容になっていました。
TypeSafe AIのコンソール(https://console.typesafe.ai/home)にログインすると、そのままPlaygroundにアクセスしてJevを試すことができます。
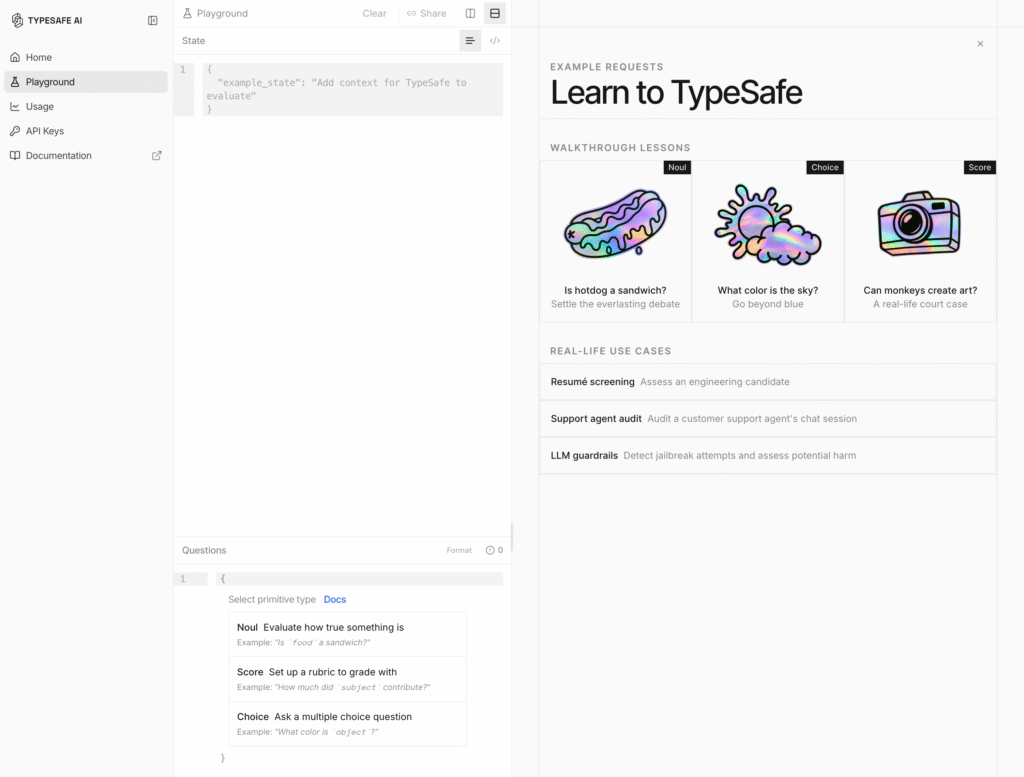
Stateと対応するQuestionsをJSON形式で入力します。Runをクリックすると、Jevがレスポンスを返してくれます。レスポンスの結果は、それぞれのkeyに対応して見やすくまとめられています。実行時間などの情報も合わせて確認できます。Jevに何ができるのかを手を動かして掴むには、ちょうど良い場所です。
まずは、stateを定義します。料理店のレビューを例にしてみます(なお、以下の例題の文章などはすべてClaudeに生成してもらったもので、他意はありません)。
{
    "review": "駅から近くて入りやすいお店でした。パスタは熱々で味も良かったです。ただ、注文してから出てくるまで40分待たされ、店員さんに聞いても謝ってもらえませんでした。味は好きなので、空いている時間ならまた行きたいです。"
}
このstateに関して、NoulやChoice、Scoreなどの質問を定義してJevに投げることができます。まず、再訪したいかの質問を定義してみます。Optionとしてcriteriaを使い、true/falseの条件の設定が可能です。
{
    "revisit": {
        "type": "noul",
        "instructions": "このレビューを書いた人は、また来店したいと思っているか?",
        "criteria": {
            "true": "また行きたい意向がある(時間帯や混雑などの条件付きでも yes)",
            "false": "再訪の意向がない、または再訪について何も書かれていない"
        }
    }
}
次に不満点をmain_complaintとしてChoiceで定義します。
{
    "main_complaint": {
        "type": "choice",
        "instructions": "`review` で最も強く不満が述べられている点はどれか?",
        "criteria": {
            "料理の味": "料理の味やクオリティに対する不満",
            "待ち時間": "提供の遅さや待たされたことへの不満",
            "接客態度": "店員の対応や態度への不満",
            "価格": "値段が高いことへの不満",
            "不満はない": "不満が述べられていない"
        }
    }
}
最後に、満足度に関してsatisfactionとしてScoreで定義します。
{
    "satisfaction": {
        "type": "score",
        "instructions": "このレビュー全体の満足度はどれくらいか?",
        "criteria": [
            "強い不満のみが書かれており、良い点への言及がない",
            "不満が中心だが、良い点への言及も少しある",
            "良い点と不満が同程度に書かれている",
            "おおむね満足しているが、気になる点も書かれている",
            "満足のみが書かれており、不満への言及がない"
        ]
    }
}
以上の定義されたStateとQuestionsを使って、Jevにレビューの分析を依頼することができます。Playgroundの該当する入力欄にコピーして実行することで、Jevの動作を確認できます。
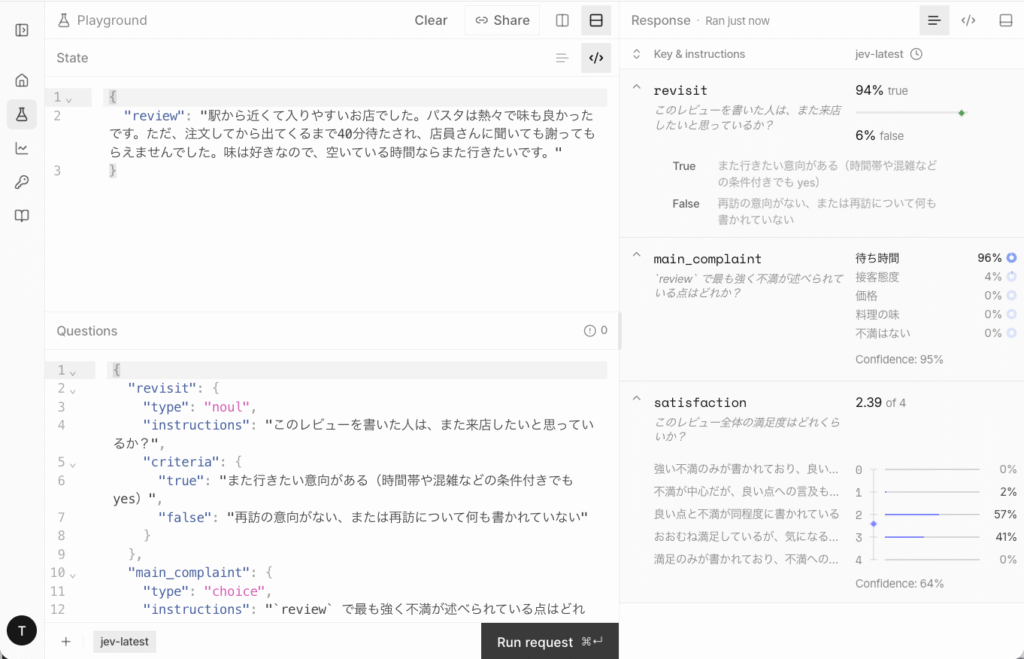
結果を確認すると、「味は好きなので、空いている時間ならまた行きたいです」と書かれているだけあって、再訪の確率は94%と高くなっています。不満に関しては、待ち時間が長いというコメントを反映して、待ち時間が最も大きな不満として抽出されています。この確信度も95%と高くなっています。一方で、全体の満足度に関しては、4点中2.39点と良い点と不満が同等に書かれているので、評価は中立的であると言えます。ただ、この判定に関しては確信度が64%とやや低めであることに注意が必要です。
JSONでの出力結果は以下の通りです。
{
    "model": "jev-1.13.0",
    "answers": {
        "revisit": {
            "type": "noul",
            "noul": 0.94,
            "stats": {}
        },
        "main_complaint": {
            "type": "choice",
            "choice": "待ち時間",
            "confidence": 0.95,
            "probabilities": {
                "価格": 0,
                "待ち時間": 0.96,
                "料理の味": 0,
                "不満はない": 0,
                "接客態度": 0.04
            },
            "stats": {}
        },
        "satisfaction": {
            "type": "score",
            "score": 2.39,
            "legend": {
                "0": "強い不満のみが書かれており、良い点への言及がない",
                "1": "不満が中心だが、良い点への言及も少しある",
                "2": "良い点と不満が同程度に書かれている",
                "3": "おおむね満足しているが、気になる点も書かれている",
                "4": "満足のみが書かれており、不満への言及がない"
            },
            "confidence": 0.64,
            "probabilities": {
                "0": 0,
                "1": 0.02,
                "2": 0.57,
                "3": 0.41,
                "4": 0
            },
            "stats": {}
        }
    },
    "usage": {
        "input_tokens": 819,
        "output_tokens": 106
    },
    "request_id": "playground_1ee874aa3281c4d43aa87c92a1275be27b5",
    "evaluation_time_ms": 184.29922001087107
}
Python SDKでJevを使ってみる
ここでは、Python SDKを使ってJevを動かしてみます。インストールは簡単です。
uv add typesafe-sdk
コンソールからAPIキーを取得して環境変数TYPESAFE_API_KEYに設定しておきます。ECサイトへのレビューを分析するユースケースを例に進めていきます。
from dotenv import load_dotenv
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

load_dotenv()

with TypeSafeClient() as client:
    response = client.system_one(
        state={
            "document": (
                "使い始めて2週間ですが、バッテリーの持ちが悪く、説明書通りの充電時間でも"
                "半日しか持ちません。ただ、デザインは気に入っているので手放すつもりはないです。"
            )
        },
        questions={
            "recommend": Noul(
                instructions="このレビュアーは他の人にこの商品を勧めると思われますか?"
            ),
            "main_complaint": Choice(
                instructions="レビュー内で述べられている主な不満点のカテゴリはどれですか?",
                criteria={
                    "品質・耐久性": "破損、故障、経年劣化、作りの粗さなど本体そのものの品質に関する不満",
                    "機能・性能(バッテリー等)": "バッテリー持ち、動作速度、機能不足など性能面の不満",
                    "価格": "価格が高い、割高に感じるなどコストに関する不満",
                    "配送・梱包": "配送の遅延、梱包の破損、誤配送など受け取りに関する不満",
                    "カスタマーサポート": "問い合わせ対応、返品・交換対応など事業者側の対応に関する不満",
                    "特になし": "明確な不満点が述べられていない、または肯定的な内容のみ",
                },
            ),
            "satisfaction": Score(
                instructions="このレビュアーの総合的な満足度はどれくらいですか?",
                criteria=["非常に不満", "不満", "普通", "満足", "非常に満足"],
            ),
        },
    )

recommend = response.nouls["recommend"]
main_complaint = response.choices["main_complaint"]
satisfaction = response.scores["satisfaction"]

nearest_level = min(satisfaction.legend, key=lambda level: abs(level - satisfaction.score))

print(f"推奨度 (recommend): 他人に勧める確率 {recommend.noul:.0%}")
print(
    f"主な不満点 (main_complaint): 「{main_complaint.choice}」"
    f"(確信度 {main_complaint.confidence:.0%})"
)
print(
    f"満足度 (satisfaction): スコア {satisfaction.score:.2f}"
    f"(0={satisfaction.legend[0]} 〜 {max(satisfaction.legend)}={satisfaction.legend[max(satisfaction.legend)]})"
    f" → 「{satisfaction.legend[nearest_level]}」に最も近い"
    f"(確信度 {satisfaction.confidence:.0%})"
)
print("satisfaction 内訳:", {satisfaction.legend[k]: f"{v:.0%}" for k, v in satisfaction.probabilities.items()})
以下のレビュアーコメントをStateとして与えます。
レビュアーコメント:使い始めて2週間ですが、バッテリーの持ちが悪く、説明書通りの充電時間でも半日しか持ちません。ただ、デザインは気に入っているので手放すつもりはないです。
どんなガジェットか存じませんが、2週間でそこまでバッテリーがへたるのなら手放した方が良い気もします。上記のコードは、このコメントを以下の3つの観点で分類するようにPrimitivesを定義しています。
- 推奨度 (
recommend):他の人に勧めるかどうかを表すNoulによる0-1の確率値 - 主な不満点 (
main_complaint):不満点のカテゴリを選ぶChoiceによる選択肢 - 満足度 (
satisfaction):5段階の満足度としてScoreによる評価
さて、実行してみましょう。結果は以下の通りです。
$ time python product_review_analysis_ja.py
推奨度 (recommend): 他人に勧める確率 30%
主な不満点 (main_complaint): 「機能・性能(バッテリー等)」(確信度 100%)
満足度 (satisfaction): スコア 1.47(0=非常に不満 〜 4=非常に満足) → 「不満」に最も近い(確信度 61%)
satisfaction 内訳: {'非常に不満': '0%', '不満': '54%', '普通': '46%', '満足': '0%', '非常に満足': '0%'}
python product_review_analysis_ja.py  0.15s user 0.07s system 22% cpu 0.954 total
やはり人に勧める度合いは低いようです。評価も良い点・悪い点の差し引きで「不満」となっています。評価はともかく、実行時間は非常に短く一瞬で回答が生成されます。
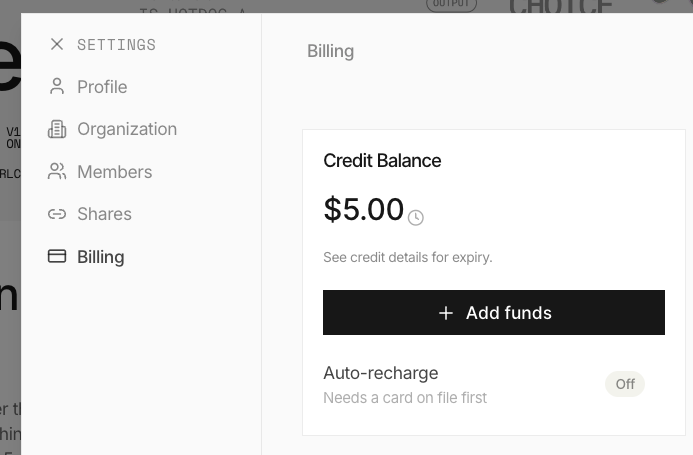
API利用は有料だったはずですが、何も気にせずAPIキーを使ったら動いてしまいました。Billingを確認すると、いつの間にか$5.00が入金されていました。どうも初回の無料クレジットがサービスで提供されているようですね。
もう少し実験をしてみます。以前のブログ「gpt-oss-safeguard: OpenAIのポリシーベースのテキスト分類専用の推論型オープンモデル」で、ローカルLLMによるテキスト分類の実験をしたので、そのECサイト問い合わせタスクをJevで再現してみます。
    response = client.system_one(
        state={
            "document": document,
            "policy": ESCALATION_POLICY,
        },
        questions={
            "escalation": Noul(
                instructions=(
                    "`state.policy` に定義された基準に照らし、`state.document` の問い合わせは"
                    "緊急対応(エスカレーション)が必要ですか?"
                ),
            ),
            "reason_category": Choice(
                instructions=(
                    "`state.policy` の基準のうち、`state.document` の問い合わせに"
                    "最も当てはまる理由のカテゴリはどれですか?"
                    "エスカレーション不要な場合は「該当なし」を選んでください。"
                ),
                criteria=REASON_CRITERIA,
            ),
        },
    )
stateには、問い合わせ内容に加えて、エスカレーションポリシーを含めます。Primitivesとしては、次の2種類を用います。escalation は、問い合わせが緊急対応(エスカレーション)を必要とするかどうかの判断結果、reason_category は、エスカレーションが必要な場合の理由のカテゴリです。このエスカレーションポリシーと判断基準は以下の通りです。
ESCALATION_POLICY = (
    "緊急対応必要: 金銭的損害、セキュリティリスク、法的問題、または24時間以内の対応が必要な問い合わせ。\n"
    "通常対応: 一般的な質問、要望、軽微な不具合報告で、標準的な対応時間(1-3営業日)で処理可能な問い合わせ。\n"
    "\n"
    "緊急対応(Label 1)に該当する内容:\n"
    "- 不正利用の疑い(アカウント乗っ取り、不正注文、クレジットカード不正使用)に関する報告\n"
    "- 商品の安全性に関わる問題(健康被害、怪我、アレルギー反応)の報告\n"
    "- 高額注文(10万円以上)でのトラブルまたは配送事故\n"
    "- 法的措置をほのめかす内容、または消費者センター等への相談を明言\n"
    "- 同一顧客から同じ問題について3回以上の問い合わせ、または強い感情的表現(怒り、失望)を含む内容\n"
    "\n"
    "通常対応(Label 0)に該当する内容:\n"
    "- 商品の在庫確認、配送状況の確認、注文方法についての質問\n"
    "- 返品・交換の通常手続き(商品到着後7日以内、未使用品)\n"
    "- ポイントやクーポンの使用方法、有効期限についての問い合わせ\n"
    "- 商品仕様、サイズ、色についての一般的な質問\n"
    "- 会員登録、パスワードリセット等の基本的なアカウント操作支援"
)

REASON_CRITERIA = {
    "不正利用の疑い(アカウント乗っ取り・不正注文・クレジットカード不正使用)": (
        "身に覚えのない注文、パスワード/アカウントの乗っ取り、クレジットカードの不正利用など"
        "セキュリティに関する報告"
    ),
    "商品安全性の問題(健康被害・怪我・アレルギー反応)": (
        "商品の使用による健康被害、怪我、アレルギー反応など安全性に関わる報告"
    ),
    "高額(10万円以上)注文トラブル・配送事故": (
        "注文金額が10万円以上の商品での誤配送、商品違い、二重請求などのトラブル"
    ),
    "法的措置の示唆・消費者センター等への相談言及": (
        "消費者センターへの相談、法的措置、SNSでの拡散など企業リスクをほのめかす発言"
    ),
    "反復問い合わせ(3回以上)・強い感情的表現": (
        "同一顧客から同じ問題について3回以上の問い合わせ、または怒り・失望などの強い感情表現"
    ),
    "該当なし(通常対応)": (
        "在庫確認、配送状況確認、返品・交換の通常手続き、ポイント使用法など、"
        "上記のいずれにも該当しない一般的な問い合わせ"
    ),
}
実際のサンプルを元に分類を実行してみます。予め想定されるラベルを設定しておき、その一致度も検証しています。
-> % time python ec_inquiry_escalation_jev.py
--- 入力(1) (記事の期待値: Label 1) ---
document: 注文番号#2024-5551234の件で4回目の連絡です!!先週から何度も問い合わせているのに、まともな回答がありません。15万円の高級時計を注文したのに、届いたのは全く違う安物の時計でした。もう我慢の限界です。今すぐ責任者を出してください。SNSで拡散することも考えています。
escalation (Yes確率): 0.98 -> predicted Label 1
reason_category: 高額(10万円以上)注文トラブル・配送事故

--- 入力(2) (記事の期待値: Label 0) ---
document: お世話になります。来月旅行に行くので、Mサイズのスーツケースを探しています。商品番号TR-789の在庫はありますか?また、色はネイビーとブラックどちらがおすすめでしょうか?空港での預け入れサイズに対応しているかも教えてください。
escalation (Yes確率): 0.03 -> predicted Label 0
reason_category: 該当なし(通常対応)

--- 入力(3) (記事の期待値: Label 1) ---
document: 大至急確認をお願いします!!今朝、身に覚えのない注文確認メールが5件も届きました。私のアカウントで合計30万円以上の家電製品が注文されています。すぐにキャンセルしてください。パスワードは変更しましたが、クレジットカード会社にも連絡した方がいいでしょうか?不正アクセスされたようで怖いです。
escalation (Yes確率): 0.98 -> predicted Label 1
reason_category: 不正利用の疑い(アカウント乗っ取り・不正注文・クレジットカード不正使用)

--- 入力(4) (記事の期待値: Label 0) ---
document: 先週のセールで購入したワンピースについて質問です。洗濯表示を見たらドライクリーニング推奨となっていますが、自宅で手洗いは可能でしょうか?素材はポリエステル60%、レーヨン40%です。また、アイロンをかける際の温度設定も教えていただけますか?
escalation (Yes確率): 0.04 -> predicted Label 0
reason_category: 該当なし(通常対応)

--- 入力(5) (記事の期待値: Label 1) ---
document: 息子が貴社で購入したプラモデルの小さな部品を誤って飲み込んでしまい、現在救急病院にいます。商品には3歳以上と書いてありましたが、こんな小さな部品が入っているとは思いませんでした。対象年齢の表示に問題があるのではないでしょうか。病院の診断書も準備しています。製造物責任について御社の見解を聞かせてください。
escalation (Yes確率): 0.98 -> predicted Label 1
reason_category: 商品安全性の問題(健康被害・怪我・アレルギー反応)

=== 一致率: 5/5 ===
[OK] 入力(1): expected=1 predicted=1
[OK] 入力(2): expected=0 predicted=0
[OK] 入力(3): expected=1 predicted=1
[OK] 入力(4): expected=0 predicted=0
[OK] 入力(5): expected=1 predicted=1
python ec_inquiry_escalation_jev.py  0.28s user 0.11s system 19% cpu 2.006 total
やはり一瞬で判断が下されます。System One Modelsと謳うだけありますね。せっかくなので、同様の分類タスクをローカルLLMでも実行して比較してみます。gpt-oss-safeguardを使うのも今更なので、より新しい gemma-4-e4bを試してみます。
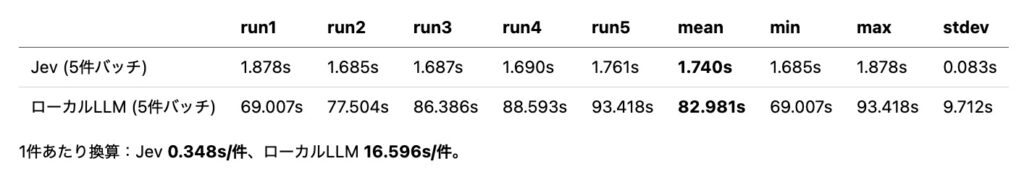
System promptにロールを与えて、response schemaを定義し、その形式に従ってLLMからの応答を取得する形にします。それぞれ5回実行し、平均・最小・最大・標準偏差を比較しました(ローカル実行環境としてMacBook Pro M1 Maxを使用)。結果は以下の通りで、Jevは50倍近い速度差があることがわかります。
なお、公式のAgent skillも公開されているので、興味がある方はそちらも試してみると良いでしょう(typesafe-ai/skills [GitHub])。Claudeの場合以下のコマンドで追加・インストールが可能です。
$ claude plugin marketplace add typesafe-ai/skills
$ claude plugin install typesafe@typesafe-ai
Claude Code以外のエージェントを使っている場合は、以下の指示をそのまま渡せば、インストールまで済ませてくれます。
Install the TypeSafe skill. If you’re in Claude Code, run `claude plugin marketplace add typesafe-ai/skills`, then `claude plugin install typesafe@typesafe-ai`. If you’re in another agent, run `npx skills add typesafe-ai/skills –skill typesafe-ai` and select your agent. Use one installation method. You can read the skill directly at https://github.com/typesafe-ai/skills/blob/main/skills/typesafe-ai/SKILL.md (raw: https://raw.githubusercontent.com/typesafe-ai/skills/main/skills/typesafe-ai/SKILL.md). Then use the TypeSafe skill when working on this project.
Skillsをインストールすれば、以下のようにJevのAPIのクエリーを簡単に作成できます。
TypeSafe APIを利用したシンプルなクエリーの例を作成してください
Jevの技術要素について
最後にJevの技術要素について触れておきます。LLMの学習プロセスは、主に事前学習と、その後の複数段階のファインチューニングからなります。このうちRLHF(Reinforcement Learning from Human Feedback、人間のフィードバックを用いた強化学習)は、人の好む出力を強化するために用いられ、これによってChatGPTのような自然な対話が可能になりました。 RLHF自体は Christiano et al. (2017) の Deep Reinforcement Learning from Human Preferences が原典ですが、これを言語モデルの指示追従に適用して広く知られるようにしたのがInstructGPTとChatGPTで、TypeSafe AIの共同創設者である Diogo Almeida もその開発に貢献しています。
もう一つのRLVR(Reinforcement Learning with Verifiable Rewards、検証可能な報酬を用いた強化学習)は、モデルの出力が正しいかどうかを検証し、その結果に基づいて報酬を与えることで、より信頼性の高い学習を実現します。この種の報酬を元にした推論強化型のモデルはOpenAIのo1などで導入され、今日の高度なLLMの基盤となっています。
Jevは、これら従来の強化学習手法ではなく、「Reinforcement Learning for Calibrated Decisions(RLCD、較正された意思決定のための強化学習)」を採用しています。RLCDは、テキストを生成するのではなく、判断とその確率を出力することに最適化された手法です。出力される確率が高いほど、その判断が実際に正しい可能性も高い、という対応関係(較正、Calibration)が保たれるように学習されます。RLHFでは人の好みに迎合するバイアスが生じやすいのに対し、RLCDでは較正そのものが目的となるため、こうしたバイアスの影響を抑えられると説明されています。
まとめ
今回は、TypeSafe AIが発表した最初の「System One Models」である新モデルJevを紹介しました。従来のLLMが、時間をかけて深く考えるSystem Twoの方向で推論性能を高めてきたのに対し、Jevは直感的・瞬間的な判断であるSystem Oneに振り切り、状態と3種類の質問に対して構造化された判断だけを返します。テキストを生成しないと割り切ったことで、応答時間も70ms-500msという桁違いの速さに収まっています。
実際に触ってみた範囲でも、レビュー分析やECサイトの問い合わせ分類といったタスクは十分にこなせており、ローカルLLMとの比較では50倍近い速度差が出ました。「対話しないAIモデル」という思い切った割り切りは、用途によっては非常に有効で、特にリアルタイム性が求められる判断や、大量のデータを迅速に処理する場面で威力を発揮しそうです。確信度が同時に出力されるため、信頼性が低い場合、人がフォローに回るワークフローを構築するなどの運用も可能です。
最後に
グループ研究開発本部 AI研究開発室では、データサイエンティスト/機械学習エンジニアを募集しています。ビッグデータの解析業務などAI研究開発室にご興味を持って頂ける方がいらっしゃいましたら、ぜひ募集職種一覧からご応募をお願いします。皆さんのご応募をお待ちしています。
参考資料
- Introducing System One Models & Jev – TypeSafe AI Blog
- Machine Learning Primer – TypeSafe AI
- typesafe-ai/skills [GitHub]
- TypeSafe AI Emerges From Stealth With $40M in Funding With New Model for Composable AI – Morningstar
- Introducing System One Models and Jev – Hacker News
- Paul F. Christiano et al., Deep Reinforcement Learning from Human Preferences (2017)
- Wikipedia: Too cheap to meter
- gpt-oss-safeguard: OpenAIのポリシーベースのテキスト分類専用の推論型オープンモデル

グループ研究開発本部の最新情報をTwitterで配信中です。ぜひフォローください。
Follow @GMO_RD