2026.09.28
LLMに「どっちがタカ派?」を何百回も聞いて、中央銀行の発言をものさしにしてみた
LLMに「どっちがタカ派?」を何百回も聞いて、中央銀行の発言をものさしにしてみた
こんにちは。AI研究開発室のK.S.(女性)です。
最近は金利の動きが話題で、中央銀行の発言が市場に及ぼす影響にも注目が集まっています。こうした動きが私たちの生活にどう関わるのか、気になる方も多いのではないでしょうか。FOMC(米連邦公開市場委員会)の議長や日銀(日本銀行)の総裁の会見が報じられるたび、この先の金利はどうなるのか、株価はどちらに動くのか、つい考えてしまいます。金融の世界では、こうした発言が「今日はタカ派(hawkish、引き締め寄り)だった」「ハト派(dovish、緩和寄り)だった」と評されます。
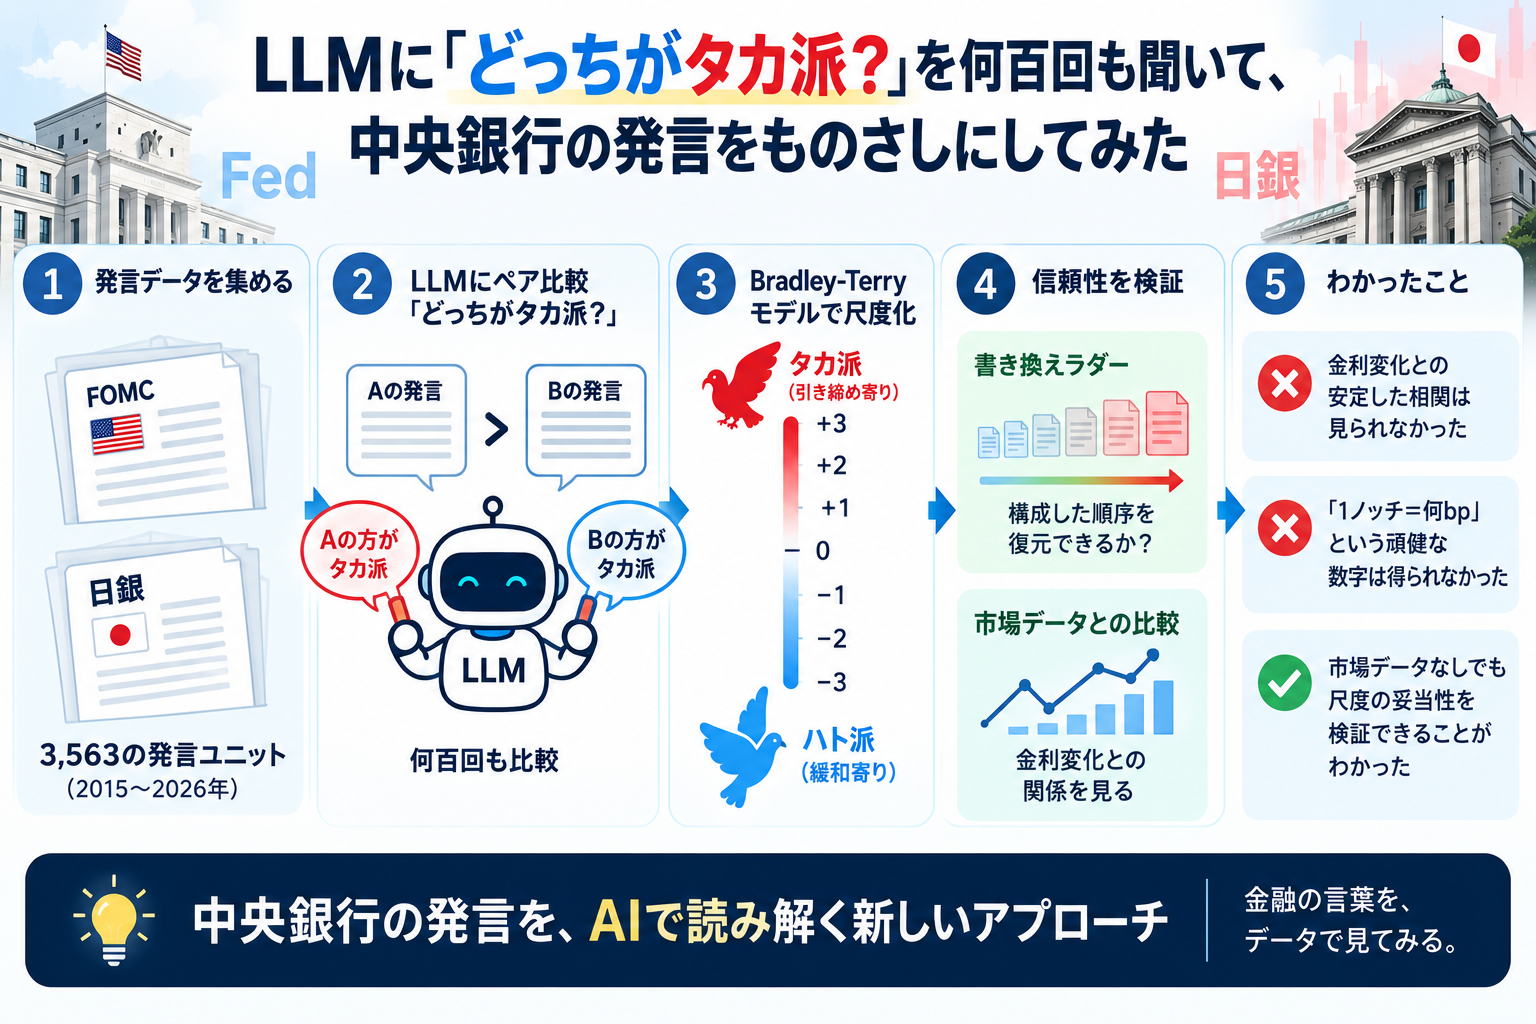
タカ派かハト派かは、本来なら文章のニュアンスを見ながら段階的に並べたいものです。もちろんLLMに直接「1〜10で採点して」と頼むこともできますが、こうして得られる絶対的な点数は驚くほど不安定で、そのまま「ものさし」として使うのは危険です。一方で、「AとBならどちらがよりタカ派か」という相対的な比較は、LLMでも比較的安定して判断できます。そこで今回は、将棋のレーティングなどで使われる「2つを比べて強さを決める」統計モデル(Bradley-Terryモデル)を使い、LLMに声明文のペアを見せて「どっちがタカ派?」を何百回も判定させることで、タカ派度の「ものさし」を作ってみました。作ったものさしが本当に信頼できるのかも、市場データと書き換え実験の両方で検証しています。
本記事は技術的な検証を目的とした個人の検証結果であり、投資助言ではありません。
目次
1. そもそも「タカ派・ハト派」って何?
中央銀行(日本銀行や、アメリカのFRB=連邦準備制度)は、景気と物価のバランスを取るために「政策金利」という金利を上げたり下げたりしています。この金利の上げ下げに対する姿勢を、鳥のたとえで呼ぶのが「タカ派」「ハト派」です。
- タカ派(Hawkish): 「物価が上がりすぎ(インフレ)を抑えたいから、金利を上げよう・高いままにしよう」という立場。タカのように鋭く、リスクに対して攻撃的・積極的に対処するイメージです。
- ハト派(Dovish): 「景気や雇用を支えたいから、金利を下げよう・低いままにしよう」という立場。ハトのように穏やかで、景気を気遣うイメージです。
車の運転にたとえると分かりやすいかもしれません。景気を車のスピード、政策金利をアクセルとブレーキだと考えてみます。景気が良すぎて物価がどんどん上がっている(スピードが出すぎている)ときは、タカ派は「ブレーキ(利上げ)を踏むべきだ」と考えます。逆に景気が弱く、失業が増えそうな(スピードが落ちすぎている)ときは、ハト派は「アクセル(利下げ)を踏むべきだ」と考えます。
金利が変わると、私たちの生活にも影響があります。金利が上がる(タカ派寄りになる)と、銀行預金の利息が増える一方で、住宅ローンなどの借入コストも上がります。株価や為替(円やドルの価値)も動きやすくなります。逆に金利が下がる(ハト派寄りになる)と、お金を借りやすくなって景気を支えやすい一方、(一般的な傾向として)物価が上がりやすくなるという面もあります。
FOMC(FRBの会合)や日銀の会合が終わった後、議長や総裁が記者会見で話す内容が「タカ派的だった」「ハト派的だった」と報じられるのは、この発言から今後の金利の方向性を市場が読み取ろうとしているためです。今回のブログは、この読み取りをLLMにやらせてみた、という話です。
2. 何をやったのか
なぜ単純な方法では測れないのか
LLMに中央銀行の文章をタカ/ハト分類させる研究はすでにあります。例えば、「Can ChatGPT Decipher Fedspeak?」の論文で、ChatGPTにFOMCの文を分類させたり、「From Text to Quantified Insights: A Large-Scale LLM Analysis of Central Bank Communication」の論文で、LLMを使ったりしていました。分類はできても、その数字が「差や間隔に意味のある尺度」になっているかは、個人的に少し疑問がありました。
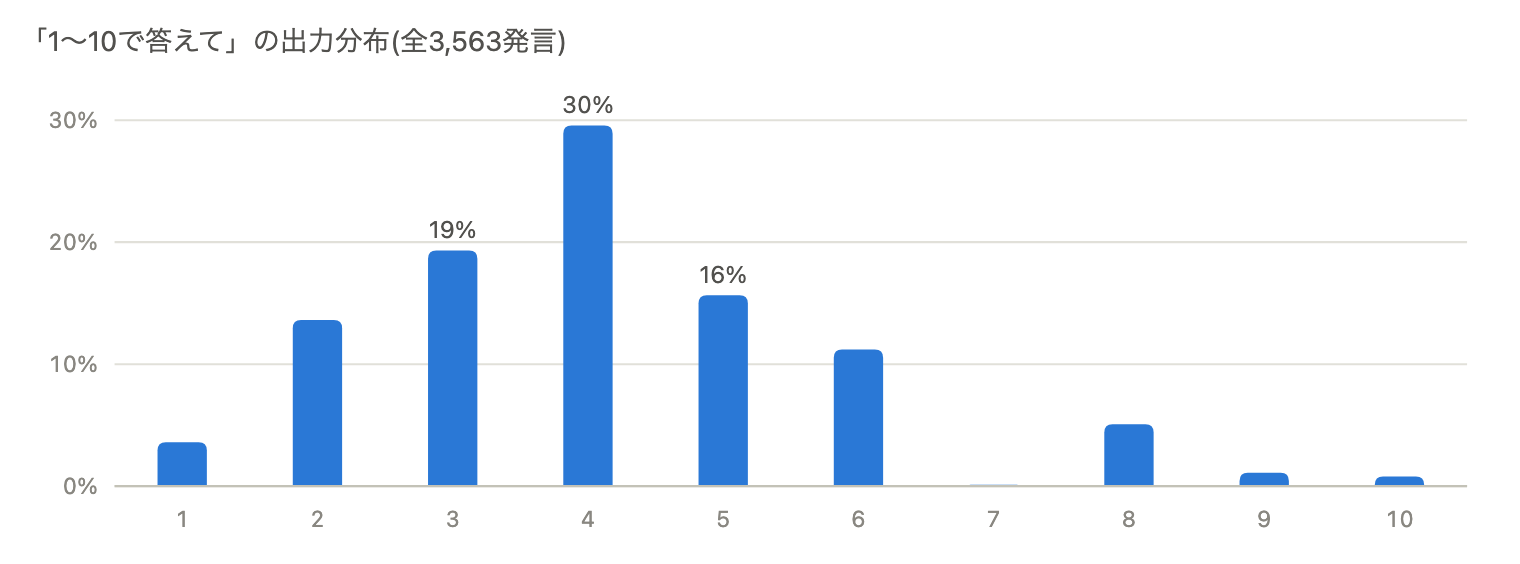
実際に試してみます。まず、採点の最小単位を「発言ユニット」と呼ぶことにします。声明は1件まるごとで1ユニット、記者会見は総裁・議長の回答1つで1ユニットです(質問者の言葉は含めません)。全部で3,563ユニットあり、その1つ1つに対して、採点に使ったローカルのQwen3.5-9Bに「この発言はどれくらいタカ派か、1(非常にハト派)〜10(非常にタカ派)で評価し、数字だけで答えてください」と聞き、返ってきた数字を集計しました。結果、出力は3、4、5の3値だけで全体の65%を占めるという偏った分布になりました。7〜10(強いタカ派寄り)はほとんど使われず、実質3〜5あたりの狭い範囲に潰れています。プロンプトの言い回し次第で簡単に動く、粗い尺度です。
実際に確かめてみる
本当に言い回しだけでスコアが動くのか、実際の発言ユニット1件(2024年9月のFOMC会見でのパウエル議長の回答、839文字)を使って、指示文だけを変えてローカルのQwen3.5-9Bに聞き直してみました。パイプライン本来の指示(「数字だけで答えてください」)では6、同じ指示をもう一度聞いても6(再現性は確認済み)。ここに「市場参加者の視点で答えてください」を足すと8、「物価安定を重視する立場で答えてください」を足しても8になりました。発言の文章は一字も変えていないのに、指示文の言い回しだけでスコアが6から8まで動いています。同じ発言・同じモデルでも、聞き方次第で評価が変わってしまう——これでは、この数字が「その発言がどれくらいタカ派か」を測っているのか、「どう聞いたか」を測っているのか分かりません。絶対評価をそのまま「ものさし」として使うのが危険な理由が、ここにあります。
それでは、この問題をもう少し改善できるかを試してみます。
使ったデータと手法
- データ: FOMC 178件、日銀 169件(声明200件+会見147件、2015〜2026年)。採点の単位に分けると、声明は1件がそのまま1ユニットで200ユニット、会見は1件から質疑応答の回答を取り出すので1会合あたり平均23問、合わせて3,363ユニットになり、全部で3,563ユニットです(質問者の言葉は含めません)。
- モデル: 判定にはQwen3.5-9B(
mlx-community/Qwen3.5-9B-MLX-4bit、4bit量子化)を使いました。Apple Silicon向けのMLXで動かしていて、手元のMac(M5 Max / メモリ36GB)1台で完結します。従量課金のAPIは使っていません。比較用にClaude Code(claude -p --model sonnet、実行時点ではClaude Sonnet 5)も一部の実験で使っています(限界と今後の節)。 - 金利データ: 米国債の利回り(2年・10年)はFRED(セントルイス連銀のデータベース)からCSVで取得しています。日本国債の利回りは財務省が公開している金利情報(全年限の日次データ)を使いました。どちらもAPIキー不要で取得できます。
- 比べる手法: 本命は「2つの声明を見せて『どっちがタカ派?』と聞き、その勝敗から点数を逆算する」やり方です。点数の逆算に使う統計モデルがBradley-Terryモデルで、以下「ペア比較+BT」と呼びます(仕組みは次章で説明します)。これと比べるために、スコアの作り方を3つ用意しました。絶対評価(1〜10)は前述のとおりLLMに数字を直接言わせる方法、辞書はタカ派・ハト派に結びつきやすい単語の出現数の差を数える古典的な方法、logprobは、LLMに答えを書かせるのではなく、モデルの中で「Hawkish」と「Dovish」のどちらを選びそうかという確率を直接のぞき見る方法です。その確率の差をスコアにするので、どちらとも言えない状態がちょうど0になります。それぞれの長所・短所は、検証の結果とあわせて4章の最後で整理します。
全体の流れ
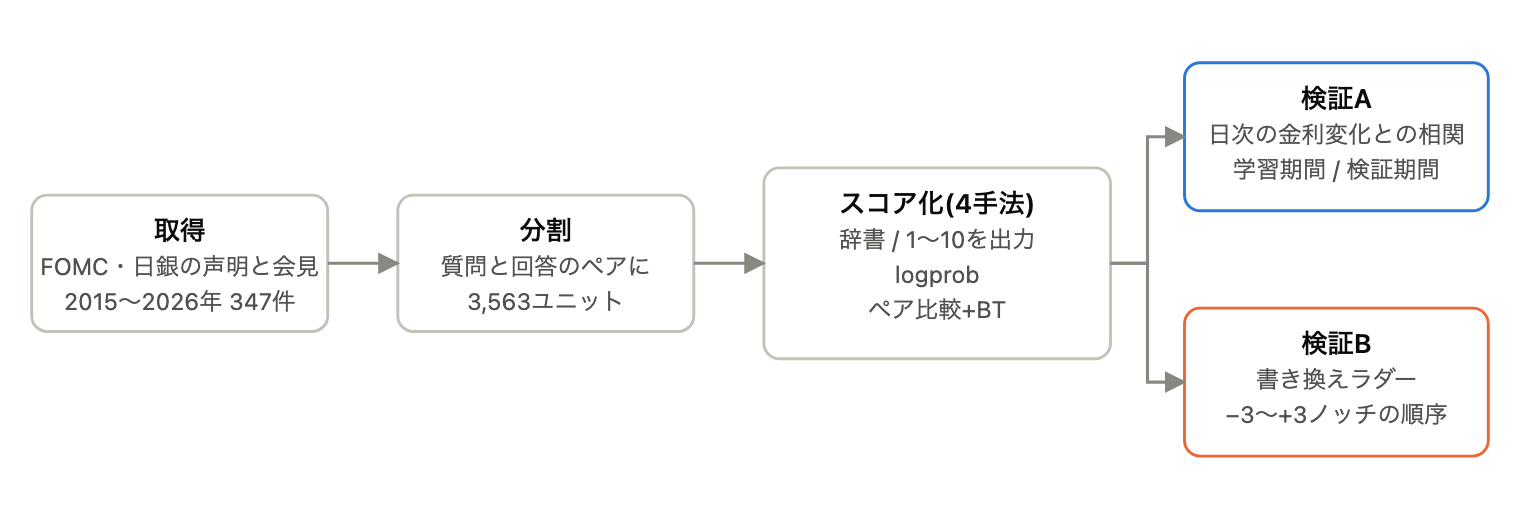
取得した文書を質問と回答のペアに分割し、本命の技術(ペア比較+Bradley-Terry)でスコア化します。そのスコアが信頼できるかを、市場データと書き換え実験の2つで検証する、という流れです。
3. 技術紹介: ペア比較でタカ派度を測る
そもそも「ペア比較」とは
友達2人を並べて「どっちが背が高い?」と聞かれたら、一目で答えられます。でも「Aさんの身長は10段階中の何番目?」と聞かれると、急に困ってしまわないでしょうか。人は(そしてLLMも)、2つを比べて「どちらが上か」を判断するのは得意ですが、1つだけを見て絶対的な数字を付けるのは苦手です。これは心理学でも古くから知られている性質で、「1〜10で答えて」が不安定だったのも、この苦手な方をLLMにやらせていたからだと考えられます。
そこで、声明文も2つずつ組にして「どっちがタカ派?」だけを判定させます。これなら易しい判断の繰り返しになるので、安定しやすくなります。ただし、ペア比較を1回やっただけでは「AはBより少しタカ派」までしか分かりません。これを何百ペアも繰り返した勝敗の記録から、全体を1本の「ものさし」に並べ直す必要があります。そこで使うのが、次に説明するBradley-Terryモデルです。
Bradley-Terryモデルとは
Bradley-Terryモデルは、「AとBのどちらが強いか」という勝敗の記録から、それぞれの強さを数値化する統計モデルです。将棋やチェスのレーティング(Elo)と同じ発想で、スポーツの強さ比較にも古くから使われています。
例えば、将棋の対局を何百局も記録すると、「AさんはBさんに100戦80勝しているから明らかに強い」「CさんとDさんはほぼ五分」というように、勝率のパターンから各人の「強さ」を数値(レーティング)で表せます。しかも、AさんとCさんが直接対局していなくても、AさんはBさんより強く、BさんはCさんより強い、という記録が積み重なれば、AさんとCさんの強さの差もある程度推定できます。声明文の「タカ派度」も同じ発想で、たくさんの「どっちがタカ派?」という勝敗の記録から、各文書の強さを逆算しています。
式で書くと「AがBに勝つ確率=シグモイド(θ_A − θ_B)」で、実際の勝敗の記録がこの式にいちばんよく当てはまるように、各文書のθを逆算します。裏を返すと、θの差は「勝つ確率の対数オッズ」に対応します。差が0なら勝率50%、1なら約73%、2なら約88%、という具合です。単に「8点と6点」と採点するのに比べ、差を確率として解釈できるのが利点です。
では、そのθはどうやって求めるのでしょうか。連立方程式を解いて一発で出る、という類のものではなく、少しずつ動かして探します。
- まず、すべての声明のθを「たたき台」の値に置きます(後述のとおり、logprobのスコアを使います)。
- その時点のθで、各ペアの予測勝率シグモイド(θ_A − θ_B)を計算し、実際の判定結果と比べます。
- ズレを小さくする方向にθを動かします。「勝つはず」と予測したのに負けていた声明はθを下げ、その相手のθを上げる、というイメージです。
- 同時に、たたき台から離れすぎないように引き戻す力も効かせます(正則化)。判定の少ない声明が、わずかな勝敗で大きく飛んでいかないようにするためです。
- 動かしてもズレが減らなくなったら終了。最後に、全体の平均が0になるように平行移動します(差だけが意味を持つので、位置は自由に決められます)。
推定の誤差(標準誤差)も、この解の周りの形から計算できます。θを少し動かしたときにズレが急に増えるなら、その声明の位置はしっかり決まっている=誤差が小さい。逆に、動かしてもズレがあまり変わらないなら、位置は曖昧=誤差が大きい、ということです。比較回数の少ない声明ほど後者になります。
ただし、この尺度には知っておくべき性質があります。
- 絶対的なゼロ点はありません。意味を持つのは差だけです。今回は比べた声明全体の平均が0になるように置いているので、「θがプラスだからタカ派」ではなく「今回比べた同じ中央銀行の声明100件の平均より、タカ派寄り」という読み方になります。
- 分かるのは相対的な位置だけです。どの文書を、誰に、どんな基準で比べさせたかによって結果は変わります。中央銀行をまたいで直接比べることもできないので、FedとBOJは別々に推定しています。
- 間接的な比較には仮定が要ります。AとCを直接比べていなくても、共通の相手Bを介して差を推定できますが、これは「強さが1本の軸で表せる」こと、つまりAがBに強く、BがCに強いのにCがAに強い、といった三すくみが起きないことを前提にしています。
これを踏まえて、今回は次の処理を入れています。並び順による偏りを打ち消すため、ローカルQwenの判定では同じペアをAB・BAの両方向で聞いて平均を取り、Claude Codeの判定では提示順をペアごとにランダムに入れ替えています。また、比較回数が少ない文書ほどθは不確かなので、推定の誤差(標準誤差)もあわせて計算し、あとのグラフでは帯として表示しています。
今回の使い方
声明文を2つ選び、ローカルのQwen3.5-9Bに「どちらがよりタカ派的か」だけを判定させます(絶対評価の「1〜10」は聞きません)。従量課金のAPIは使わず、ローカルで完結します。
ここで問題になるのが、ペア判定の回数です。1件の声明あたり何十回も比較できれば、勝敗の記録だけでθは十分決まります。しかし実際に聞けるのは各行500ペアまでで、1件あたりに直すと平均10回程度。たまたま比較の少なかった声明は、勝敗だけでは位置が決まりません。
そこで、比較を始める前の「たたき台」として、前述のlogprobのスコアを使います。logprobは次のように計算します。まず、タカ派・ハト派の定義を書いたプロンプトに声明文を入れ、「この発言が示すスタンスは A) Hawkish か B) Dovish か、1文字で答えてください」と聞きます。ここで普通なら「A」や「B」という答えを生成させますが、その一歩手前で止めて、モデルが次の1文字として「A」を出す確率と「B」を出す確率を取り出し、その比の対数(対数オッズ)を取ります。プラスならタカ派寄り、マイナスならハト派寄り、0ならどちらとも言えない、という連続値です。これを、選択肢の並び順(A=Hawkish の場合と A=Dovish の場合)の2通りで計算して平均し、並び順による偏りを打ち消します。
このlogprobを中央銀行ごとに標準化した値をθの出発点に置き、そこからペア判定の結果で少しずつ修正していきます。判定が多く集まった声明ほど、たたき台から大きく動きます。逆に判定が少ない声明は、たたき台の近くに留まります(統計の言葉で言うと、MAP推定にあたります。データを見る前の見込み=事前分布と、実際に観測したデータの両方を踏まえて、いちばんありそうな値を選ぶやり方です。ここではlogprobのスコアが事前分布、ペア判定の勝敗が観測データにあたります)。こうすると、少ない判定回数でも全体が破綻しません。
Fed・BOJはそれぞれ約100件の声明があり、全ペアを総当たりすると約4,950ペアと膨大になります。そこで「まだ差がはっきりしていない、情報量の大きいペア」を優先的に選ぶ工夫(能動的ペア選択)を入れ、判定させるのは各行(銀行)最大500ペア(全組み合わせの約1割)に絞っています。
デモ: 実際の指数を見てみる
実際にどう動くのか見てみましょう。声明1件ごとにθ(ローカルQwen判定のペア比較+BTで推定したタカ派度)を推定し、Fed・BOJそれぞれ平均0・標準偏差1になるように標準化してグラフにしました。縦軸はその標準化した値(σ単位)、横軸は声明の日付です。青い帯は推定値の±1標準誤差(SE、推定のブレの大きさ)を示します。時系列で見ると、FedとBOJの既知の転換点で妥当に動いています。
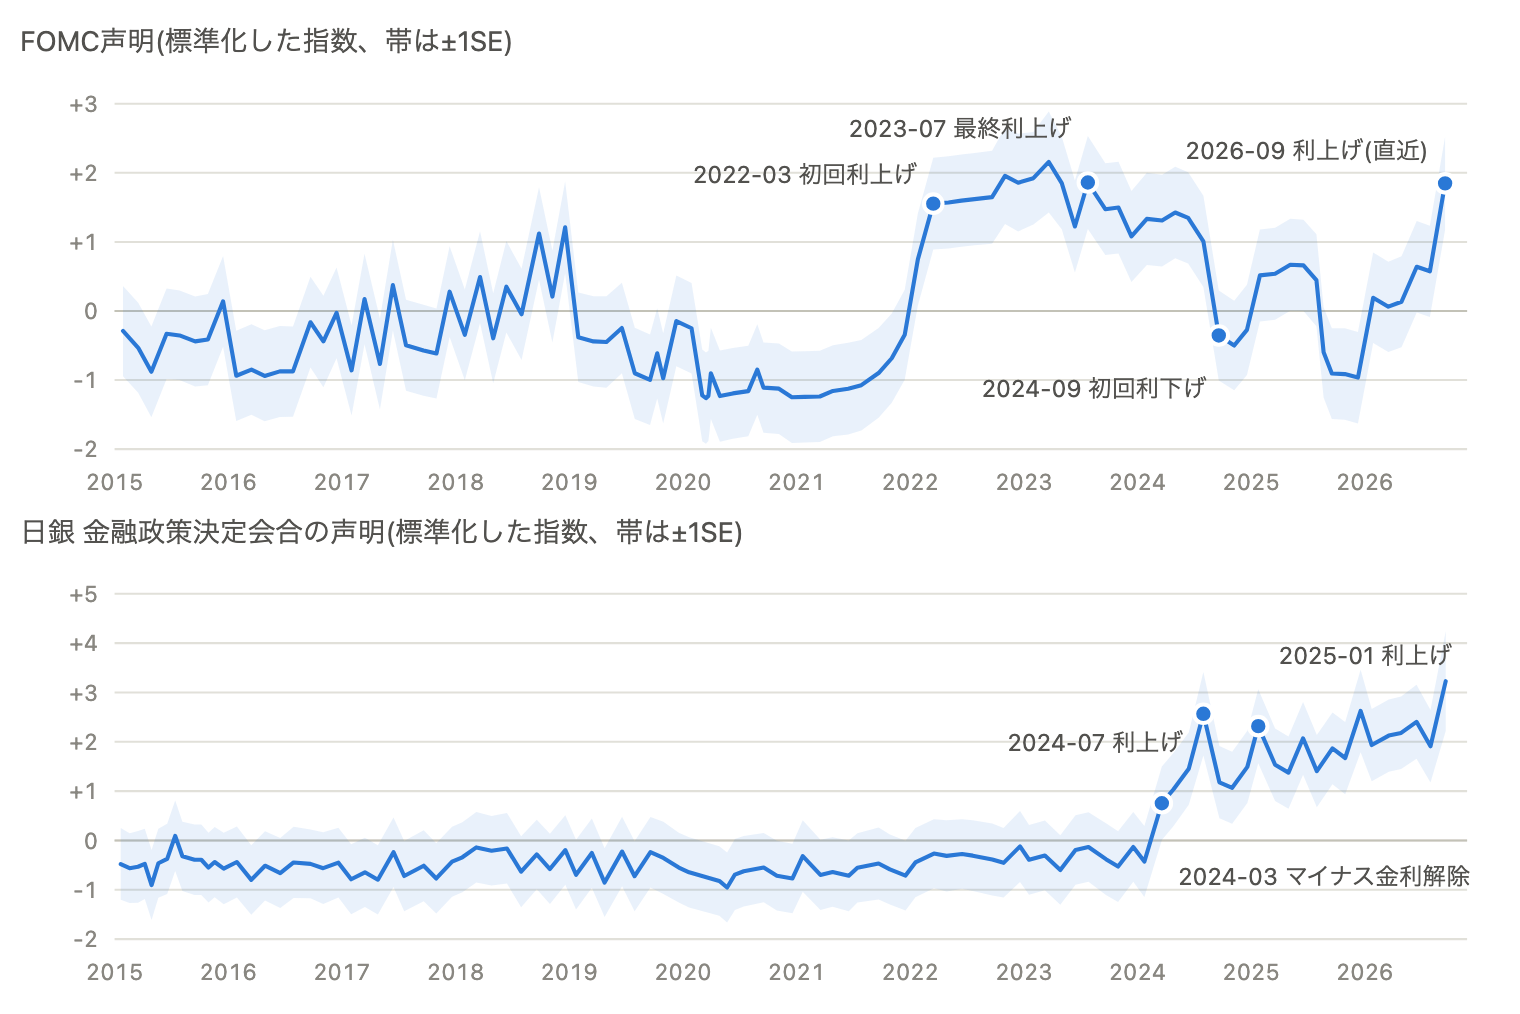
例: グラフ右端の1点を開いてみる(2026年9月16日のFOMC声明)
この回は、実際に政策金利が0.25%(25bp)引き上げられた会合です。声明にも「The Committee decided to raise the target range for the federal funds rate by 1/4 percentage point…(誘導目標を0.25%引き上げることを決定した)」「Inflation remains elevated.(インフレは依然として高い)」といった、はっきりタカ派寄りの文言が並びます。この1件を各手法で採点すると、次のようになりました。
| 手法 | スコア | 順位(1=最もハト派) |
|---|---|---|
| ペア比較+BT(Claude判定) | +2.11 | 86 / 100 |
| ペア比較+BT(Qwen判定) | +1.78 | 94 / 100 |
| logprob(Qwen) | +5.69 | 91 / 100 |
| 1〜10を直接出力(Qwen) | 9.00 | 96 / 100 |
| 辞書ベースライン | +1.00 | 79 / 100 |
5つの手法すべてが、過去100件のFOMC声明の中で上位(よりタカ派寄り)に位置づけました。ペア比較+BTのスコアは平均を0に置いた相対値なので、絶対的な水準ではなく、この順位の方が意味を持ちます。実際の市場も、この日の米2年債利回りが+7bpと上昇しています。つまり、こういう「分かりやすい回」では手法の違いはあまり問題になりません。難しいのは、利上げも利下げもせず、文言のニュアンスだけが変わる大多数の回の方です。
例: 逆に、判定が割れた1点(2026年7月29日のFOMC声明)
こちらは政策金利を据え置いた会合です。ただし賛成9・反対3と票が割れており、声明には「Economic activity is expanding at a solid pace(経済活動は堅調に拡大している)」「Inflation remains elevated relative to the Committee’s 2 percent goal(インフレは2%目標に比べて高い)」というタカ派寄りの文言と、中東情勢による不確実性への言及が同居しています。利上げも利下げもせず、文言のニュアンスだけが動いた回です。
| 手法 | スコア | 順位(1=最もハト派) |
|---|---|---|
| ペア比較+BT(Claude判定) | +2.63 | 95 / 100 |
| ペア比較+BT(Qwen判定) | +0.55 | 73 / 100 |
| logprob(Qwen) | +3.00 | 77 / 100 |
| 1〜10を直接出力(Qwen) | 6.00 | 73 / 100 |
| 辞書ベースライン | +1.00 | 79 / 100 |
同じペア比較+BTでも、ローカルQwen判定では100件中73位なのに対し、Claude Code判定では95位と、かなり離れた評価になりました。しかも市場は逆方向で、この日の米2年債利回りは-4bpと低下しています。文言としてはタカ派寄りでも、市場は「据え置きと3人の反対票」の方を重く見た、という読み方もできます。こうした回が大多数を占めるため、次の章ではきちんとした検証が必要になります。
ただし、これは目視のサニティチェックで、検証ではありません。次の章で、市場データを使わない方法できちんと検証します。
4. 作ったものさしは信頼できるか: 書き換えラダーで検証
ラダーとは
市場データでの検証は、ノイズが大きく標本も少ないため、それだけでは心もとありません。そこで、正解の順序が最初から分かっている「模擬テスト」を別に作りました。1つの実際の声明文を土台に、数値や政策の中身といった事実は変えないまま、タカ派・ハト派の度合いだけをLLMに段階的に書き換えさせます。この「書き換え文」を7段階(「ノッチ」: −3・−2・−1・0・+1・+2・+3)作り、例えば+1は元の声明より少しタカ派寄りに、−3は大きくハト派寄りに書き換えた文になります(0は言い換えのみでスタンスは変えない対照群)。
例えば、2025年9月のFOMC声明の書き出しを書き換えると、−3ノッチでは“growth of economic activity weakened markedly”(経済成長が著しく弱まった、ハト派寄り)に、+3ノッチでは“growth of economic activity remained resilient”(経済成長は底堅い、タカ派寄り)になります。数値や構成はほぼそのままに、書きぶりだけが変わっているのが分かります。
この−3〜+3という並び順は書き換えの指示で決めた「正解」なので、あとからスコアを付けたときにこの順序をどれだけ正しく並べ直せるかを見れば、市場データを使わずにスコアの良し悪しを判定できます。並べ直せた度合いは、Kendallのτという統計量で表します。考え方は単純で、ノッチの組を全て総当たりし(例えば「−3と+1」「0と+2」…)、スコアの大小関係が正解の順序と一致していれば+1、逆なら−1と数えて平均を取ります。全ての組が正しい順に並んでいればτ=1、順序がでたらめならτ≈0、完全に逆順ならτ=−1です。
書き換えには内容保存のガード(数値の完全一致・文字3-gram類似・長さ)をかけ、通らないものは捨てています。日銀の声明はClaude Codeに書き換えさせ(ガード通過率92%)、書き換えるClaudeと採点するQwenは別モデルなので、「自分の文体を再認識するだけ」の自己一致は避けられます。
順序を復元できたのは誰か
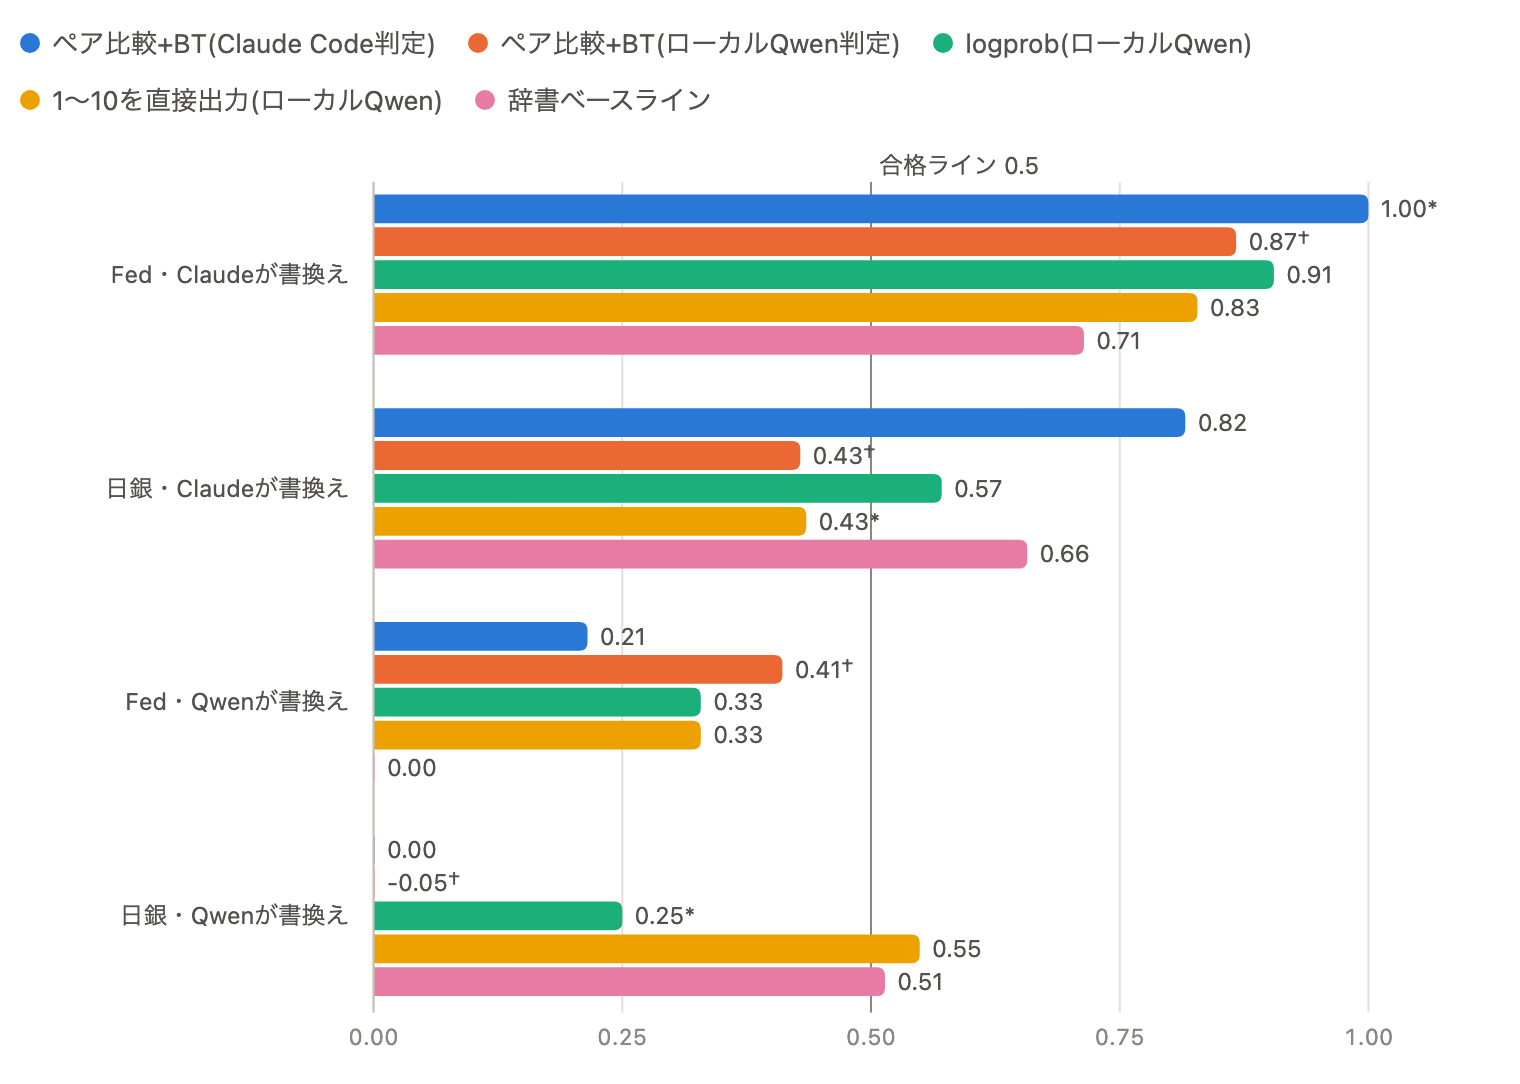
本命のローカルQwen判定でラダーの順序復元を見ると、Fedの声明(Claude書換え)では0.87とよく復元できました(1が完全に順序を復元できた状態です)。一方、日銀の声明(Claude書換え)では0.43、Fedの声明をQwen3.5-9B自身に書き換えさせたラダーでも0.41と、こちらは順序を十分には復元できませんでした。
プラセボ: 書き換えは中立とは限らなかった
ノッチ0(言い換えのみ)の書き換え文を原文と比べると、ローカルのQwen3.5-9B判定では、4つのラダーいずれも0.49〜0.51とほぼ五分でした(日銀・Qwenが書換えは使える基準文が7件のみ)。言い換えただけで原文よりタカ派・ハト派どちらかに寄って見える、という明確な偏りはありません。
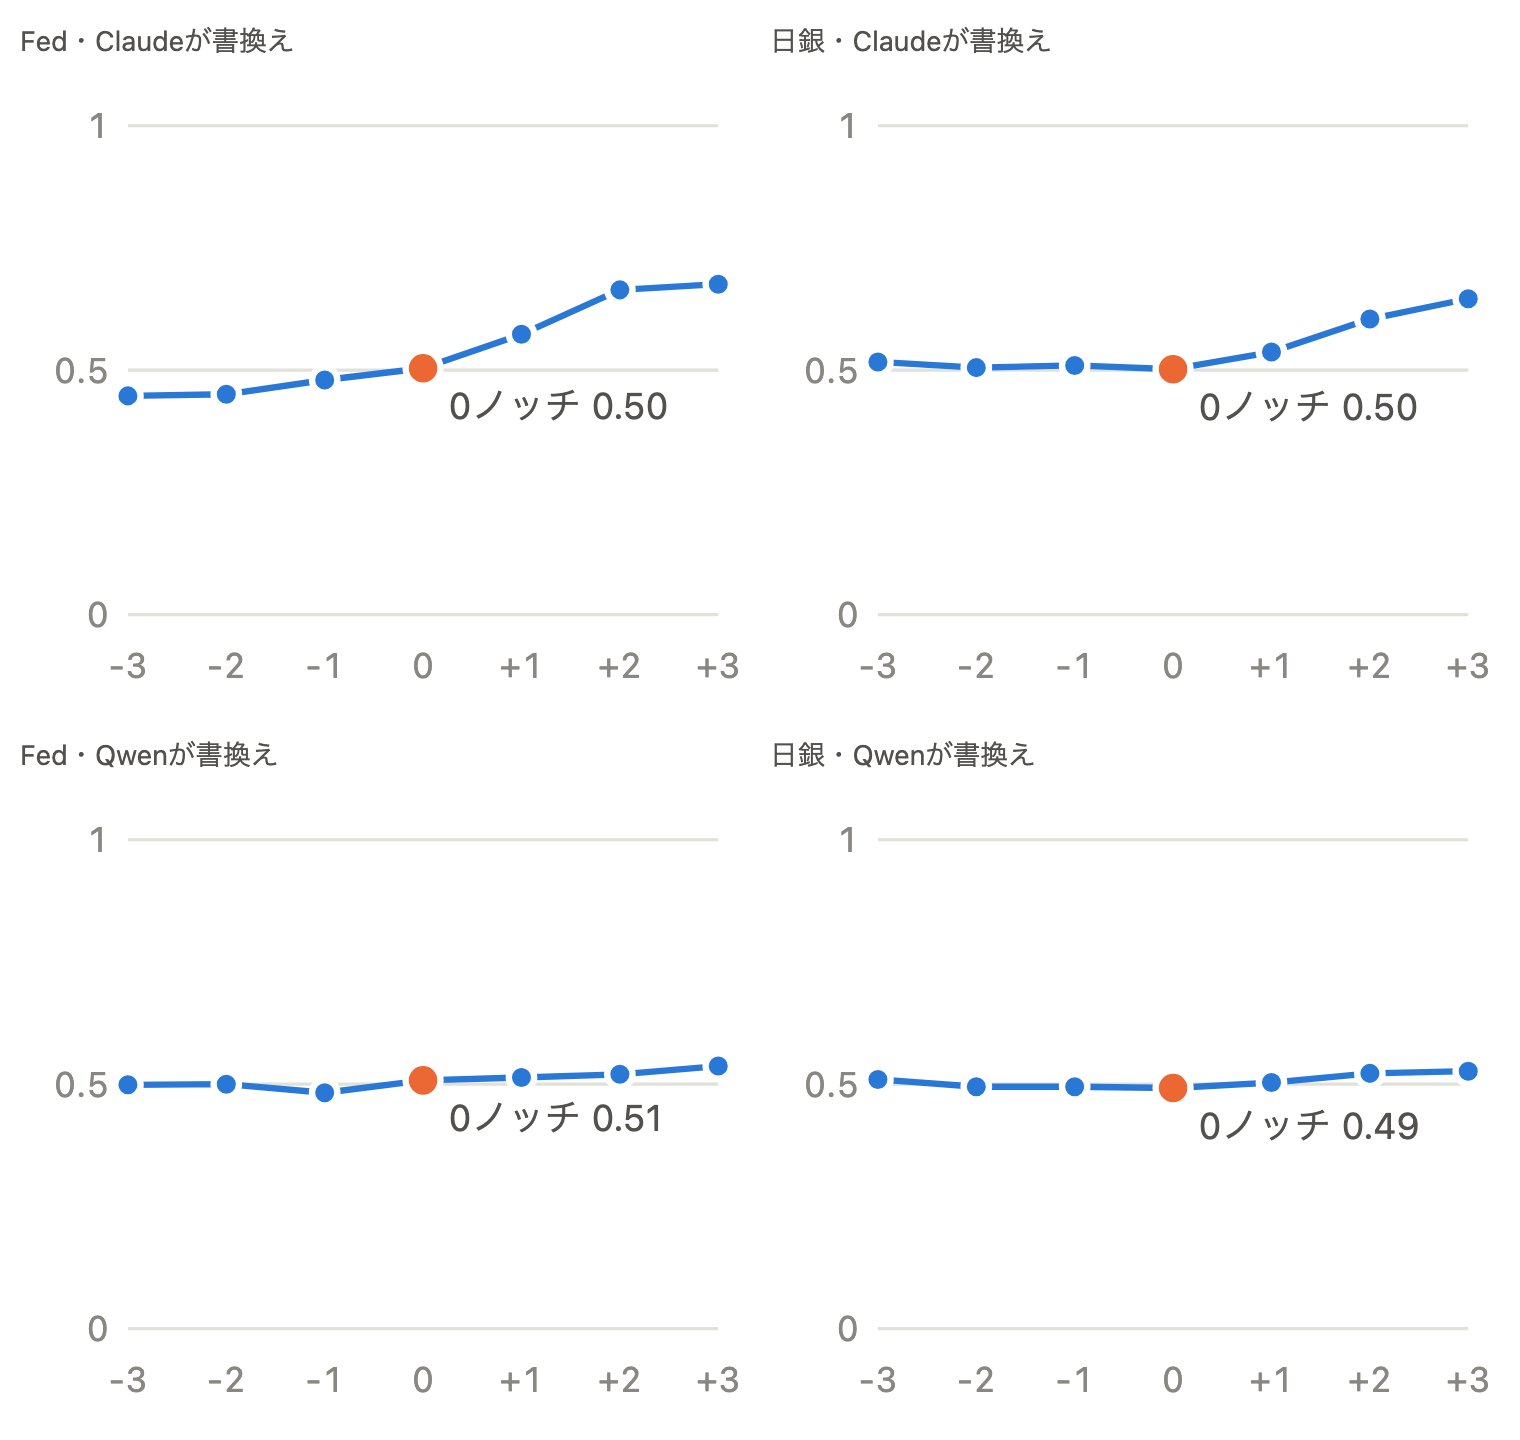
ただし、図を見ると分かるとおり、ノッチが±3まで動いても勝率は0.45〜0.68の範囲にしか広がっておらず、日銀の声明はほぼ0.5に張り付いたままです。プラセボに偏りがないのは良いことですが、同時に「差をきちんと検出できていない」ことの表れでもあります。判定者を強いモデルに変えると、この検出力がどう変わるかは「限界と今後」の節で触れます。
技術選定: 何と比べたか
本命の「ペア比較+BT(ローカルQwen判定)」を、判定者の選び方1つと、スコアの作り方3つ(絶対評価・辞書・logprob)と比べます。判定材料は、ここまで見てきた書き換えラダーで、どれだけ順序を復元できたか(Kendallのτ)の実測値です。
- 判定者: 本命はローカルのQwen3.5-9Bです。良い点は、絶対評価より易しい判断(どっちがタカ派か)だけを聞くので、判定が安定しやすいこと、そして従量課金のAPIを使わずローカルで完結することです。弱い点は、絶対評価に比べれば安定するとはいえ、判定確率が0.5付近に寄りやすく、際立った差が出にくい場面があることです。比較対象として、判定者をClaude Codeに差し替えてみたところ、多くの場面で順序の復元力が上がりました(限界と今後の節で触れます)。
- 絶対評価(1〜10): 前述のとおり出力が粗く、プロンプトの言い回しに弱いです。ペア比較の方が判定は易しく、安定します。
- 辞書: 実装が速く中身も見えますが、文脈や否定を読めません。LLMがどれだけ上積みしたかを測るベースラインとして使いました。
- logprob: もう一つの連続スコアの作り方です。「この発言のスタンスは A) Hawkish か B) Dovish か、1文字で答えてください」と聞いたうえで、答えを書かせる前に、次の1文字が「A」になる確率と「B」になる確率をモデルの内部から読み取り、その比(対数オッズ)をスコアにします。五分五分なら0、タカ派寄りならプラス、ハト派寄りならマイナスと、中立点がはっきりしているのが良い点です(選択肢の並び順による偏りを打ち消すため、AとBを入れ替えた2通りの平均を取っています)。弱い点は、前節のプラセボ実験で、言い換えただけでもスコアが動く偏りが見えたことです。金利換算(後述)を試す際の元スコアとして使っています。ラダーでの順序復元力(τ)を比べると、同じローカルQwenに判定させたBTがlogprobを上回ったのは4つのラダー中1つ(Fed・Qwenが書換え: 0.41 対 0.33)だけでした。下回ったのはFed・Claudeが書換え(0.87 対 0.91)、日銀・Claudeが書換え(0.43 対 0.57)、日銀・Qwenが書換え(-0.05 対 0.25)です。
5. 市場は反応したか: 金利の動きと突き合わせる
前章のラダーは、市場データを使わずに「尺度として機能しているか」を確かめる検証でした。ここでは逆に、実際の市場の反応と照らし合わせます。タカ派的だと判定された声明が出た日に金利が上がっているなら、このスコアは市場が読み取ったものと同じ方向を向いている、と言えるはずです。
やり方: スコアと金利の動きを並べる
その前に、どの金利を見るかを決めておきます。ここで使うのは政策金利そのものではなく、2年国債の利回りです。政策金利は会合のたびに0.25%刻みで動くか、据え置かれるかのどちらかなので、「声明の言い回しに市場がどう反応したか」を測る物差しにはなりません。
一方、国債の利回りは毎日市場で取引されて細かく動き、「これから2年くらいの間、政策金利が平均してどのあたりで推移しそうか」という投資家の予想を映します。タカ派的な声明を受けて「利上げが早まりそうだ」と受け取られれば、その日のうちに2年債の利回りが上がる、という具合です。散布図の縦軸が「債券の利回り」なのはこのためで、2年としたのは、10年よりも金融政策の見通しを素直に反映しやすいからです。
声明1件ごとに、スコアと、その発表日の金利の変化(Fedは米2年債、日銀は日本国債2年)を1組にして並べます。例えば「2026年9月16日: スコア+1.78、金利+7bp」「2026年7月29日: スコア+0.55、金利−4bp」といった具合です。これを全イベント分並べて、スコアが高い回ほど金利も上がっているかを、順位で見る相関(Spearman相関)で測ります。順位で見るのは、外れ値1件に結果を引っ張られにくくするためです。相関が+1に近ければ「スコアが高い回ほど金利が上がる」、0付近なら「関係なし」、−1に近ければ逆向きの関係を意味します。
このとき、2024年8月までを学習期間、2024年9月以降を検証期間として、あらかじめ分けています。結果を見てからプロンプトを調整する、といった「後出し」ができないようにするためです。
結果: 安定した関係は見つからなかった
本命のペア比較+BTのスコアと、発表日の金利変化を、全期間(各99件)まとめて散布図にしたものが下です。横軸がタカ派度スコア、縦軸がその日の利回りの変化(bp)。右へ行くほどタカ派寄りの声明なので、もし読み取れているなら、点は右上がりに並ぶはずです。
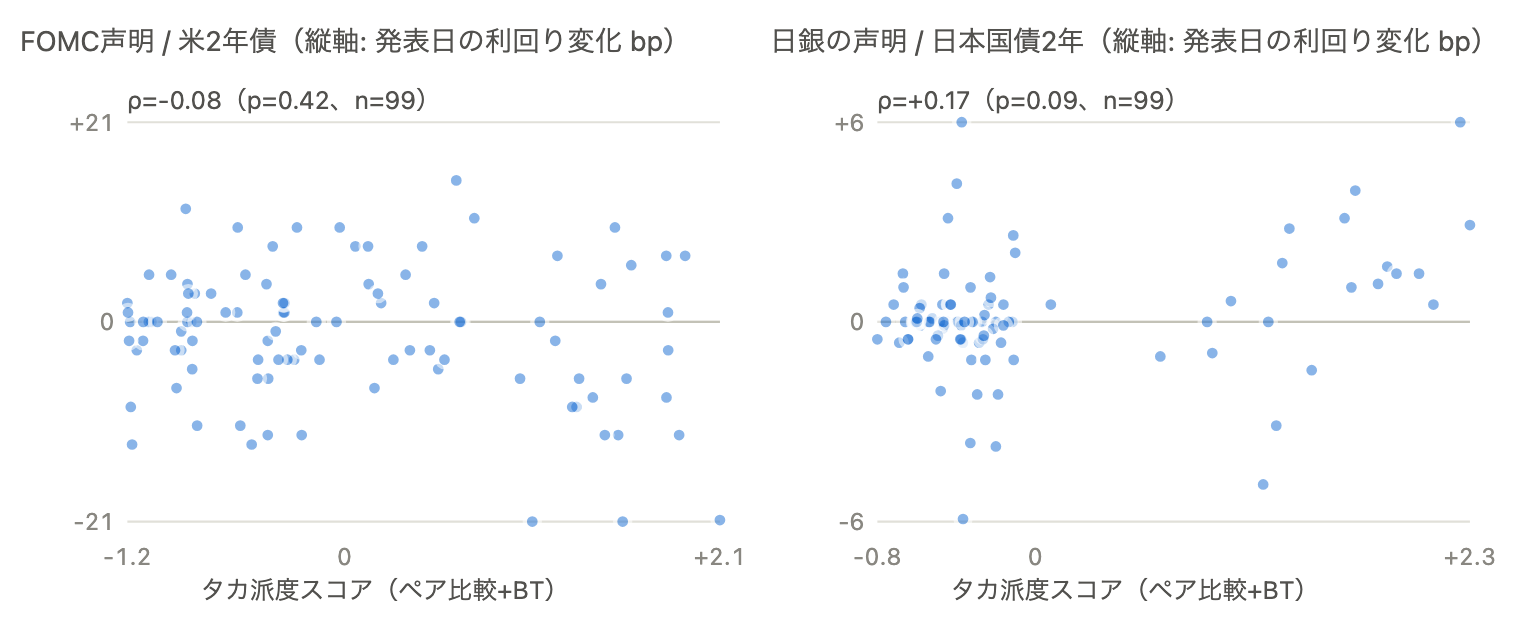
実際には、雲のように広がるだけでした。相関はFedが-0.08(p=0.42)、日銀が+0.17(p=0.09)。どちらもほぼゼロで、偶然の範囲を出ません。「タカ派的な声明の日ほど金利が上がる」という関係は、素直に見た限りでは出てきませんでした。
日銀の+0.17は、わずかに直感どおりの向きではあります。ただ、これが本物なら期間を分けても再現するはずです。そこで2024年8月までと2024年9月以降で相関を取り直したところ、符号(プラスかマイナスか)が両方の期間で一致した組み合わせは16通り中3通りで、コイン投げと変わりませんでした。手法・銀行・文書の種類・スコアの使い方を変えて64通り計算しても、p<0.05が出たのは2通りだけ。64回も試せばまぐれで数通りは当たる数なので、これも偶然と区別がつきません。
金利の単位(bp)に翻訳してみる
金利の世界では、動きの大きさをbp(ベーシスポイント)という単位で表します。1bp = 0.01%で、例えば2026年9月のFOMCの利上げ幅0.25%は25bpです。「0.25%上げた」より「25bp上げた」の方が小数点の桁を間違えにくいので、現場ではこちらが使われます。うまくいけば「タカ派度が1ノッチ上がると金利が何bp動くか」という、一つの分かりやすい数字が言えます。
計算は掛け算2つです。Fedを例にすると、
- ① ラダーから: ノッチを1つ上げると、スコアが平均で9.13動く(書き換え実験で測定)
- ② 市場から: スコアが1動くと、発表日の2年金利が-0.422bp動く(学習期間の回帰で推定)
- ①×②: 9.13 × -0.422 = 1ノッチあたり-3.85bp
ここで使うスコアは、本命のペア比較+BTではなくlogprobです。BTのθは「何ペアをどう選んで比べたか」で目盛りの幅が変わってしまい、別々に推定した2つの数字を掛け合わせる用途には向かないためです。その点logprobは、比較のやり方に左右されない固定の目盛りを持っています。なお数値を出すのは、ラダーが順序を復元できて、かつプラセボに偏りがない場合だけ、という基準にしました。
結果はFedが1ノッチあたり-3.85bp(95%区間 [-6.91, -0.05])、日銀が+3.03bp(95%区間 [+0.37, +5.37])です。区間はどちらもゼロを外れていますが、中身を見るとどちらも信用できません。
- Fedは符号が逆: -3.85bpということは「タカ派寄りの声明ほど金利が下がる」という意味になり、直感と反対です。しかも検証期間ではその符号自体が反転しています。
- 日銀は1件頼み: 2024年7月31日のたった1件で、学習期間の傾きの130%が説明できてしまいます(他の日が逆方向に効いているため100%を超えます)。この1件を除くと傾きはほぼゼロに戻ります。
というわけで、「1ノッチ=何bp」という頑健な数字は、今回のデータからは得られませんでした。当初はここが一番の見せ場になる予定だったので、正直なところ少し残念な結果です。とはいえ、出なかったものを無理に出すわけにもいかないので、そのまま載せておきます。
6. 限界と今後
- 標本が小さい: ラダーの基準文は3〜15件、検証期間は16〜18イベントです。区間は広く、差の大小は断定できません。
- ローカルモデルに日本語で書き換えさせると崩れました: 日銀の声明をQwen3.5-9B自身に書き換えさせたラダーは、内容保存ガード(数値の完全一致・文字3-gram類似・長さ)の通過率が46.7%と低く、使える基準文が7件まで減りました。残った7件でも順序復元はほぼゼロ(τ≈0、判定者を問わず)でした。プラセボに偏りは無かったので、ラダーという検証手法自体の欠陥ではなく、ローカルモデルが日本語で意図した強さの書き換えを作るのが苦手、という生成側の限界だと考えています。
- 展望: 判定者を強いモデルに変えると、さらに良くなる可能性があります。判定者をローカルのQwen3.5-9BからClaude Codeに差し替えて比べたところ、日銀のラダー(Claude書換え)ではτが0.43→0.82、Fedのラダー(Claude書換え)でも0.87→1.00に上がりました。プラセボの検出力も、Claude判定の方が明確に高くなります。ただし1つだけ例外があり、Fedの声明をQwen3.5-9B自身に書き換えさせたラダーでは、Claude判定(τ=0.21)がQwen判定(τ=0.41)を下回りました。書き換えた本人が判定する方が有利になる、いわば「ホームアドバンテージ」のような効果が働いている可能性があります。ただしClaude Codeには
claude -pにtemperatureやseedの指定がなく、キャッシュを消してゼロから再実行すると判定がわずかに変わる可能性があります(この比較の数値はキャッシュ済みで再現できます)。 - ノッチはLLMが定義した量で、政策の「1ノッチ」ではありません。書き換えはスタンス中立でもありません(プラセボの節)。
- 長い声明は前半しか見ていません: 処理ごとに読み込む文字数の上限を決めています(書き換えラダーの土台は先頭3,000文字、ペア比較の判定は各文書2,500文字、logprobと1〜10の採点は4,000文字)。日銀の声明には長いものがあり、その後半は評価に入っていません。
7. まとめ
やったことは単純で、LLMに「AとB、どっちがタカ派?」だけを何百回も聞き、その勝敗からBradley-Terryモデルで各声明の点数を付けました。判定はすべて手元のMacのQwen3.5-9Bで、課金APIは使っていません。
分かったことを3つにまとめると、こうなります。
- うまくいったこと: 声明を−3〜+3に書き換えた「ラダー」を作れば、市場データがなくても、ものさしの出来を採点できます。Fedの声明では、その順序をかなり正しく復元できました(τ=0.87)。
- うまくいかなかったこと: 日銀の声明では順序を復元しきれず(τ=0.43)、金利の動きとの安定した関係も見つかりませんでした。「タカ派度1ノッチ=何bp」という当初の目標も、信用できる数字にはなりませんでした。
- 意外だったこと: 書き換えた本人が判定すると成績が上がる「ホームアドバンテージ」らしき効果が出ました。誰が書き、誰が判定するかで結果が動くので、この種の検証では両方を記録しておく必要があります。
改善の余地はまだあります。判定者をClaude Codeのような強いモデルに替えると多くの場面で精度は上がりましたし(限界と今後の節)、日本語に強いモデルを使う、標本を増やす、といった手も残っています。ペア比較で「ものさし」を作る考え方自体は、中央銀行の発言に限らず、点数を直接付けにくいものを測りたいときに使えるはずです。
なお、今回のパイプラインの実装から原稿の校閲・レビューまで、Claude Codeに手伝ってもらいました(実装はClaude Sonnet 5、校閲・レビューはClaude Opus 5)。
最後に
グループ研究開発本部 AI研究開発室では、データサイエンティスト/機械学習エンジニアを募集しています。 ビッグデータの解析業務などAI研究開発室にご興味を持って頂ける方がいらっしゃいましたら、ぜひ 募集職種一覧 からご応募をお願いします。 皆さんのご応募をお待ちしています。 一緒に勉強しながら楽しく働きたい方のご応募をお待ちしています。

グループ研究開発本部の最新情報をTwitterで配信中です。ぜひフォローください。
Follow @GMO_RD