2026.10.15
ループエンジニアリングの実践:Claude Code とカスタム lint を組み合わせた自己改善型コードレビューシステムの構築と検証
導入:AI コードレビューの課題
こんにちは。次世代システム研究室のN.Uです。
Claude Code や Codex のようなコーディングエージェントに実装を任せるようになって、コードを書く速さは大きく上がりました。速く書けるようになった分、レビューしなくてはならないコードも増えていませんか?
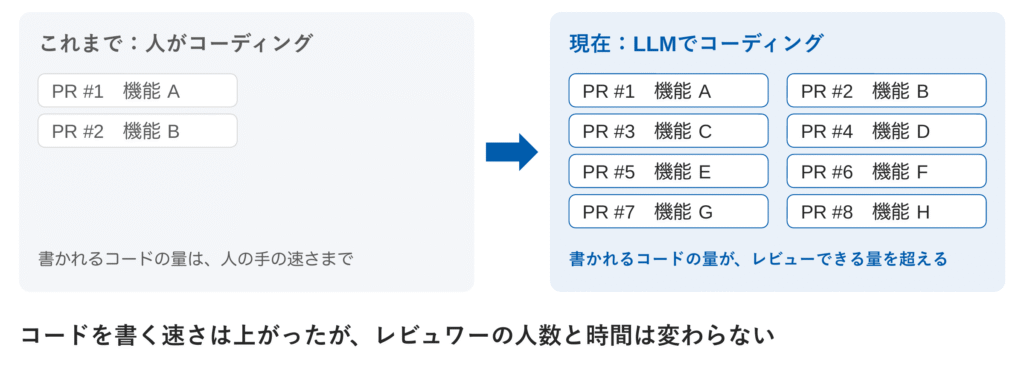
AI が書いたコードでも、理解しないままマージはできません。結局は人が読むことになりますが、レビュワーの人数も時間も変わっていません。しかも、レビューで何を見るかというレビュー観点は、ベテランの頭の中にしかないことが多く、レビューがその人に集中して、負担が増え続けます。以下、レビュー観点を観点と書きます。
この負担への対策としてよく使われるのが、AI コードレビューです。以下、AI レビューと書きます。ただ、AI レビューにはチームが積み上げてきた観点が渡っていないので、同じ指摘は人が書き続けることになります。私たちのプロジェクトでも、「複数テーブルを更新しています。トランザクションを張ってください」のような同じ指摘を、何度も書いていました。書きながら、正直「何回、同じことを言えばいいんだろう」と思っていました。
それなら観点を AI に教えればいい、と考えるのが自然です。まず思いつくのは、AGENTS.md や Agent Skills に書いて渡す方法です。AGENTS.md はコーディングエージェントに読ませる指示ファイルで、Agent Skills は Claude に読ませる自然言語の指示書です。以下、Agent Skills を skill と書きます。私たちも最初は、観点を skill で蓄積しようとしました。ところが、人の指摘から作った skill では、元の指摘を網羅できませんでした。
本記事の主題は、skill に代わる、チームの観点の蓄積方法です。
結論ファースト
- 人のレビューコメントから、観点ごとの検出スクリプトであるカスタム lint を Claude が作り、チームの観点を蓄積しました
- PR ごとにカスタム lint で検査し、PR に投稿する指摘だけを LLM が選択することで、過去に人が指摘した観点と同じ観点を、人のレビュー前に自動で指摘できました
- 人が選んだ AI レビューの指摘 1 件から作ったカスタム lint をコードベース全体に適用し、エラーにならない同じ間違いを 4 件見つけました
目次
1. 事前検証:skill で観点を蓄積できるか
2. 設計のポイント
2-1. 蓄積した観点を PR に適用する処理の分け方
2-2. レビューのループを閉じる 3 つの workflow
3. 実験
3-1. 実プロジェクトでの評価
3-2. 改善点
この記事で扱うこと
この記事が扱う問いは次の 1 つです。
チームの観点を、どういう形で蓄積すれば、永続化でき、次の PR から常時適用できるのでしょうか。
ここでいう永続化は、レビュワーの頭の中にしかない観点を、人に依存しない形で残すことです。
この記事の答えは、観点を、レビューコメントから Claude が作る検出スクリプトとして蓄積することです。観点ごとに作るこの検出スクリプトを、カスタム lint と呼びます。人のレビューコメントだけでなく、AI レビューの指摘のうち人が選んだものも、カスタム lint を作る元のレビューコメントとして使います。ただ、カスタム lint はコードの形だけを検査するので、形の上では観点に当てはまっても、人から見れば指摘する必要のないものまで検出します。これを、過剰な指摘と呼びます。過剰な指摘が混ざる観点には、Claude がそれを除外するための判断基準も作ります。以下、カスタム lint と、あればその判断基準をまとめて規約と呼びます。また、規約に反している可能性があるコードの箇所を、違反の候補と呼びます。以下、候補と書きます。
タイトルの「ループエンジニアリング」は、Google の Addy Osmani 氏が 2026 年 6 月にブログで提唱した考え方で、人が AI に毎回指示を打つ代わりに、AI への指示が繰り返し送られる仕組みのほうを設計するものです(@IT「ループエンジニアリングとは? チャットとAIコーディングの往復から卒業する新しい開発スタイル」)。その記事でいうループは、人が目的を 1 つ定義すれば、完了条件を満たすまで AI が試行を繰り返すことを指します。それに対して、この記事のループは周期が長く、人の指摘が規約として蓄積され、次の PR に適用される、PR をまたいで回るループです。このループが回る状態にすることを、以下「ループを閉じる」と呼びます。タイトルの「自己改善型コードレビューシステム」は、このループによって、レビューの指摘から規約が増え、過剰な指摘への人の返信で判断基準が直されて、レビューが良くなっていくコードレビューの仕組みを指します。
事前検証:skill で観点を蓄積できるか
書き出しで触れたとおり、最初は手軽さを優先して、観点を skill で蓄積するつもりでした。自然言語で蓄積すれば、複雑な機構なしに実装できると考えたからです。skill で観点を蓄積できるかを確かめるために、PR 1 件を使って次の事前検証をしました。
- PR に付いた人の指摘から、Claude が skill を作ります
- その skill を同じ PR に適用します
- skill の指摘を、人の指摘と比較します
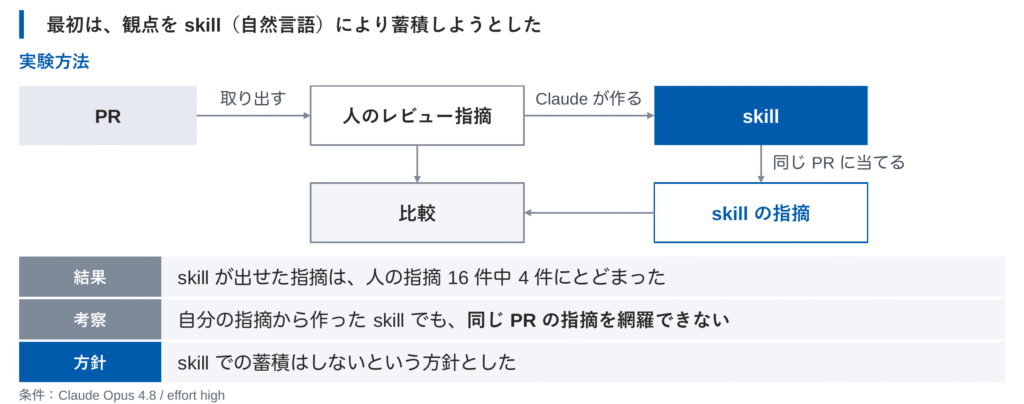
条件は Claude Opus 4.8、effort は high です。effort は、推論にかける思考量の設定です。
skill で検出できた指摘は、人の指摘 16 件中 4 件 にとどまりました。このことから、同じ PR に私たちが付けた指摘から作った skill でも、その PR の指摘を網羅できないと考えました。
そのため、skill での蓄積はしないという方針としました。
ただ、skill で検出できなかった 12 件の原因が「指摘から skill を作る段階で観点を取りこぼした」のか「観点は skill に書かれているのに、レビューで AI が適用しなかった」のかは、この事前検証では切り分けていません。
設計のポイント
蓄積した観点を PR に適用する処理の分け方
まず、この記事の仕組みの技術スタックを示します。仕組みは、GitHub Actions の workflow として動いています。カスタム lint は、Node.js と TypeScript Compiler API、Shell Script で作っています。TypeScript Compiler API は、TypeScript のコードを構文として解析する公式 API です。PR への指摘の投稿には、reviewdog を使っています。reviewdog は、lint などの解析結果を PR に行単位のコメントとして投稿するツールです。候補の採否の判断と規約の作成には Claude Code を使い、claude -p で呼び出しています。claude -p は、対話画面を開かずに 1 回だけ実行するモードです。モデルは Claude Opus 5、effort は high です。
| 用途 | 使ったもの |
|---|---|
| workflow | GitHub Actions |
| カスタム lint | Node.js + TypeScript Compiler API + Shell Script |
| 指摘の投稿 | reviewdog |
| 候補の採否の判断と規約の作成 | Claude Code の claude -p、Claude Opus 5、effort: high |
先行研究:レビューコメントは静的解析で検出できるか
観点をカスタム lint で蓄積する根拠として、Mehrpour と LaToza の静的解析に関する研究を参考にしました。この研究では、OSS の PR に付いた人のレビューコメント 1,323 件を静的解析で検出できるか判定し、約 4 分の 3 にあたる 76% は原理的に静的解析で検出しうると報告しています。この結果から、人の指摘の多くは静的解析に置き換えられると考え、観点を skill の代わりにカスタム lint で蓄積することに決めました。裏を返すと、残りの約 4 分の 1 は、原理的に静的解析で検出しうるとは判定されていません。そうした観点は、今回は対象外にしました。
なお、人の指摘を蓄積し、AI に読ませる発想自体には先行例があります。Microsoft の Aggarwal と Ghalatyは、採用された指摘を自然言語で書いた行動規則として蓄積し、コーディングエージェントに読ませる仕組みを報告しています。この記事との違いは、観点を、候補を検出するカスタム lint として蓄積し、自然言語は過剰な指摘を除外する判断基準にだけ使う点です。
カスタム lint に寄せる方向は、OpenAI の Ryan Lopopolo 氏が 2026 年 2 月に公開した記事「Harness engineering」とも重なります。同記事によると、OpenAI では、レビューコメントなどから得た人の判断をドキュメントやツールに直接落とし込み、カスタム linter と構造テストで不変条件を機械的に強制しています。そのカスタム linter は、Codex が作ったものです。この記事の仕組みは、その落とし込みを、レビューコメントが付くたびに自動で Claude に行わせるものです。
検出と除外の分担
観点をカスタム lint で蓄積すると決めたうえで、蓄積した観点を PR に適用する処理を 2 つに分けました。
- 候補を検出する部分は、カスタム lint に任せます。静的解析なので同じコードには何度でも同じ結果が得られます。そのため、候補を PR ごとに検出したりしなかったりすることがありません
- カスタム lint が検出した候補から、過剰な指摘を除外する部分だけを、LLM に任せます
この分け方により、事前検証で切り分けられなかった 2 つの原因のうち、「観点は規約に書かれているのに、レビューで AI が適用しない」という原因は、少なくとも候補を検出する段階では起きなくなります。もう一方の「指摘から規約を作る段階で観点を取りこぼす」という原因は、カスタム lint にしても残ります。
レビューのループを閉じる 3 つの workflow
ここからは、前の節で分けた、候補を検出する部分と過剰な指摘を除外する部分の 2 つを、どういうファイルに置き、どういう workflow で回しているかを説明します。
規約は lint.mjs と judge.md でできている
規約は、カスタム lint である lint.mjs と、必要な観点にだけ作る判断基準の judge.md でできています。カスタム lint は、ESLint などの既存の lint を使わず、Claude が TypeScript Compiler API で書きます。前の節で紹介した記事の題名にもあるハーネスエンジニアリングは、AI エージェントが目的を達成できるように、環境やフィードバックの仕組みを設計する考え方です。カスタム lint は、ハーネスエンジニアリングでいうセンサーにあたります。センサーは、Birgitta Böckeler の分類で、AI が動いた後に結果を検査し、自己修正を助ける仕組みです。カスタム lint に変換できる人の指摘が来るたびに、このセンサーが増えていきます。
1 つの規約を、1 つのディレクトリに置きます。次は、sourceItems のように、要素が何か分からない名前で集合を受けている変数を検出する規約の例です。
no-bare-collection-name/
├── lint.mjs        実装:検出スクリプト。候補を漏れなく検出する
├── lint.test.mjs   テスト
├── judge.md        triage(候補の選別):検出した候補をコメントとして出力して良いかを Claude が判断する基準
└── 履歴.json        起点と判断
このほか、ディレクトリにはテストの lint.test.mjs と、規約の起点と判断を残す履歴.json も置きます。
judge.md は、前の節で述べた、カスタム lint の候補に混ざる過剰な指摘を除外するためのものです。カスタム lint が検出した候補を Claude が judge.md の判断基準で読み、出力して良いものだけを選択します。
過剰な指摘を減らすことは、静的解析を使ってもらううえで欠かせません。Google の静的解析基盤 Tricorder では、指摘を見た開発者が何も対応しなかったものを「実質的な誤検知」と呼び、10% 未満に抑えることを基準にしています(Sadowski ら, ICSE 2015/Software Engineering at Google 第 20 章)。誤検知の多いツールは、開発者に使われなくなるためです。
また、検査範囲は規約ごとに 2 種類から選びます。1 つは scope = 'file' で、そのファイルだけを見ればいいものです。たとえば、boolean の変数名は is / has で始める、という規約です。もう 1 つは scope = 'repo' で、src 全体を見なければ判断できないものです。たとえば、どこからも参照されていないメソッドを検出する規約です。大規模でも毎回すべてを検査しないための区別なので、そういう区別があるんだな、くらいで読み流してもらって大丈夫です。
3 つの workflow の役割
規約は、アプリとは別の規約リポジトリにまとめて置きます。
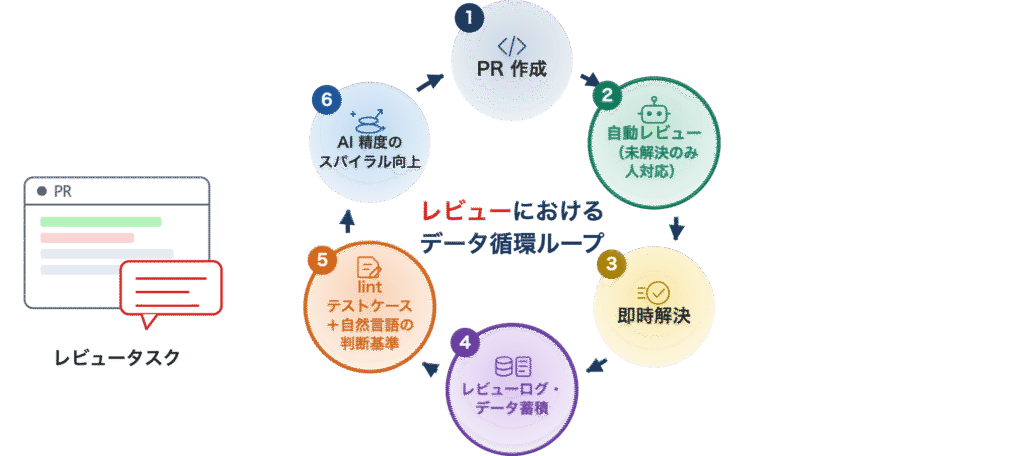
この規約リポジトリを、GitHub Actions の workflow 3 つが読み書きしてループを回します。中心になるのは、人のレビューコメントから規約を作る review-learn と、規約で PR をレビューする review-lint の 2 つで、review-allow は補助的な役割を担います。以下、review-lint が PR に指摘を投稿するレビューを「自動レビュー」と呼び、一般的な AI レビューと区別します。
| workflow | いつ動くか | 何をするか |
|---|---|---|
| review-learn | 人がレビューコメントを書いたとき。AI レビューの指摘は、人が /learn と返信したとき |
レビューコメントから観点を抜き出し、lint.mjs と judge.md にして規約リポジトリに蓄積します |
| review-lint | PR が作成されたとき | 規約リポジトリにある規約で PR の差分を検査し、過去と同じ観点の指摘を投稿します |
| review-allow | 自動レビューの指摘に /allow 理由 と返信したとき |
judge.md に採用しない条件を足し、同種の指摘を投稿しないようにします |
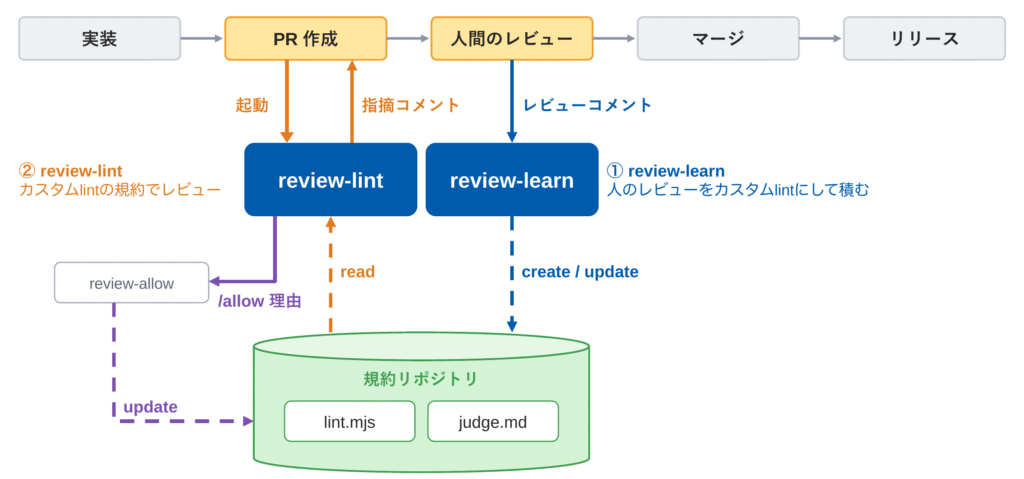
人がするのは、いつもどおりレビューを書くことと、規約にしたい AI レビューの指摘に /learn、自動レビューの過剰な指摘に /allow で返信することだけです。レビュワーの頭の中にあった観点のうちカスタム lint に変換できるものが、PR を重ねるごとに規約として蓄積されていきます。
review-learn:人の指摘を規約にする
review-learn の動きを、次のコードに実際に付いた「変数名が不明瞭です」というレビューコメントを例に説明します。コード例は、元のコードから名前を変えています。以降も同様です。
const sourceItems = await this.dataSource
  .getRepository(TypeOrmOrderItemsModel)
  .find({ ... });
review-learn では、Claude が規約を書きます。review-learn が規約を作ることを、以下、学習と呼びます。人の指摘を受け取ると、Claude はまず、その指摘を、カスタム lint でどこまで判定できるかによって 3 つに分類します。カスタム lint だけで判定できるものは lint.mjs だけを、カスタム lint で絞って Claude が過剰な指摘を除外するものは lint.mjs と judge.md を作ります。カスタム lint でも絞り込めないものは、従来の skill の領域として今回は対象外です。この例は lint.mjs と judge.md の両方を作るものにあたり、処理は次の 4 ステップです。
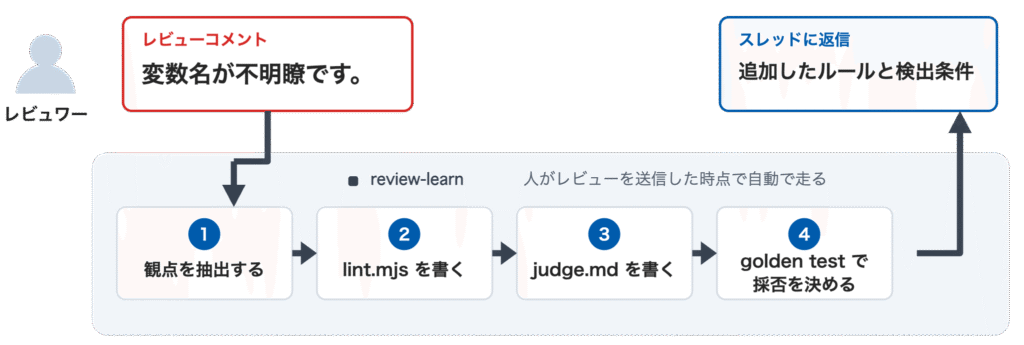
- 観点を抽出する:レビューコメントには「変数名が不明瞭です」としか書かれていないので、Claude が差分を読んで補い、「
sourceItemsのように、要素が何か分からない名前で集合を受けている」という観点を抜き出します - lint.mjs を書く:Claude が書く lint.mjs は、次の関数で名前を単語に分け、最後の単語が
itemsのような集合を表す語のとき、名前がその語だけなら検出し、その前の単語がsourceのように要素を表さない語でも検出します。意味が伝わりにくいsourceItemsは検出し、具体的な単語が入ったorderItemsは検出しませんfunction unqualifiedCollectionWord(name) { const words = splitWords(name); const lastIndex = words.length - 1; const word = words[lastIndex].toLowerCase(); if (!COLLECTION_WORDS.has(word)) return undefined; if (lastIndex === 0) return word; if (NON_ENTITY_WORDS.has(words[lastIndex - 1].toLowerCase())) return word; return undefined; } - judge.md を書く:judge.md には、候補を採用する条件と採用しない条件を書きます。この例では、
const items = ...; const memberItems = ...;のように同一関数・同一クラス内に別の集合が存在するなら採用し、const rows = await find(); return rows.length;のように直後の 1〜2 行で消費され、他の集合と並存しないなら採用しません - golden test で規約を規約リポジトリに加えるかを決める:golden test は、直す前と後のコードを入力にした回帰テストです。直す前のコードである
sourceItemsは検出され、直した後のコードであるorderItemsは検出されないことを確かめます。両方が通れば規約リポジトリに加え、通らなければ規約を修正します
review-lint:PR に規約を適用する
review-learn で蓄積した規約は、review-lint が PR に適用します。PR が作成されると、次の 4 ステップで動きます。
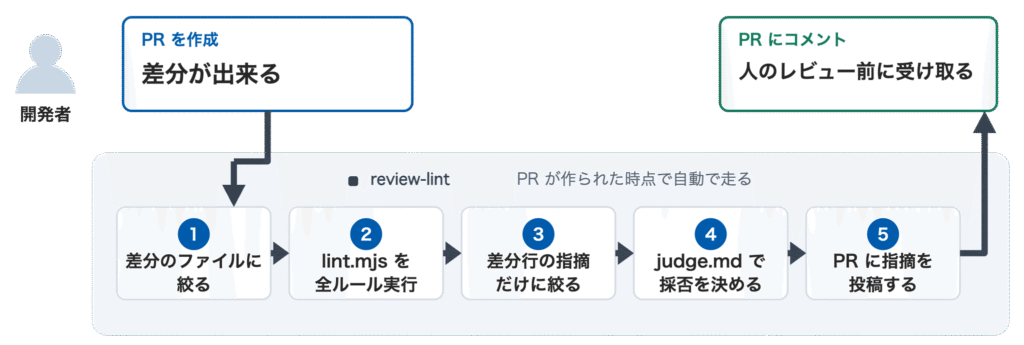
図の 1 と 2 は、下の手順 1 にあたります。
- すべての規約の lint.mjs を実行します。
scope = 'file'の規約は差分のファイルに、scope = 'repo'の規約は src 全体に実行します - 差分行の候補だけに絞ります。カスタム lint はファイル全体を検査し、
scope = 'repo'の規約は src 全体を検査するので、この PR で触っていない行の候補も挙がります。既存コードの指摘で PR を埋めないため、それらはここで落とします - judge.md で候補の採否を決めます。人にとって邪魔になるような過剰な指摘になっていないかを、Claude がその判断基準で確かめます
- 採用された候補を、reviewdog で指摘として投稿します
自動レビューの指摘は次のようになります。
no-bare-collection-name
変数sourceItemsは何の集合か名前から分からない(TypeOrmOrderItemsModel由来の集合)
review-allow:過剰な指摘を人が永続的に抑制する
judge.md を通しても、過剰な指摘が投稿されることがあります。たとえば次の関数の rows に指摘が投稿されたとします。
export function summarizeOrders(rows) {
こうした過剰な指摘は、review-allow で抑制できます。使い方は単純で、自動レビューの指摘に /allow 理由 と返信するだけです。
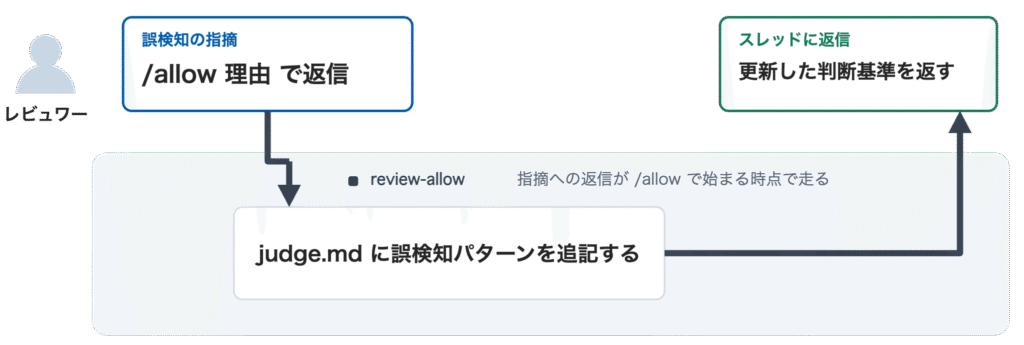
自動レビュー(no-bare-collection-name): 変数
rowsは何の集合か名前から分からないレビュワー: /allow ファイル名と関数名で注文の行だと分かる。取り違える相手の集合がこの関数に無い
この返信を受けると、review-allow は規約ごと止めるのではなく、judge.md の「採用しない条件」に 1 行追記してコミットします。同じ趣旨の判断基準が既にあれば、重複させず、明確化する形で更新します。
 ## 採用しない条件
+- 関数が 1 種類の集合しか扱わず、関数名・ファイル名自体に要素が入っている場合
Tricorder でも、解析結果に「Not useful」ボタンを付けて開発者の評価を集め、評価の悪い解析器の改善や停止に使っています(Software Engineering at Google 第 20 章)。/allow は、同じ種類の評価を judge.md の判断基準として書き戻す仕組みです。
実験
実プロジェクトでの評価
ここまでの仕組みを、実プロジェクトで評価しました。実プロジェクトは、私たちが実際に開発しているプロジェクトです。対象は、バックエンドが NestJS + TypeORM、フロントエンドが Next.js、インフラが AWS CDK の、すべて TypeScript のコードベースです。実験は 2 段階です。補助実験で仕組みが機能するかを過去のデータで確かめ、本実験で実際の開発に載せて評価しました。
補助実験:過去のデータで試す
補助実験では、過去のレビューコメントから作った規約で、人と同じ指摘が得られるかを確かめました。GitHub から人のレビュワーがレビューした PR とレビューコメント、そのタイミングのコミット ID を取得し、PR をその時点の状態に復元して、本番と同じプロンプトで review-learn と review-lint を回しました。その際、ある月のデータで学習し、次の月のデータで検証する、という逐次的な処理を行いました。検証では、出力された指摘を人のレビューコメントと照合しました。モデルは Claude Opus 5、effort は high です。人と同じ指摘が得られることを確認できたので、実プロジェクトに導入しました。
本実験:通常の開発タスクに載せる
本実験では、もともと予定していた通常の開発タスク 3 件にこの仕組みを載せ、どのような指摘が投稿されるかを見ました。実験を始めた 2026 年 9 月の時点で、規約リポジトリには 2025 年 8 月以降の約 1 年分のレビューコメントから作った規約が 74 件ありました。実験中も学習で増え、9 月中旬には 87 件になりました。
結果
本実験で得られた指摘から、例を 3 つ紹介します。
例 1:何を数えた件数か分からない変数名
プロジェクトには、件数を数えて変数に受ける処理がたくさんあります。名前が count や total だけだと、何を数えた件数か読み手には分かりません。
この種の変数に、何の件数か分からないというレビューコメントが付き、規約になりました。約 1 か月後、別の PR の別のファイルで、名前の違う件数の変数に、自動レビューで同じ指摘が投稿されました。2 つの変数名に共通する文字列はありません。それでも、どちらも何を数えたかを表す語を含まない、という名前の形が同じなので検出できました。
例 2:DB の構成変更によって発生した冗長なカラム
このプロジェクトでは、過去に DB の設計を変えたことがあります。そのとき、ある情報を別のテーブル経由で引く形に変えましたが、元のテーブルにも同じ情報のカラムが残りました。
残ったカラムを直接参照するコードに、「冗長なカラムを参照している。同じ情報は正しい経路から参照するように変えてほしい」という人のレビューコメントが付き、規約になりました。その規約が、別のファイルの同じ参照を、不具合になる前に検出しました。元のテーブルに残ったカラムと、別のテーブル経由で引く値が食い違うと、どちらが正しいか決められなくなります。しかもこの問題はエラーにならず、テストでも人のレビューでも気づきにくいものです。
例 3:期間で区切って集計する処理の、基準日のずれ
結論ファーストで触れた例です。プロジェクトには、指定した期間で区切って集計する処理が多くあります。データには有効な期間が付いていて、集計では、指定した期間に有効だったデータを数える必要があります。
AI レビューが、「期間を指定して集計しているのに、一部の条件だけ『今日時点』で絞っている。期間中は対象だったデータが集計から漏れる」と指摘しました。この AI レビューの指摘に人が /learn と返信して review-learn を起動し、規約にしました。
1 件の指摘から作ったこの規約を、PR の差分ではなく既存のコードベース全体に適用すると、同じ間違いが 4 件見つかりました。基準日のずれはエラーにならないので、数字が合わなくなるまで気づけません。実は、4 件のうち 2 件はお金に関わる箇所でした。
例 2 は、一般的な AI レビューには渡っていないプロジェクト固有の事情に踏み込んだ指摘です。一方、例 3 の元の指摘は AI レビューが投稿したものです。ただ、AI レビューの指摘はその PR に 1 回投稿されるだけで、AI レビューはコードベースに残っていた同じ間違いを検査せず、次の PR で同じ観点の指摘を投稿するとも限りません。一度投稿された指摘を規約にしておけば、既にあるコードにも、次の PR にも同じ検査を適用し直せます。ここが、毎回ゼロからレビューする AI レビューとの違いです。
評価
本実験の開発タスク 3 件の PR は、過去と同じ観点で人もレビューしました。このレビューをもとに、再現率と適合率を測りました。再現率は、人の指摘のうち過去のレビューコメントに同じ観点があった妥当なものを分母にして、そのうちカスタム lint によって検出できたものの割合です。適合率は、judge.md で過剰な指摘を除外したあとに投稿された自動レビューの指摘を分母にして、そのうち妥当だったものの割合です。
妥当かどうかは、筆者がその指摘を受けて実際に修正するかどうかで、主観的に判断しました。
| 指標 | 定義 | 結果 |
|---|---|---|
| 再現率 | 過去と同じ観点の妥当な人の指摘のうち、カスタム lint によって検出できた割合 | 61 件中 46 件を指摘(75%) |
| 適合率 | 自動レビューの指摘のうち、妥当だった割合 | 46 件中 46 件が妥当(100%) |
再現率は 61 件中 46 件で 75%、適合率は 46 件すべてが妥当で 100% でした。
見逃していた 15 件は、いずれもカスタム lint の学習漏れでした。カスタム lint を作り直せば検出できます。学習漏れは、事前検証で切り分けられなかった 2 つの原因のうち、指摘から規約を作る段階で観点を取りこぼしたほうにあたります。もう一方の「観点は規約に書かれているのに、レビューで AI が適用しない」という原因による見逃しは、カスタム lint で起きなくしようとしたもので、この範囲では起きていません。ただし、事前検証は Claude Opus 4.8・PR 1 件、本実験は Claude Opus 5・開発タスク 3 件で条件が違うので、事前検証の 16 件中 4 件と本実験の 61 件中 46 件の差が、すべてカスタム lint の効果だとまでは言えません。
なお、「蓄積した観点を PR に適用する処理の分け方」の節で紹介した Mehrpour と LaToza の研究の 76% と今回の 75% は、数字は近いですが別のものを測っています。研究の 76% は「人のレビューコメントのうち、静的解析で原理的に検出しうる割合」で、今回の 75% は「過去と同じ観点の妥当な人の指摘のうち、カスタム lint によって実際に検出できた割合」です。
改善点
今回の仕組みには、次の 2 つの改善点が残っています。
- カスタム lint に変換できない観点:「蓄積した観点を PR に適用する処理の分け方」の節で書いたとおり、原理的に静的解析で検出しうるとは判定されていない観点は今回は対象外にしたので、まだ規約として蓄積できていません。Mehrpour と LaToza の研究では、こうしたレビューコメントが約 4 分の 1 ありました
- 規約の質:評価の節で挙げた見逃し 15 件は、いずれも学習漏れでした。学習漏れがあった規約は、作り直せば検出できます
まとめ
- 人の指摘から skill を作る事前検証では、skill で検出できた指摘は人の指摘 16 件中 4 件にとどまりました
- そこで skill での蓄積をやめ、Mehrpour と LaToza の研究を根拠にカスタム lint で蓄積することにしました。候補の検出をカスタム lint に、過剰な指摘の除外だけを LLM に任せる形にしました。この形で、人の指摘が規約として蓄積され、次の PR に適用されるループを閉じました。実プロジェクトでは、過去に人が指摘した観点と同じ観点を、人のレビュー前に自動で指摘できました
- 規約はコードベース全体にも適用でき、AI レビューが投稿した 1 件の指摘から作った規約で、残っていた同じ間違いを 4 件見つけました
最後に
GMOインターネットグループでは、次世代システム研究室で一緒に働くエンジニアを募集しています!募集職種一覧は以下をご覧ください。
募集職種一覧
参考資料
- Mehrpour, S., & LaToza, T. D. (2023). Can static analysis tools find more defects? Empirical Software Engineering, 28(1), 5. https://doi.org/10.1007/s10664-022-10232-4
- Sadowski, C., van Gogh, J., Jaspan, C., Söderberg, E., & Winter, C. (2015). Tricorder: Building a Program Analysis Ecosystem. ICSE 2015. https://doi.org/10.1109/ICSE.2015.76
- Winters, T., Manshreck, T., & Wright, H. (Eds.). Software Engineering at Google, Chapter 20: Static Analysis
- Böckeler, B. (2026). Harness engineering for coding agent users. martinfowler.com
- Lopopolo, R. (2026). Harness engineering: leveraging Codex in an agent-first world. OpenAI
- Aggarwal, A., & Ghalaty, N. F. (2026). Self-Improving AI Coding Agents Through Accumulated Behavioral Rules: A Closed-Loop Framework [arXiv:2607.13091]
- ループエンジニアリングとは? チャットとAIコーディングの往復から卒業する新しい開発スタイル(@IT、2026 年 6 月 23 日)
- reviewdog [GitHub]

グループ研究開発本部の最新情報をTwitterで配信中です。ぜひフォローください。
Follow @GMO_RD