2026.09.15
Ollama×AWSでローカルLLM(Qwen・Gemma)を使い個人情報を外に出さず処理する
次世代システム研究室のY.Yです。担当しているサービスで、個人情報を多く含むテキストデータを LLM で処理する機能のインフラを担当しました。こうしたデータは外部の LLM API には送れません。そこで、自社の VPC の中でオープンウェイトの LLM をセルフホストし、GPU を処理中だけ起動するバッチ基盤を AWS 上に構築しました。
本記事の主題は、「個人情報を含むテキストを、外に出さずに LLM で扱う」ための基盤です。どんな選択肢を比べてどう決めたか、動かしてみて何にハマったかを、他のワークロードにも当てはまる形で紹介します。
結論ファースト
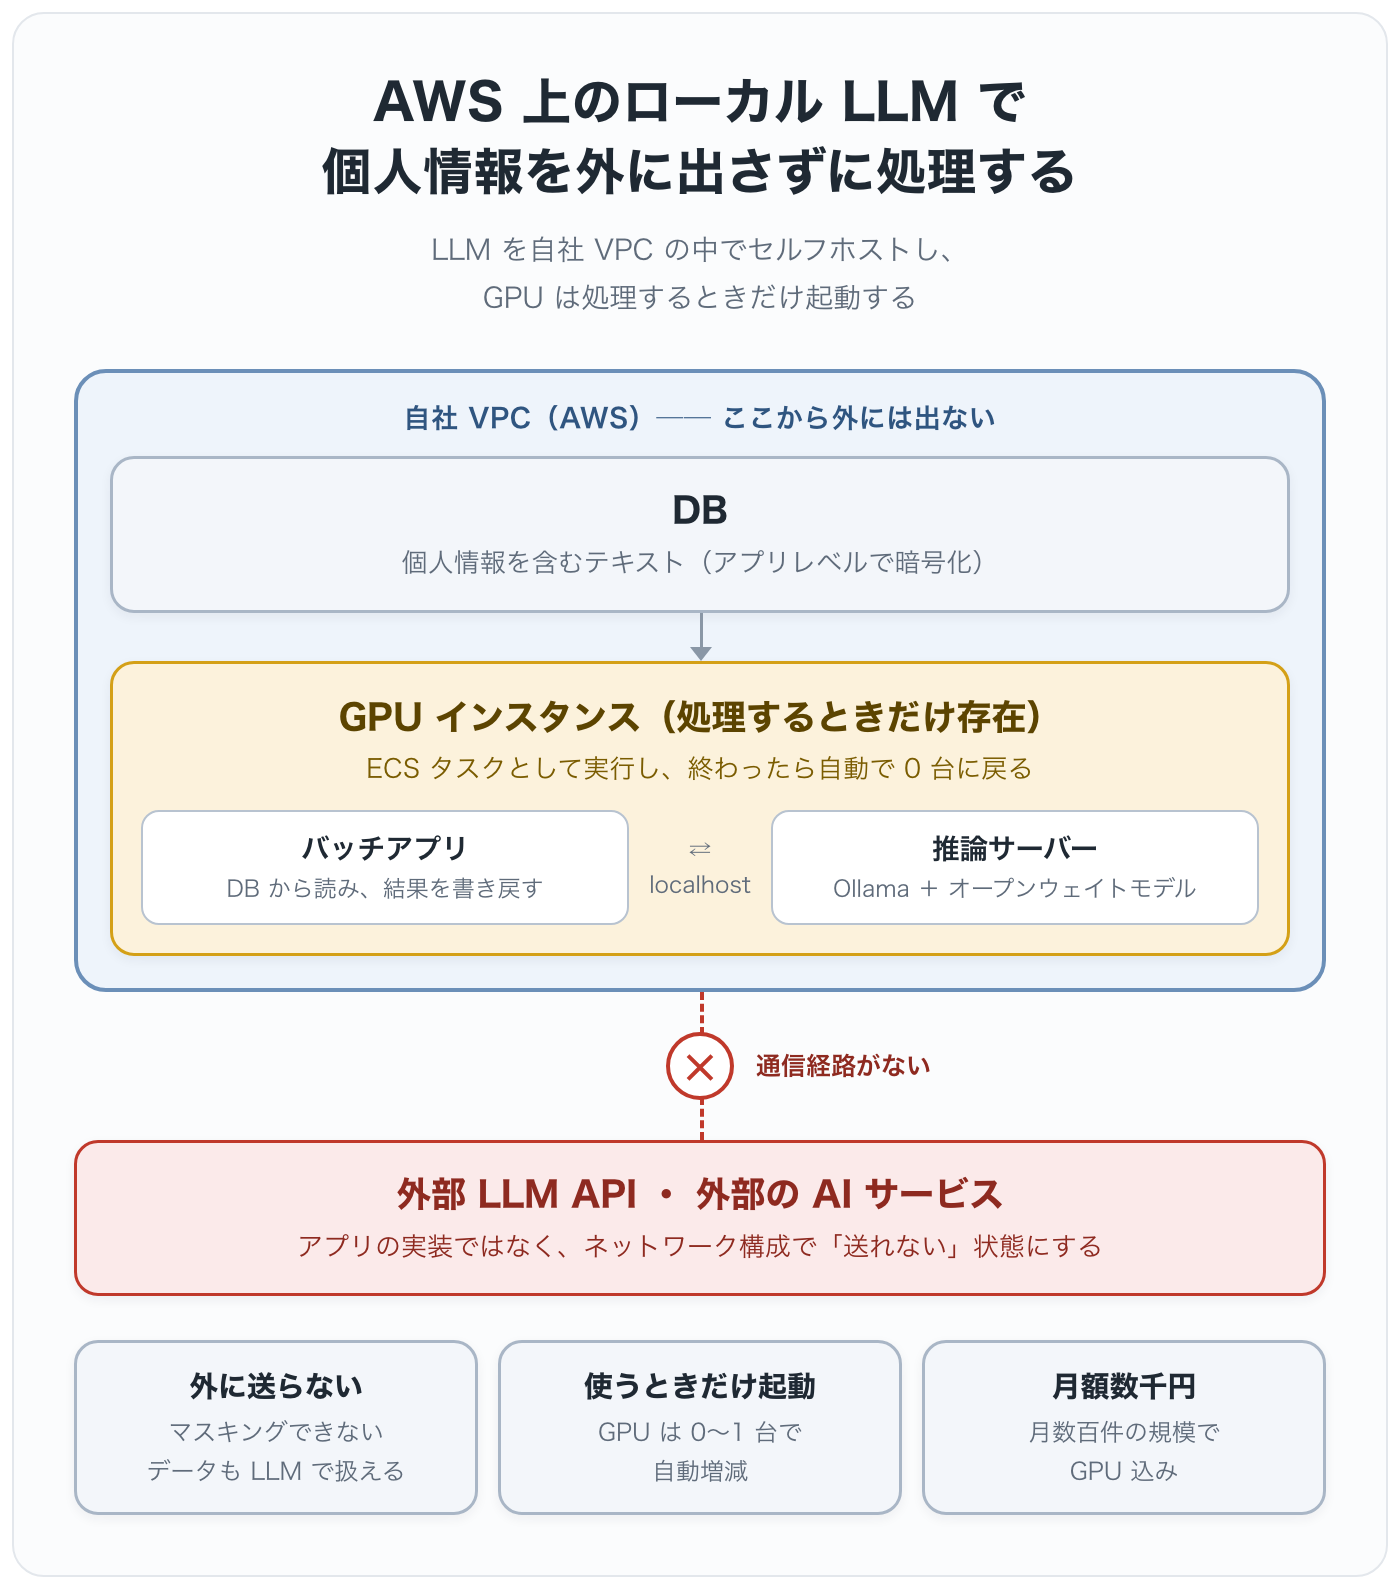
- 外部に送れない個人情報も、VPC 内でセルフホストした LLM なら処理できる
- 「外に送らない」はアプリの実装ではなく、ネットワーク構成で担保する
- GPU は処理するときだけ起動する。月数百件の規模なら GPU 込みで月額数千円
目次
- 1. 背景と課題
- 2. 設計
- 3. 実測と使用感
- まとめ
- 最後に
1. 背景と課題
マスキングでは解決できないデータ
私たちのチームには「外部の LLM API を呼ぶ前に、必ず個人情報(PII)をマスキングする」というルールがあります。氏名や連絡先を検出して伏せ字にしてから送るもので、ほとんどの用途ではこれで十分です。
ところが、今回扱うテキストはこのルールと相性が悪いデータでした。テキストの文脈全体を LLM に読ませることに意味がある処理で、氏名などの固有名詞を伏せても、文章には個人を特定しうる情報や機微な情報が残ります。逆にそれらを全部伏せると、処理そのものが成立しません。つまり「マスキングという緩和策が使えないデータ」でした。
選択肢の比較
こうしたデータを LLM で扱うには、大きく三つの選択肢があります。
| 選択肢 | データの扱い | 判断 |
|---|---|---|
| 外部 LLM API にそのまま送る | マスキングなしで社外へ送信 | 不可。社内ルールに反する |
| クラウド事業者のマネージド LLM(Amazon Bedrock 等) | 事業者のリージョン内で処理。モデル提供元には渡らず、学習にも使われず、保存もされない | 多くの用途では十分。今回は見送り |
| 自社 VPC 内でオープンウェイトモデルをセルフホスト | 自社管理の環境内で完結 | 採用 |
二つめのマネージド LLM は、正直に言うとデータ保護の水準がかなり高いです。Bedrock の場合、入力はリージョン内で処理され、モデル提供元に渡らず、学習にも使われず、保存もされません。PrivateLink を使えばインターネットも通りません。「まず Bedrock を検討する」のが AWS 上では自然な順序で、たいていの PII はマスキングと組み合わせればここで十分だと思います。
それでも今回セルフホストに倒したのは、「自社管理環境の外で平文が処理される、つまり委託先が一つ増える」という構図自体は変わらないためです。マスキングという緩和策が使えない以上、一段厳しい線を引き、「このデータは外部の AI サービスへ一切送信しません」と条件なしで言い切れる構成を選びました。「送るが学習には使われない」より、説明がクリーンになります。
代わりに引き受けるものもあります。GPU の面倒を自分で見ること、使えるモデルが各社 API の軽量ライン相当の品質に留まること、そして運用の責任がすべて自分たちに来ることです。今回の処理が「テキストを読んで決まった形式の結果を返す」定型タスクで、フラッグシップ級の推論力を必要としなかったことが、この判断の前提になっています。
インフラとして解く要件
セルフホストと決めた時点で、インフラ側の要件は三つに整理できました。
- GPU が要る:量子化済みのモデルを二つ使い、合計約 14GB。ただし処理はバッチで 1 日数十件、リアルタイム性は不要
- コストを抑えたい:GPU インスタンスを常時起動すると、東京リージョンの最小構成でも月約 13 万円。使うときだけ存在してほしい
- 「外に出ない」を構成で担保したい:アプリが気をつけるだけでは足りない。アプリに不具合があっても、外部 API やインターネットへは構成上送れない状態にする
2. 設計
どう動くか(全体構成)
採用した構成は次のとおりです。
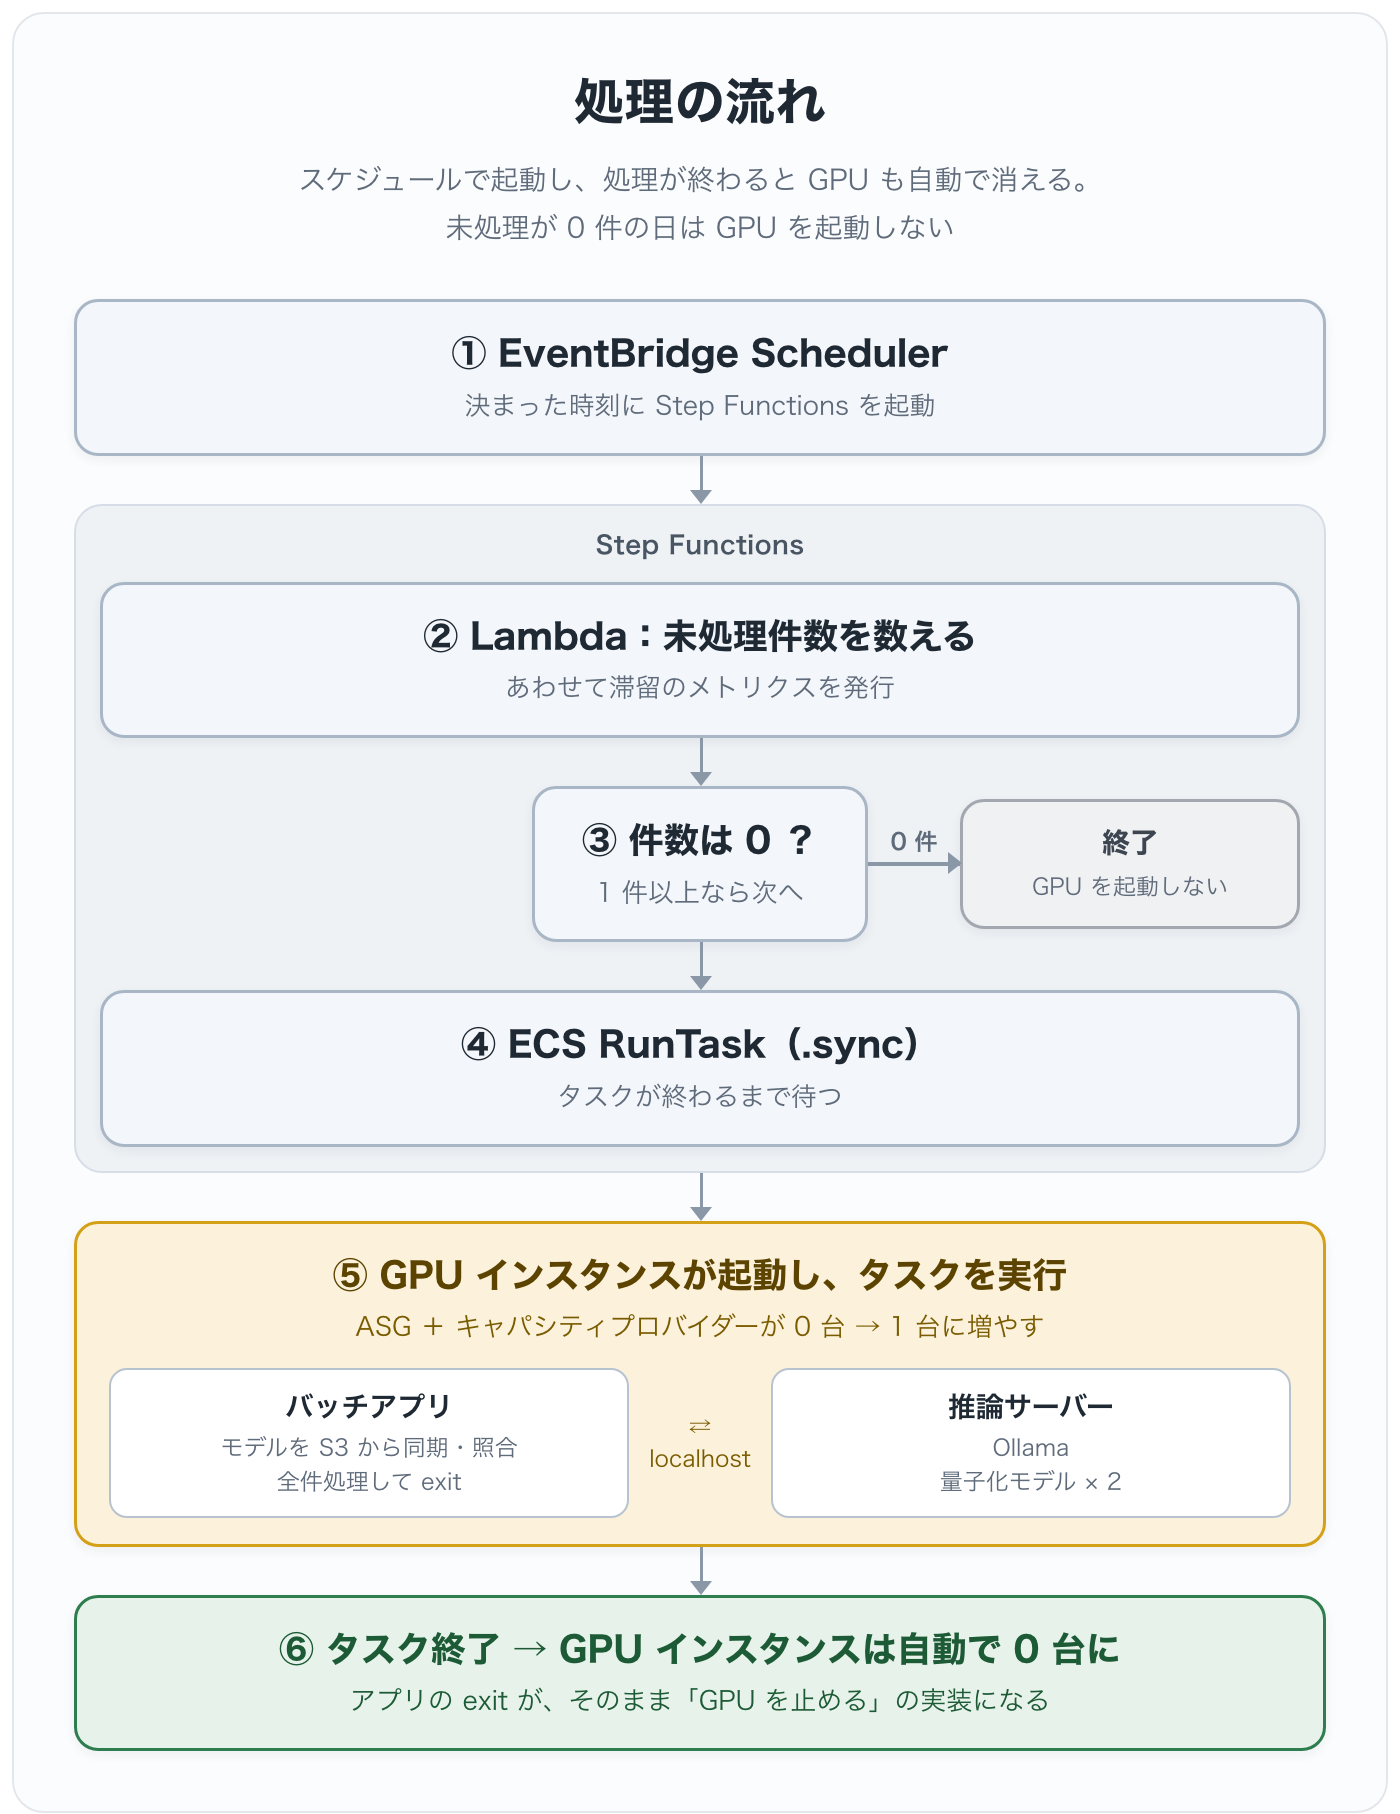
設計の要点は四つです。
- バッチ型 × ゼロスケール:未処理のデータが溜まったときだけ GPU が生えて、終わったら消える。0 件の日は起動すらしない。起動とモデルのロードにかかる約 10 分も、1 回に集約できる
- タスク終了 = アプリの exit:常駐サービスではなく RunTask で動かし、バッチアプリを essential コンテナにする。「全件処理して exit する」ことが、そのまま「GPU を止める」の実装になる
- モデルは S3 から配布:実行環境は外部のモデルレジストリに一切出ない。起動時に S3 から同期し、全ファイルの sha256 を照合する。マニフェストのダイジェストがモデルの版になるので、1 バイトでも差し替えれば別の版として扱われる
- 冪等に作る:件単位のリトライは持たず、失敗した分は次回の実行が拾う。恒久的に失敗する件は一定回数で隔離し、滞留アラームで可視化する
GPU を「0 台 ⇔ 1 台」で切り替える仕組み
この構成で一番分かりにくいのが、「タスクを実行しようとしただけで、なぜ GPU インスタンスが勝手に生えて、勝手に消えるのか」だと思います。登場人物は三つです。
| 登場人物 | 役割 |
|---|---|
| Auto Scaling Group(ASG) | EC2 インスタンスを「何台持つか」を管理する。今回は最小 0 台・最大 1 台 |
| ECS クラスター | コンテナ(タスク)を「どのインスタンスで動かすか」を管理する |
| キャパシティプロバイダー | ECS クラスターと ASG をつなぐ。「タスクを置く場所が足りない」を ASG への増減指示に変換する |
ASG 単体は「CPU 使用率が高ければ増やす」といった指標で台数を変える仕組みで、「ECS に置きたいタスクが待っている」ことは知りません。逆に ECS 単体は、インスタンスが 0 台ならタスクを置けずに終わるだけです。この二つの間に立ち、「置きたいタスクがあるのに場所がない」ことを ASG の台数に変換してくれるのが、キャパシティプロバイダーのマネージドスケーリングです。
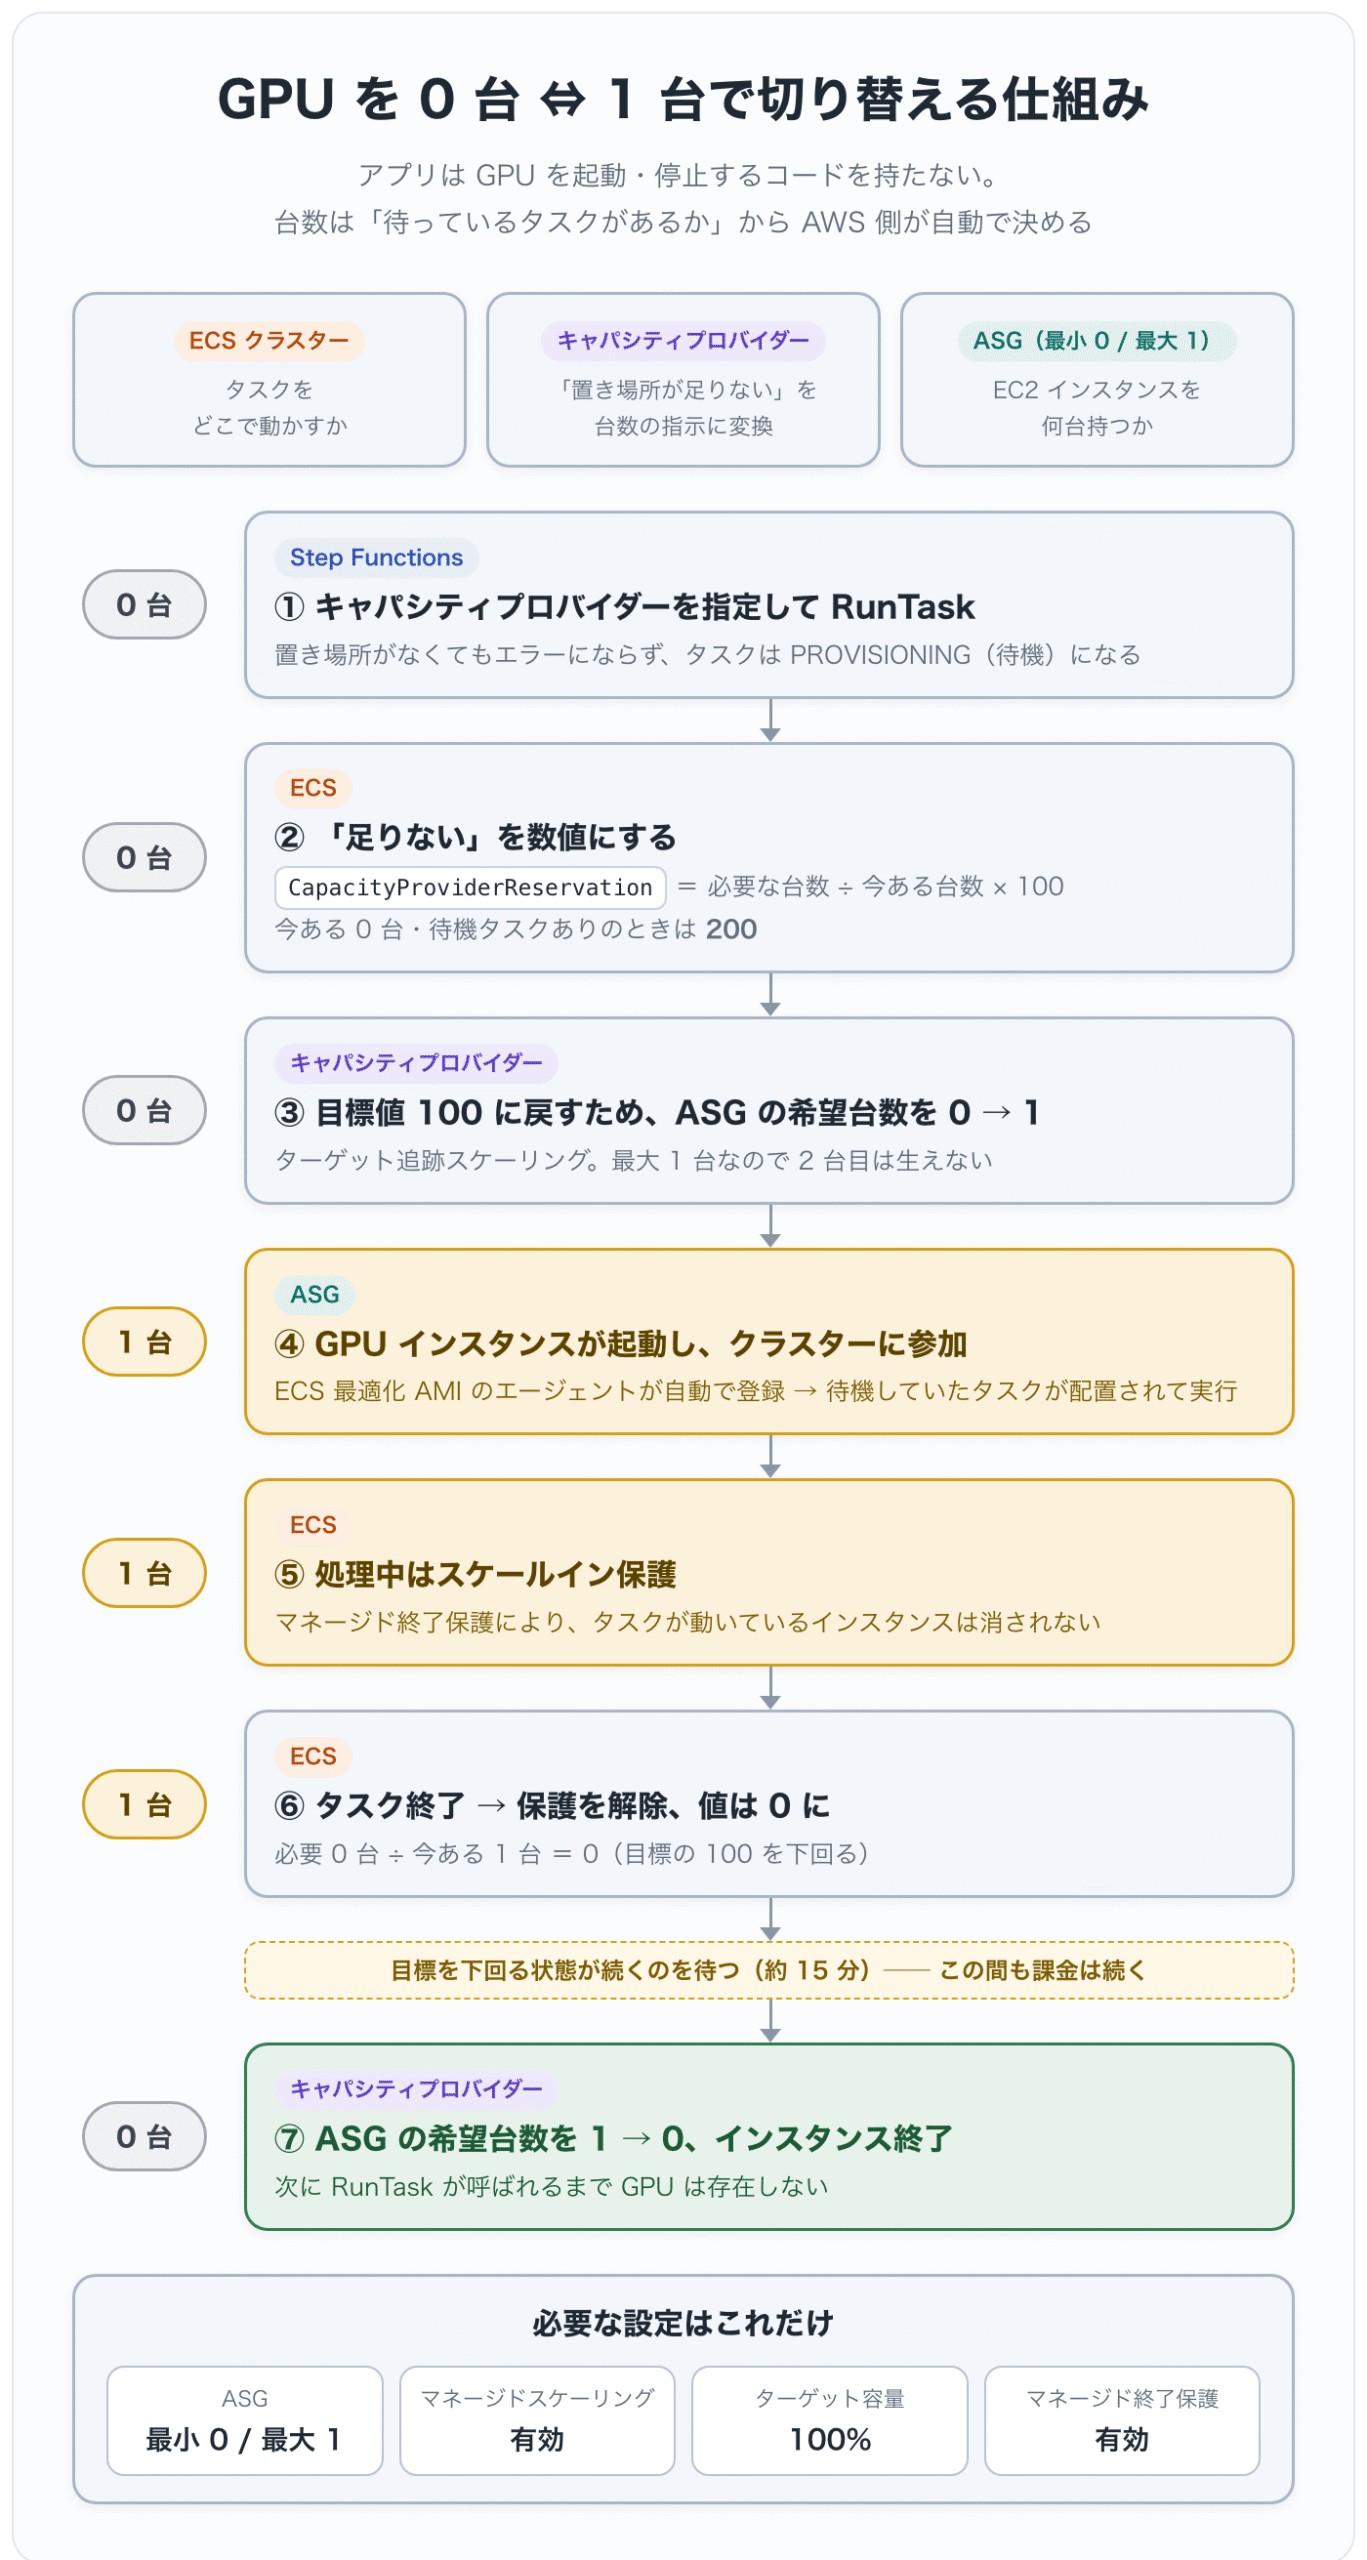
時系列で追うと次のようになります。
① タスクの実行を依頼する(0 台のまま)。 Step Functions が、キャパシティプロバイダーを指定して RunTask を呼びます。この時点でインスタンスは 0 台です。キャパシティプロバイダーを指定しているので、置き場所がなくてもタスクはエラーにならず、PROVISIONING(置き場所待ち)という状態で待機します。
② 「足りない」が数値になる。 ECS は、キャパシティプロバイダーごとに CapacityProviderReservation というメトリクスを計算しています。ざっくり言うと「必要な台数 ÷ 今ある台数 × 100」で、ちょうど足りていれば 100 です。今ある台数が 0 で、待機中のタスクがあるときは特別に 200 になり、「足りない」を表します。
③ ASG が 0 台 → 1 台に増える。 キャパシティプロバイダーは、このメトリクスを 100(targetCapacityPercent)に保つターゲット追跡スケーリングを ASG に設定しています。値が 200 になると ASG の希望台数が引き上げられ、GPU インスタンスが起動します。最大台数が 1 なので、何があっても 2 台目は生えません。
④ インスタンスがクラスターに加わり、タスクが動く。 起動したインスタンスは ECS 最適化 AMI なので、中の ECS エージェントが自動でクラスターに登録されます。これで置き場所ができ、待機していたタスクが配置されて、イメージの取得、モデルの同期、処理と進みます。ここまでの起動に数分かかります。
⑤ 処理中に消されないように守る。 処理の途中でインスタンスが消えると困ります。そこでマネージド終了保護を有効にしています。タスクが動いているインスタンスには ASG のスケールイン保護が付き、ASG が台数を減らそうとしても対象になりません。
⑥ タスクが終わると 1 台 → 0 台に戻る。 バッチアプリが全件を処理して exit すると、タスクが終了します。インスタンス上のタスクが 0 になると、ECS がスケールイン保護を外し、メトリクスは「必要 0 ÷ 今ある 1」で 0 になります。ターゲット追跡は、目標を下回る状態が一定時間続いてから減らす作りなので、約 15 分後に希望台数が 0 に戻り、インスタンスが終了します。
この仕組みのおかげで、アプリ側は「GPU を起動する」「GPU を停止する」というコードを一行も持っていません。Step Functions は RunTask を呼んで終了を待つだけ、バッチアプリは全件処理して exit するだけです。台数の増減はすべて AWS 側が、タスクの有無から自動で決めています。
設定としては次の四つだけです。
| 設定 | 値 | 意味 |
|---|---|---|
| ASG の最小 / 最大台数 | 0 / 1 | 使わないときは 0 台、どれだけ待機があっても 1 台まで |
| マネージドスケーリング | 有効 | タスクの待機状況から台数を自動で決める |
| ターゲット容量 | 100% | 余分な待機インスタンスを持たない。100 未満にすると常に空きを残す |
| マネージド終了保護 | 有効(新規インスタンスのスケールイン保護とセット) | タスクが動いているインスタンスを消さない |
ターゲット容量を 100% にしているのがゼロスケールの肝です。たとえば 80% にすると「常に 2 割の空きを持つ」ために、タスクが無くてもインスタンスを残し続けます。
一つ注意点があります。後述する 1 回あたり約 25 分の固定オーバーヘッドのうち約 15 分は、⑥の「減らす前に様子を見る」待ち時間です。タスクが終わった瞬間には課金は止まりません。
実行基盤の選択肢: AWS Batch か、Step Functions + ECS RunTask か
「ジョブをキューに積むと、計算資源の確保から実行、後片付けまでやってくれる」AWS Batch は、まさにこの用途向けのマネージドサービスで、GPU ジョブにも対応しています。ゼロから作るなら第一候補になると思います。
それでも今回見送ったのは、既存のインフラが ECS と Step Functions の規約で統一されていたためです。Batch を足すと、監視・IAM・デプロイの運用が二重になります。Batch が担う「資源の確保と後片付け」は、Step Functions の .sync(タスク終了まで待つ)とキャパシティプロバイダー(0→1→0 台)の組み合わせで素直に実現できました。
| 観点 | AWS Batch | Step Functions + ECS RunTask(採用) |
|---|---|---|
| 資源の確保・後片付け | Batch が管理 | キャパシティプロバイダーが管理 |
| 既存インフラとの整合 | 新しい運用面(監視・IAM・デプロイ)が増える | 既存の規約にそのまま乗る |
| 向く状況 | ジョブの種類・並列度が多い、新規構築 | 単一のジョブを既存の ECS 基盤に足す |
コンピュートの選択肢: Fargate は使えない
コンテナ基盤の第一候補は普段どおり Fargate でしたが、Fargate は GPU に対応していません。この一言で ECS on EC2 が確定します。
EC2 と聞くと OS やドライバの管理が重そうですが、ECS には GPU 最適化 AMI(NVIDIA ドライバとコンテナランタイムが設定済み)があり、SSM パラメータで最新版を参照できます。実際にはドライバ周りで手を動かすことはほとんどありませんでした。
採用したモデル
使っているのは、Ollama の公式ライブラリで配布されている二つのオープンウェイトモデルです。どちらも 4bit 量子化(Q4_K_M)版をそのまま使っています。
| モデル | 開発元 | パラメータ数 | 量子化後のサイズ | 特徴 |
|---|---|---|---|---|
| Qwen3.5 9B | Alibaba | 約 9.7B | 約 6.6GB | サイズの割に推論と多言語に強い。思考モード(thinking)に対応 |
| Gemma 4 12B | 約 11.9B | 約 7.6GB | 長いコンテキストに対応。思考モードに対応 |
モデル選びで考えたのは次の三点です。
- サイズ:GPU 1 枚(VRAM 24GB)に二つ同時に載せるため、量子化後で 1 つ 7GB 前後が上限。27B〜32B クラスは量子化しても 1 つで 16〜20GB になり、二つは載らない。3B〜4B クラスまで下げると、長い日本語の文章での指示追従が不安定になりやすいと考えた
- 日本語:入力も出力も日本語なので、多言語対応をうたうモデルに絞った
- ライセンスと入手経路:業務で使うため、利用条件が明確で、Ollama からそのまま取得できるモデルを選んだ
性能の目安としては、各社 API の軽量・廉価ライン(GPT-4o mini や Claude Haiku のクラス)に近い位置づけです。フラッグシップ級のモデルとは明確に差がありますが、「テキストを読んで決まった形式の結果を返す」定型タスクなら十分に実用になりました。公開されているベンチマークは量子化で目減りしうるので、最終的には自分たちのデータで試して判断しています。
GPU インスタンスの選び方
LLM 推論では、演算性能より先に「モデルが VRAM に載るか」が第一関門になります。今回はモデル二つで約 14GB、それにコンテキスト長 64K トークン分の KV キャッシュを加えると、二つ同時に載せた状態で約 18GB(実測)でした。東京リージョンの単発 GPU インスタンスを、オンデマンド単価とあわせて並べます(2026 年 8 月時点の実勢)。
| インスタンス | GPU | VRAM | 単価/h | 判定 |
|---|---|---|---|---|
| g4dn.xlarge | T4(2018 年世代) | 16GB | $0.710 | VRAM 不足 |
| g5g.xlarge | T4G / ARM | 16GB | $0.567 | VRAM 不足。加えて ECS の GPU 最適化 AMI に arm64 版が無く、カスタム AMI の保守が単価差に見合わない |
| g6.xlarge | L4(2023 年世代) | 24GB | $1.167 | 採用。量子化モデル二つと KV キャッシュが収まる |
| g5.xlarge | A10G(2021 年世代) | 24GB | $1.459 | 同じ VRAM で L4 より 25% 高い。演算性能は上だが逐次バッチでは差が出ない |
| g6e.xlarge | L40S | 48GB | $2.699 | 9B〜12B の量子化モデルには過剰 |
選定ロジックはシンプルで、「必要な VRAM を満たす最安」です。少量の逐次バッチでは演算性能の差はほぼ効きません。
ARM 系の g5g は単価が魅力的でしたが、GPU 最適化 AMI が無い点で見送りました。月の稼働が十数時間なら差額は 2 千円弱で、カスタム AMI を維持し続けるコストには見合いません。件数が桁で増えたら再評価する、と決めています。
推論サーバーの選び方: Ollama か vLLM か SGLang か
LLM のモデル本体は「重み」と呼ばれる数値が詰まった巨大なファイルにすぎません。これを GPU に載せて HTTP API として待ち受け、リクエストに応じてテキストを生成して返すソフトウェアが推論サーバーです。いわば「自前で立てるミニ OpenAI API」で、アプリからは外部 API を呼ぶのと同じ感覚で HTTP を叩きます。同じモデルでも、どの推論サーバーで動かすかで速度・同時に捌ける数・VRAM 効率が変わるため、ここも選定ポイントになります。
セルフホストの選択肢は実質この三つで、それぞれ設計思想が違います。
| Ollama(採用) | vLLM | SGLang | |
|---|---|---|---|
| 思想 | 個人〜小規模で「とにかく簡単に動かす」 | 大量の同時リクエストでスループットを最大化。本番推論サーバーのデファクト | vLLM 系の性能に加え、構造化出力とプレフィックス共有が強み |
| 看板技術 | GGUF 量子化(4bit 等で VRAM を半減以下に)、モデル管理内蔵、シングルバイナリ | PagedAttention(KV キャッシュを OS のページングのように管理)、continuous batching(複数リクエストをトークン単位で相乗り) | RadixAttention(共通プレフィックスの KV キャッシュを自動共有)、圧縮 FSM による高速な JSON スキーマ強制 |
| 得意なワークロード | 逐次・少量・省 VRAM | 多数の同時リクエスト(チャットサービス等) | 同じプロンプト前置を大量に流す、構造化出力を多用する |
| 運用の重さ | 軽い(イメージが小さく設定もほぼ不要) | 重め(CUDA イメージが大きく、パラメータ調整が前提) | 同左 |
今回 Ollama にした理由は三つです。
- 並列度が 1:バッチは 1 件ずつ逐次処理する。vLLM や SGLang の高スループット機構は同時リクエストが多いほど効くもので、恩恵がほぼない
- VRAM の都合:9B と 12B を FP16 で載せると約 40GB で、24GB に載らない。GGUF 量子化なら合計約 14GB に収まるので、GGUF ネイティブの Ollama が素直
- 運用のシンプルさ:週に数回、数十分だけ起動する使い捨てタスクに、チューニング前提のサーバーは過剰
ただし出口は用意してあります。アプリからの呼び出しは HTTP で抽象化してあり、推論サーバーは差し替え可能です。「1 件 3 分超、または月数千件規模」になったら vLLM / SGLang を再評価する、というラインを決めています。正直に補足すると、今回のワークロード(同じ指示文を前置して逐次実行する)は SGLang の RadixAttention が効く形ではあります。ただ後述のとおり 1 件 75 秒で足りている以上、複雑さに見合いませんでした。
「外に出ない」をネットワーク構成で担保する
ここがインフラの仕事どころです。「VPC 内で完結」を言葉ではなく、ネットワーク層で保証します。
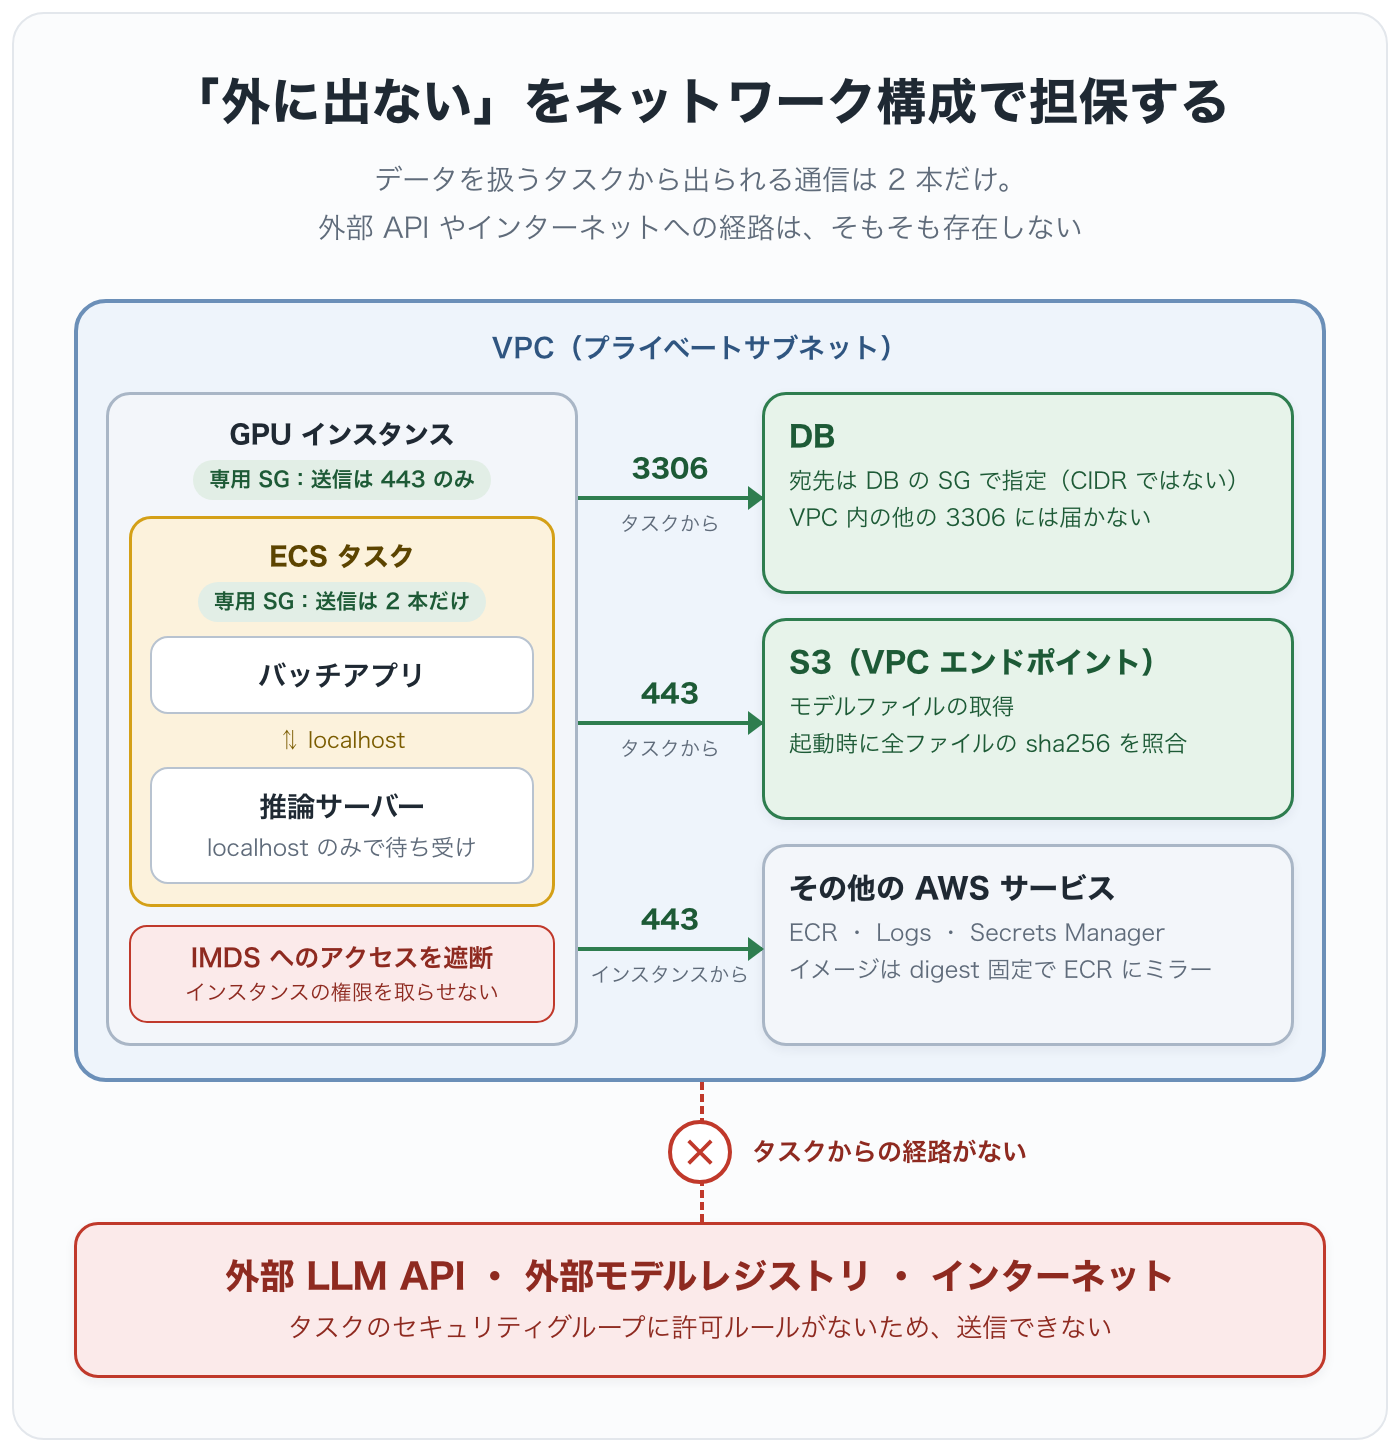
タスク用のセキュリティグループは専用に作り、egress は「S3 への 443」と「DB のセキュリティグループを参照した 3306」の 2 本だけにしました。既存のセキュリティグループを使い回すと、別の用途のために許可した通信まで引き継いでしまうためです。
GPU インスタンス(EC2 ホスト)側も同じ考え方で専用のセキュリティグループにし、egress は 443 のみにしています。
DB への egress は、CIDR ではなくセキュリティグループ参照で指定しました。CIDR で書くと、将来 VPC 内に追加された別の 3306 にも届いてしまうためです。
このほか、多層防御としていくつか小さな作り込みをしています。
- モデル配布は S3 経由のみ。外部レジストリからの取得(
ollama pull)は準備段階の開発機に限定 - コンテナイメージは公式イメージをダイジェスト固定で ECR にミラーし、タスク定義からも
@sha256で参照。実行環境から Docker Hub 等へは出ない - コンテナから IMDS(インスタンスメタデータ)へのアクセスを遮断。コンテナがインスタンスロールの資格情報を取ってタスクロールの最小権限を迂回する経路を塞ぐ
- モデルディレクトリは読み取り専用でマウント。サードパーティのイメージが検証済みモデルを上書きできない
- 推論サーバーのログは Slack へ転送しない。サードパーティのログ書式は統制できず、エラー行に入力テキストの断片が混ざりうるため
- DB 上のテキストはアプリレベルで暗号化し、復号鍵はバッチにだけ注入
3. 実測と使用感
数字で見る
ステージング環境で数十件規模のデータを、平日 1 回のバッチで安定して処理しています。主な実測値は次のとおりです。
| 項目 | 実測 |
|---|---|
| 1 件あたりの処理時間 | 約 75 秒(LLM 呼び出し 17〜29 秒 × 3 回) |
| 1 回の実行の固定オーバーヘッド | 約 25 分(起動 + イメージ取得 + モデル同期 約 10 分、スケールインの尾 約 15 分) |
| 20 件の実行 | 約 30 分 |
コストは g6.xlarge の単価 $1.167/h をおよそ 3 円/分として概算します。課金はインスタンスが存在する時間だけです。
| 費目 | 計算 | 月額 |
|---|---|---|
| 固定費: 起動オーバーヘッド | 25 分/回 × 20 営業日 × 3 円/分 | 約 1,500 円 |
| 従量費: 処理(月 100 件の場合) | 100 件 × 1 分/件 × 3 円/分 | 約 300 円 |
| ECR・S3・ログ等 | イメージとモデル約 20GB の保管など | 数百円 |
| 合計(月 100 件) | 約 1,800 円 |
月 1,000 件でも従量費が約 3,000 円になるだけで、合計約 4,500 円です。件数が 10 倍でもコストは 2.5 倍にしかならず、支配的なのは件数ではなく起動回数です。逆に言えば、処理頻度を上げる(1 日 2 回にする等)ほうがコストに効きます。
最悪ケースの上限も構造で決まっています。スケールインに失敗して 1 台が回りっぱなしになっても、ASG の最大が 1 台なので月約 13 万円が天井です。
モデルの使用感
実際に動かして分かった、この規模のローカルモデルを使うときのポイントです。
思考モードは切る。 二つのモデルはどちらも思考モードに対応しています。そのまま使うと、出力トークンを思考の部分で使い切り、肝心の JSON が出てこないことがありました。Ollama の API で think: false を指定して無効にしています。それでも思考のタグが本文に混ざることがあるので、受け取った側で取り除く処理も入れました。
JSON はスキーマで縛る。 Ollama の format に JSON Schema を渡すと、スキーマに沿った出力しか生成されないように制約をかけられます。これで構造化出力はほとんど壊れなくなりました。念のため、JSON の後ろに「以上です。」のような余計な文が付いた場合に備え、波括弧の対応を数えて JSON 部分だけを切り出しています。
コンテキスト長は必ず明示する。 Ollama のコンテキスト長の既定値は 4,096 トークンです。これを超える入力は、エラーにならずにプロンプトの先頭が黙って切り捨てられます。指示文を先頭に置いていると、指示が消えた状態でそれらしい出力が返ってくるので気づきにくい罠です。今回は num_ctx を 64K に設定しました。KV キャッシュはこの設定値の分だけ確保されるので、VRAM の見積もりにも効きます。
出力の長さはモデルによって違う。 同じ指示でも、Qwen3.5 は Gemma 4 より出力が長くなる傾向がありました。出力トークンの上限を 2,400 にしていたところ、長い入力では Qwen3.5 だけが途中で打ち切られていました。必要だったのは約 2,900 トークンです。上限の固定値を調整し続けるのをやめ、上限は外してコンテキスト長の側で歯止めをかける形にしました。
temperature は 0 にしない。 再現性を重視して temperature を 0 にすると、Gemma 4 が同じ文を繰り返すループに入りやすくなりました。0.2 に上げ、シードを固定して再現性を確保しています。
速度は十分。 L4 1 枚で、1 回の呼び出しが 17〜29 秒でした。逐次のバッチ処理なら不満のない速さです。
ハマったこと: GPU に載っているのにメモリ不足で落ちる
症状。 数件処理すると推論サーバーのプロセスが OOM で強制終了され、以降のリクエストが失敗しました。VRAM には余裕がありました。
原因。 コンテナ単位のメモリ使用量を時系列で見ると、モデルのロード完了後もリクエストごとに増え続け、コンテナの上限 10GiB に達して強制終了、再起動して再び増える、を繰り返していました。
増えていたのは、推論サーバー内部で動く llama.cpp のプロンプトキャッシュです。処理したプロンプトの状態を、既定でプロセスあたり最大 8GiB までホスト RAM に保持します。今回のモデルではこのキャッシュが再利用されず、メモリを占有するだけでした。
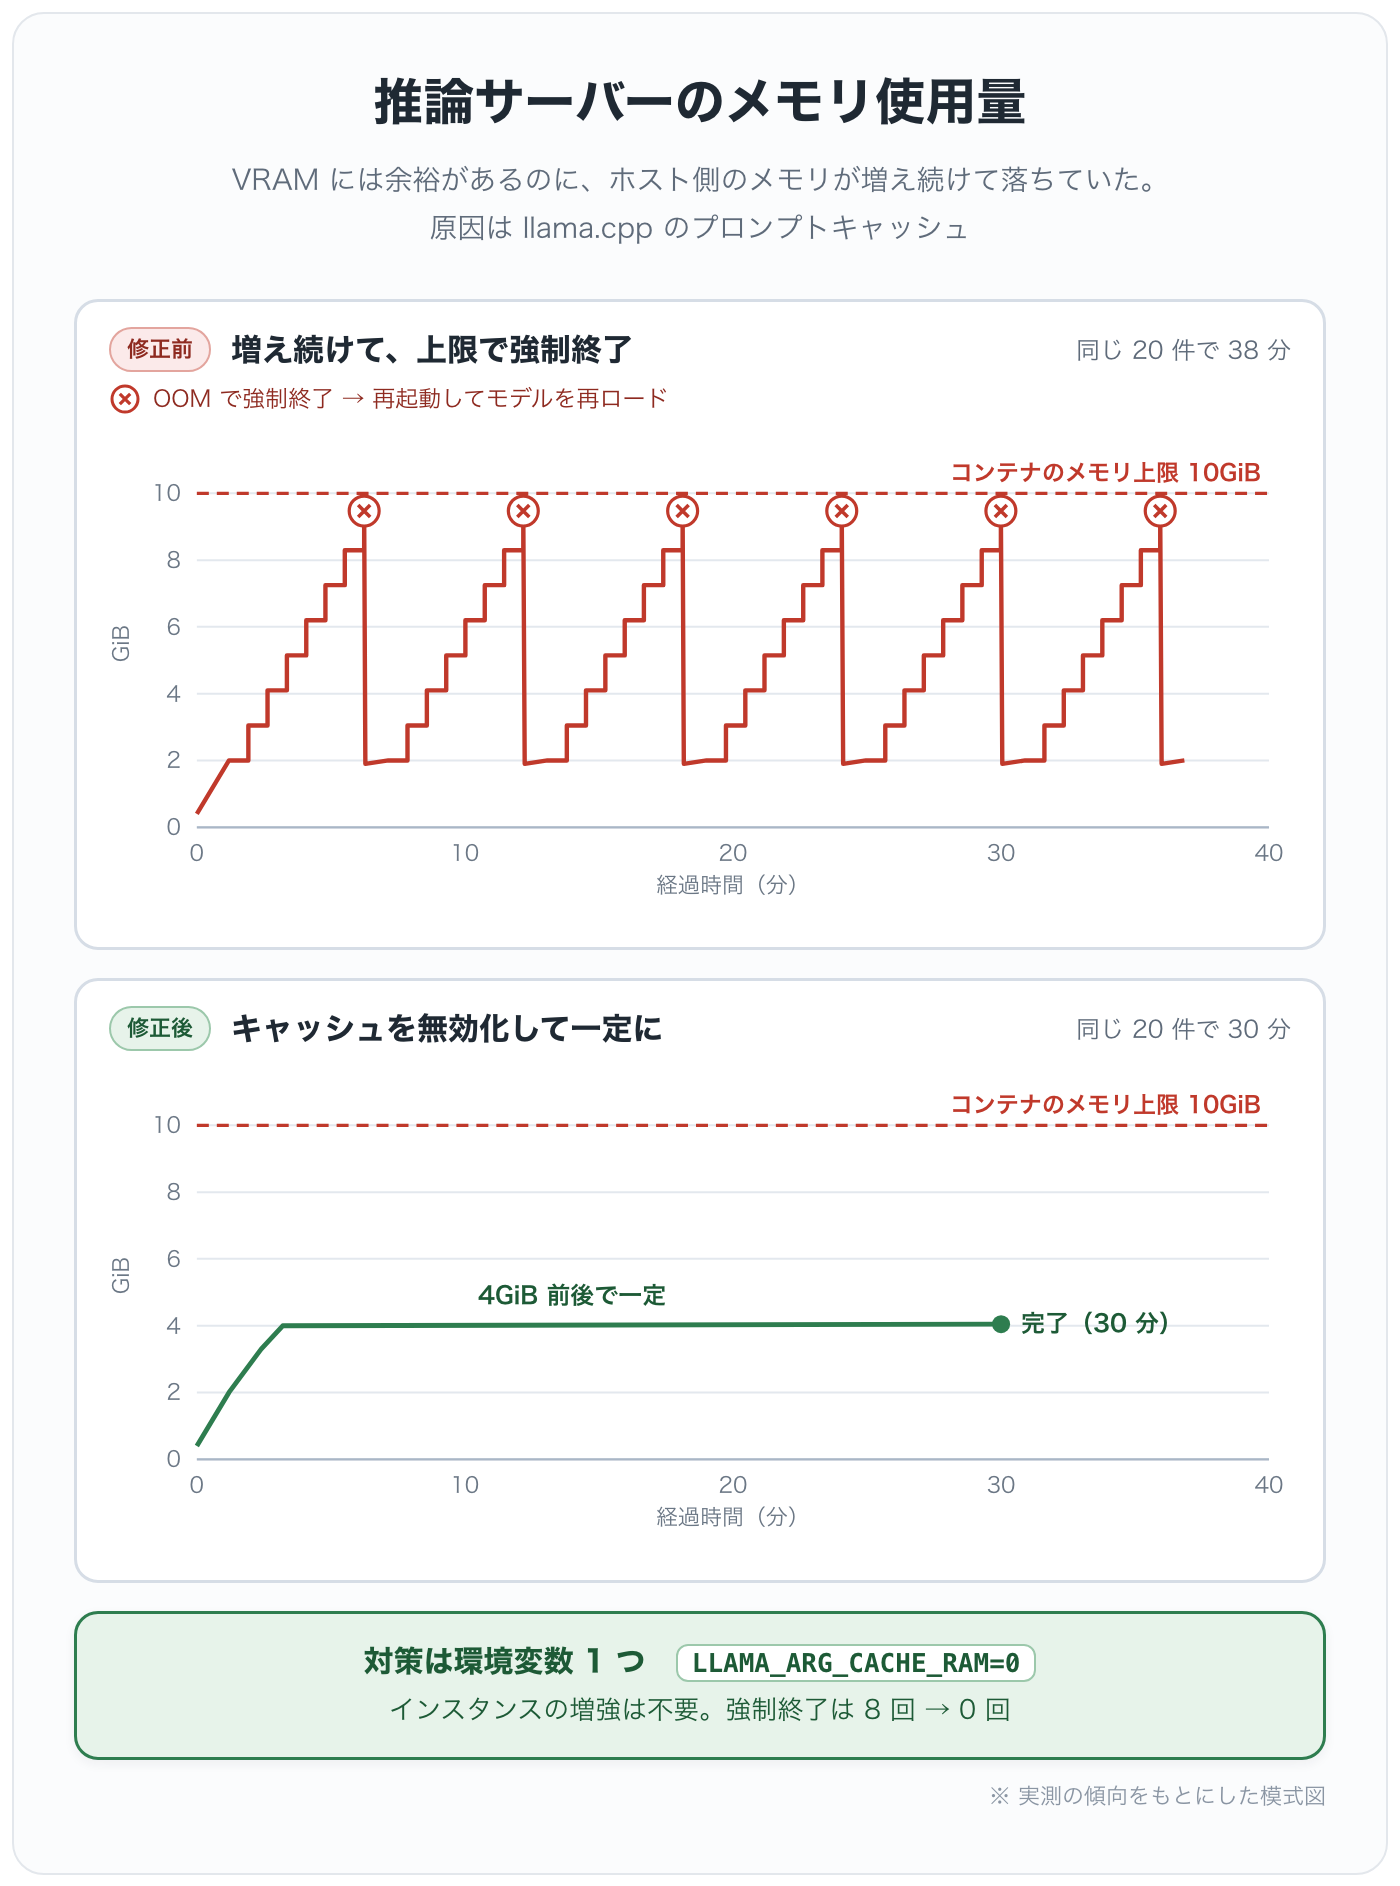
対策。 環境変数 LLAMA_ARG_CACHE_RAM=0 でキャッシュを無効化しました。Ollama はこのオプションを公開していませんが、子プロセスの llama.cpp に環境変数を引き継ぐため、LLAMA_ARG_* 形式の環境変数で設定できます。
| 修正前 | 修正後 | |
|---|---|---|
| プロセスの強制終了 | 8 回 | 0 回 |
| コンテナのメモリ | 2〜9GiB を往復 | 4GiB で一定 |
| 所要時間(同じ 20 件) | 38 分 | 30 分 |
インスタンスの増強は不要でした。ただし環境変数の引き継ぎは Ollama の公開仕様ではないため、バージョン更新時に効いているかを確認する必要があります。
教訓。
- VRAM とホスト側のメモリは別に見積もる。「GPU に載るか」だけでは足りない
- メモリ不足を疑ったら、まずコンテナ単位の時系列を取る。瞬間値では「足りない」と「増え続けている」を区別できない
良かった点
- 説明がシンプルになる:「外部の AI サービスには一切送信しない」と条件なしで言える。例外条件や契約の話に踏み込まずに済む
- コスト構造が読みやすい:支配的なのは起動回数で、件数はほとんど効かない。上限も ASG の最大台数で構造的に決まるので、「気づいたら請求が跳ねていた」が起きない
- 運用が楽:冪等に作ったので、失敗しても中断しても次回が続きから拾う。手動の再実行はほぼ不要で、将来の Spot 化とも相性が良い
課題
- モデルの品質に天井がある:9B〜12B クラスは各社 API の軽量ライン相当で、フラッグシップとは明確に差がある。定型タスクなら十分だが、複雑な多段推論には厳しい。処理がこのクラスで足りるかの見極めが前提
- 固定オーバーヘッドがある:1 回あたり約 25 分はバッチ型の宿命。リアルタイムに近い応答が必要な用途には向かない
- 推論サーバーの内部挙動に依存している:環境変数の引き継ぎは公開仕様ではない。GPU 最適化 AMI(自動追従)と Ollama(バージョン固定)の組み合わせで、NVIDIA ドライバとの非互換が起きる可能性もある。イメージ更新のたびに手動実行で確認する
- 本番展開はこれから:件数が桁で増えたら vLLM / SGLang を再検討し、安定稼働後には Spot 化する
まとめ
作ったもの。 外部の LLM API に送れない個人情報を含むテキストを、自社 VPC 内でセルフホストした LLM で処理するバッチ基盤を AWS 上に構築しました。EventBridge Scheduler・Step Functions・ECS RunTask の組み合わせで、GPU インスタンスは処理中しか存在しません。
選んだもの。
- LLM の実行場所:Bedrock ではなくセルフホスト。マスキングが使えないデータを「条件なしで送らない」と言い切るため
- 実行基盤:AWS Batch ではなく Step Functions + ECS。既存インフラの規約に乗るため
- モデル:Qwen3.5 9B と Gemma 4 12B の量子化版。GPU 1 枚に二つ載り、日本語を扱えるため
- インスタンス:g6.xlarge。必要な VRAM を満たす最安のため
- 推論サーバー:Ollama。逐次少量のバッチでは高スループット機構の恩恵がなく、量子化前提なら素直なため
どれも「今回のワークロードなら」という条件付きの判断で、条件が変わったときの再検討ラインもあわせて決めました。
学んだこと。
- 「外に出ない」は構成で担保する:アプリの善意ではなく、ネットワーク構成で外部 API へ送れない状態を作る
- VRAM とホストのメモリは別に見積もる:推論サーバーの既定値は、ホスト RAM の使い方まで疑ってかかる
最後に
次世代システム研究室では、グループ全体のインテグレーションを支援してくれるアーキテクトを募集しています。アプリケーション開発者の方、次世代システム研究室にご興味を持って頂ける方がいらっしゃいましたら、ぜひ募集職種一覧からご応募をお願いします。 皆さんのご応募をお待ちしています。

グループ研究開発本部の最新情報をTwitterで配信中です。ぜひフォローください。
Follow @GMO_RD