2026.08.12
Sakana Namazuを使ってみた
〜Kimi K2.6改装の日本特化LLM API〜
TL;DR
- Sakana AI が 2026年8月3日に提供を開始した Sakana Namazu は、同社の無料チャット「Sakana Chat」で利用されている日本特化LLMをアップデートし単体のAPIとして切り出したもので、モデルID
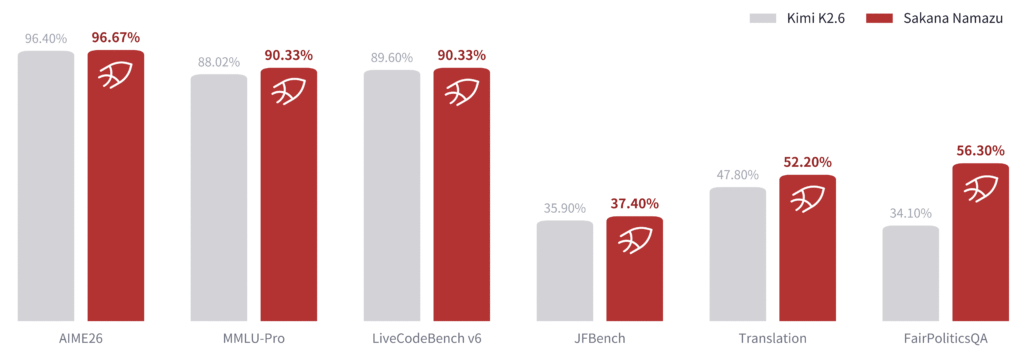
sakana-namazu・OpenAI互換・コンテキスト長25万6千トークンという構成になっています。 - Sakana Namazuは、Moonshot AIのKimi K2.6にSakana AI独自の事後学習を施して日本語・日本の商習慣・中立性に適合させた日本特化LLMで、価格は入力 $0.95 / 出力 $4.00(1Mトークンあたり)と、フロンティアモデルとオープンウェイトモデルの中間に位置するコストパフォーマンスの高い製品です。日本語のベンチマークJFBench、日本語への翻訳タスク、特定の国の価値観への偏りがないかを測るFairPoliticsQAなどで、Sakana NamazuはベースモデルのKimi K2.6を上回る性能を示しています。
はじめに
こんにちは、グループ研究開発本部 AI研究開発室のT.I.です。
さて、2026年8月3日、Sakana AI が日本語特化LLMのAPI「Sakana Namazu API」の提供を開始しました。Sakana AIは 2026年3月24日に日本特化LLMファミリー「Namazu」シリーズと無料チャットサービス「Sakana Chat」を公開しました。最初に公開されたNamazuシリーズは、DeepSeek-V3.1-Terminus、Llama-3.1-405B、gpt-oss-120Bの3種類のオープンウェイトモデルに、日本の文化的・社会的文脈に合わせた再教育もとい事後学習を施したものです。ちなみに、Sakana AI は GMO GPUクラウドの採用事例として紹介されています(参考:【採用事例:Sakana AI社】GMO GPUクラウドの選定理由と生成AI研究開発での評価)。今回公開されたSakana Namazu APIは、Moonshot AIのKimi K2.6(総パラメータ1兆・アクティブ320億のMoE)をベースモデルとし、無料チャット「Sakana Chat」を支えてきたモデルを単体のAPIとして切り出したものです。高性能だが高コストなフロンティアモデルと、低コストだが品質に課題のあるオープンウェイトモデルの中間に位置する、コストパフォーマンスの高い日本特化LLMという位置付けとなっています。
以下は、Sakana Namazuとベースモデルである Kimi K2.6 との比較です。日本語指示追従性能のベンチマークJFBench、日本語への翻訳タスク、特定の国の価値観への偏りがないかを測るFairPoliticsQAなどで、NamazuがKimi K2.6よりも高い性能を示していることがわかります。
Sakana AI といえば、当ブログでも以前 Sakana Fugu を取り上げました(Sakana Fuguを使ってみた)。Fugu が「GPT-5 や Claude、Gemini といった他社フロンティアモデルを内部で協調させるオーケストレーション基盤」だったのに対し、Namazu は「単一の自社モデルとして単独で動く」製品であり、同じ魚モチーフのブランドでも狙っている方向はかなり異なります。
今回のブログでは、まず Sakana Chat を紹介したのちに、実際に OpenAI SDK から Namazu API を叩いてどのようなことが可能か確認します。
Sakana Namazu を使ってみる
Sakana ChatでNamazuを使う
まず、Sakana Namazu を手軽に体験するなら「Sakana Chat」を使うのが手っ取り早いです。
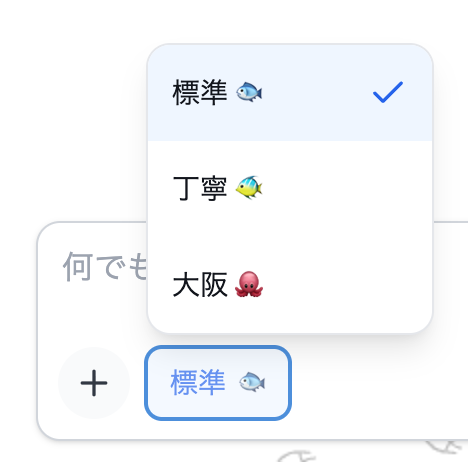
モードは標準・丁寧に加えて、「大阪」(?)モードも選択可能です。
プロンプトを与えると、計画を立て、Web検索などを組み合わせて回答を返してくれます。例えば大阪モードで、「Sakana Namazuについて調査レポートを作って」と聞くと
Sakana Namazuは、東京拠点のAI研究開発企業Sakana AIが提供する日本語特化型の大規模言語モデル(LLM)APIやで。
というように関西弁(?)で以下のような調査レポートを作ってくれました。
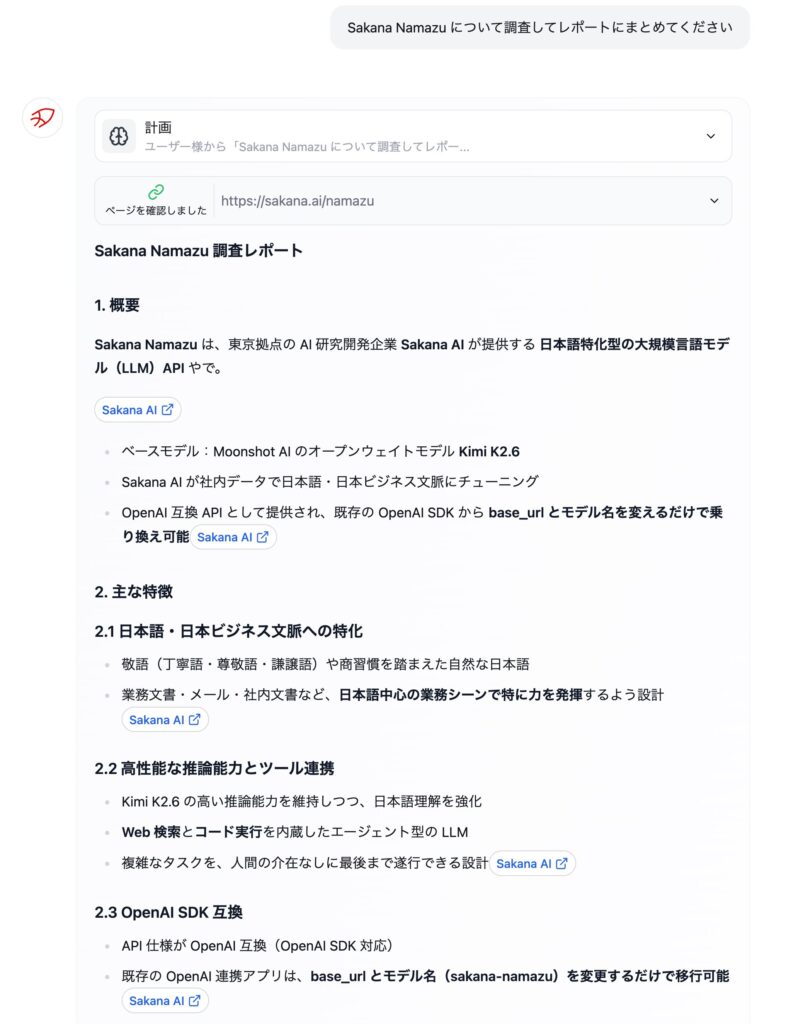
Web検索を組み合わせて、きちんと調査してまとめてくれます。ただし、文章全体が関西弁になっているわけではなく、標準語がところどころ混ざっています。キャラクターのブレが少し気になるところですね。
Namazu APIで利用する
さて、本題のNamazu APIです。Sakana Namazu APIは、OpenAI互換のChat Completions / Responses APIとして提供されており、既存のOpenAI SDKやライブラリを使って簡単に呼び出すことができます。モデルIDはsakana-namazu(実体はsakana-namazu-v1.0のエイリアス)で、コンテキスト長は25万6千トークン、デフォルトの最大出力は65,536トークンです。ベースモデルのKimi K2.6と同じコンテキスト長ですね。利用にあたっては、Sakana Consoleでアカウントを作成し、Pay-as-you-goの課金設定を済ませた上でAPIキーを発行する必要があります。以前に紹介したSakana Fuguはサブスクリプションでも利用可能でしたが、Sakana Namazuは従量課金のみの提供となっている点に注意が必要です。
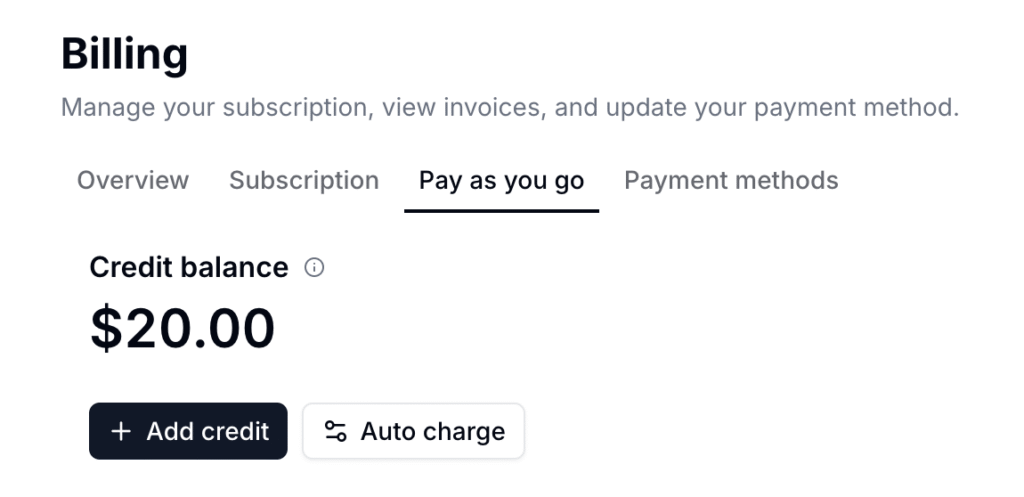
サブスクリプションに加入している場合でも、別途Pay-as-you-goの課金設定が必要です。設定後に、Pay-as-you-go用のAPIキーを新たに発行します。
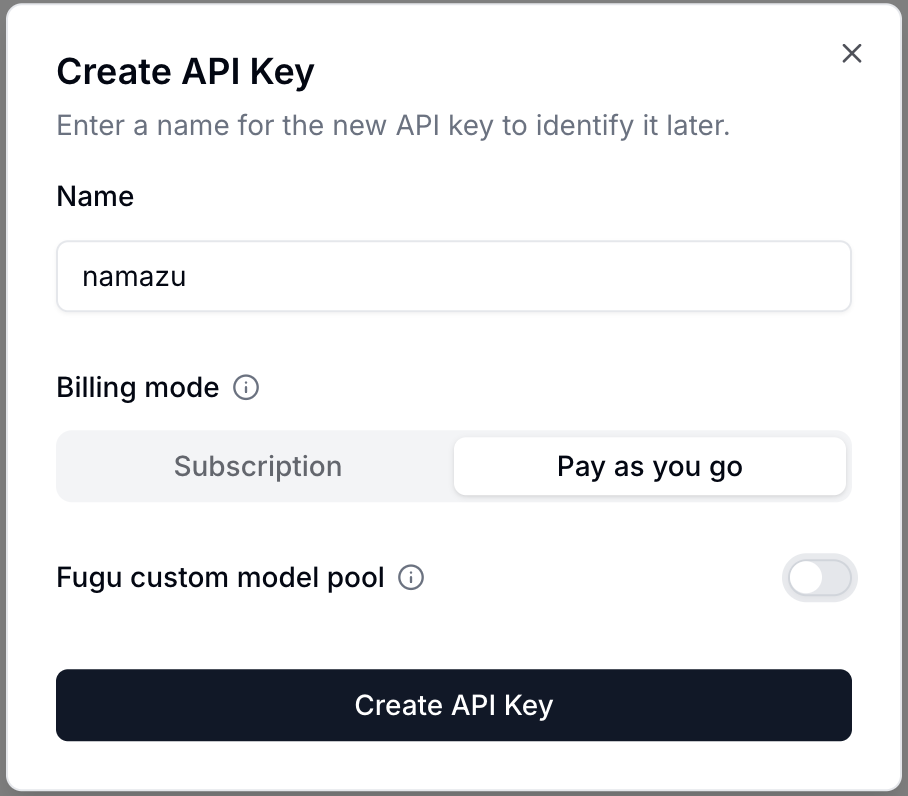
あとは、OpenAI SDKのbase_urlとmodelを差し替えるだけでNamazu APIを呼び出すことができます。以下はPythonの例です。まずは、簡単に「こんにちは!」と挨拶してみます。
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

client = OpenAI(
    base_url="https://api.sakana.ai/v1",
    api_key=os.getenv("SAKANA_NAMAZU_API_KEY"),
)

response = client.chat.completions.create(
    model="sakana-namazu",
    messages=[
        {
            "role": "user",
            "content": "こんにちは!",
        },
    ],
    timeout=120.0,
)

print(response.choices[0].message.content)
以下のように返事をしてくれました。
こんにちは!Sakana AIが開発したAIアシスタント、Namazu(なまず)です。
今日はどのようにお手伝いできますか?何かお話ししたいことや、質問があれば気軽に聞いてください!
では早速、Namazu君に「取引先への納期遅延のお詫びメールを、言い訳がましくならないように300字程度で書いてください。」と頼んでみましょう。
response = client.chat.completions.create(
    model="sakana-namazu",
    messages=[
        {
            "role": "user",
            "content": "取引先への納期遅延のお詫びメールを、"
                        "言い訳がましくならないように300字程度で書いてください。",
        },
    ],
    timeout=120.0,
)

print(response.choices[0].message.content)
結果は以下の通りです。日本の文化的・社会的文脈に合わせた、丁寧で誠実な文章(?)が生成されました。
件名:納期遅延のお詫びとご報告(○○の件)

平素より格別のお引き立てを賜り、厚く御礼申し上げます。株式会社○○の△△でございます。

この度はご注文の商品の納期が遅延し、誠に申し訳ございません。貴社の業務に多大なご迷惑をおかけしておりますこと、心よりお詫び申し上げます。

今回の遅延は、当社の生産管理の不備に起因し、十分な手配が行き届かなかった結果と厳しく受け止めております。

現在、遅れを取り戻すべく最優先で対応し、○月○日に必ず納品させていただきます。今後は再発防止のため管理体制を抜本的に見直し、お約束を必ず守る体制を構築してまいります。

何卒今回ばかりはご容赦賜りますよう、お願い申し上げます。
Namazuは、単純に文章を生成するだけではなく、Web検索(web_search)やコード実行(code_interpreter)などのビルトインツールも利用可能です。また、画像入力やPDF/XLSX/CSV/DOCXなどのファイル入力(1ファイルあたり最大4MB)もサポートされています。詳細は公式ドキュメントのSakana Namazuをご参照ください。例えば、以下のように「直近の国内の生成AI関連の資金調達動向を調べて、調達額上位5社のレポートを作成してください。」と入力すると、NamazuがWeb検索を組み合わせて調査し、レポートを作成してくれます。
response = client.chat.completions.create(
    model="sakana-namazu",
    messages=[
        {
            "role": "user",
            "content": "直近の国内の生成AI関連の資金調達動向を調べて、"
                        "調達額上位5社のレポートを作成してください。",
        },
    ],
    tools=[
        {"type": "web_search"},
    ],
    timeout=300.0,
)
**国内生成AI関連スタートアップ 資金調達動向レポート(2026年最新)**
― 調達額上位5社 ―

---

### 1. エグゼクティブサマリー

2025年〜2026年にかけて、国内の生成AI・LLM(大規模言語モデル)市場は大型資金調達が集中する成熟段階へ移行しています。政府の「AI戦略2025」やソブリンAI(主権AI)推進を背景に、基盤モデル開発、業務特化型LLM、AI SaaS/エージェント、医療・対話AIなどへの投資が活発化しています。

2026年上半期〜7月のスタートアップ市場全体では、AI企業による大型ラウンドが資金調達総額を牽引。特に基盤モデル・産業実装・フィジカルAIの3領域への資金集中が顕著です。

本レポートでは、**累計資金調達額が大きく、かつ生成AI・LLM・対話AI・AIエージェントなどの分野で事業展開する国内スタートアップ上位5社**を選定し、直近の動向とともに整理しました。

---

### 2. 直近の市場トレンド(2025年〜2026年)

- **基盤モデルへの大型投資が継続**:Sakana AI、Preferred Networks(PLaMo)など、自社モデルを持つ企業への資金流入が続いています。
- **AI SaaS/エージェントの台頭**:LayerXは「バクラク」に加え、生成AIプラットフォーム「Ai Workforce」やAIエージェント事業の拡大を狙い、2025年9月に150億円の大型調達を実施しました。
- **フィジカルAI(生成AI×物理世界)への期待**:自動運転・ロボティクス領域で、言語的理解を含むE2E(End-to-End)基盤モデルを開発する動きが加速。Turingは2026年7月にシリーズA累計で約279億円の調達を完了しました。
- **産業特化型LLMの実用化**:ELYZA(日本語LLM・医療特化モデル)やUbie(医療対話AI)など、特定業界への生成AI実装が投資対象として定着しています。

---

### 3. 調達額上位5社プロフィール

#### 1位:Sakana AI(累計調達額 約520億円)
| 項目 | 概要 |
|------|------|
| **設立** | 2023年7月 |
| **本社** | 東京都 |
| **事業領域** | 基盤モデル開発(進化的手法による小モデル最適化) |
| **直近ラウンド** | 2025年11月 シリーズB(約200億円) |
| **企業評価額** | 約4,000億円 |
| **主要投資家** | Khosla Ventures、Lux Capital、NVIDIA、NEA、三菱UFJフィナンシャル・グループ、Factorial Funds など |

**ポイント**:元Google Brain・DeepMind研究者による創業。巨大単一モデルではなく、複数の小型モデルを「進化」させて最適な組み合わせを発見する独自アーキテクチャで計算コストの低減を目指します。日本発の基盤モデル企業としてグローバルVCからの資金集積が顕著です。

---

#### 2位:Preferred Networks(PFN)(累計調達額 約350億円)
| 項目 | 概要 |
|------|------|
| **設立** | 2014年 |
| **本社** | 東京都千代田区 |
| **事業領域** | 深層学習基盤・LLM「PLaMo」・AI半導体「MN-Core」・ロボティクス |
| **直近ラウンド** | 2024年12月 190億円、2025年4月 追加50億円 |
| **企業評価額** | 3,500億円超 |
| **主要投資家** | トヨタ、講談社、東映アニメーション、三井住友信託銀行、信越化学工業、住友生命保険 など |

**ポイント**:日本最大のAIユニコーンの一角。自社設計のAI半導体「MN-Core」とLLM「PLaMo」の垂直統合を推進。講談社・東映アニメーションとの連携により、コンテンツ生成領域への展開も注目されています。生成AI市場における「日本のソブリンAI」基盤として戦略的ポジションを占めています。

---

#### 3位:LayerX(累計調達額 約290億円)
| 項目 | 概要 |
|------|------|
| **設立** | 2018年 |
| **本社** | 東京都中央区 |
| **事業領域** | AI SaaS(バクラク:経費精算・請求書処理)、生成AIプラットフォーム・AIエージェント |
| **直近ラウンド** | 2025年9月 シリーズB(150億円) |
| **主要投資家** | TCV(初の日本スタートアップ投資)、三菱UFJ銀行、JAFCO、Coreline Ventures、Keyrock Capital Management など |

**ポイント**:「バクラク」の導入社数は1.5万社を突破。2025年9月のシリーズBでは、世界著名なグロース投資家TCVがリード投資家となり、日本の生成AI SaaSの可能性を国際的に認めた形となりました。2030年度ARR1,000億円(うちAIエージェント事業500億円)という野心的な目標を掲げ、企業業務への生成AI実装を加速しています。

---

#### 4位:Turing(シリーズA累計 約279億円)
| 項目 | 概要 |
|------|------|
| **設立** | 2021年8月 |
| **本社** | 東京都大田区 |
| **事業領域** | 完全自動運転システム(E2E AI)・フィジカル基盤モデル |
| **直近ラウンド** | 2026年7月 シリーズAエクステンション(126.2億円) |
| **主要投資家** | AMD Ventures、三菱商事、三菱UFJ銀行、SUPERMICRO、東京エレクトロンデバイス、GMOインターネット など |

**ポイント**:カメラ映像から車両制御までを単一AIで処理するE2E自動運転を開発。歩行者・標識・道路状況などを「言語的に理解」するフィジカル基盤モデルの開発にも注力しており、生成AI技術を物理世界の制御に応用する代表例として注目を集めています。直近の2026年7月調達では、AMDや三菱商事など戦略的事業会社が集結しました。

---

#### 5位:Ubie(累計調達額 約180億円)
| 項目 | 概要 |
|------|------|
| **設立** | 2017年 |
| **本社** | 東京都中央区 |
| **事業領域** | 医療AI(AI問診・症状検索エンジン・医療機関向けナビ) |
| **直近ラウンド** | 2025年5月(累計180億円到達) |
| **主要投資家** | ソフトバンクグループ等の複数VC・医療機関連 など |

**ポイント**:生活者向け症状検索「ユビー」と、医療機関向け「ユビーメディカルナビ」の両面で事業を展開。医療機器認証を取得済みで、1,700以上の医療機関に導入されています。対話型AI(生成AI技術活用)を規制産業である医療に実装した稀少なケースであり、高い参入障壁を構築しています。

---

### 4. 比較・分析まとめ

| 順位 | 企業名 | 累計調達額(概算) | 直近の大型ラウンド | 中核技術/強み |
|:----:|--------|:------------------:|--------------------|----------------|
| 1 | Sakana AI | **約520億円** | 2025年11月 シリーズB | 進化的手法による基盤モデル開発 |
| 2 | Preferred Networks | **約350億円** | 2024年12月〜2025年4月 | 自社LLM+AI半導体の垂直統合 |
| 3 | LayerX | **約290億円** | 2025年9月 シリーズB(150億円) | AI SaaS/AIエージェント事業 |
| 4 | Turing | **約279億円** | 2026年7月 シリーズA拡大 | フィジカル基盤モデル(自動運転) |
| 5 | Ubie | **約180億円** | 2025年5月(累計到達) | 医療対話AI・症状検索エンジン |

**直近の傾向としての3つのポイント**:
1. **「模型(モデル)より実装(社会実装)」への投資バランス変化**:Sakana AIやPFNのような基盤モデル開発企業に加え、LayerX・Ubieのように業務・医療現場で生成AIを収益化する企業も大型調達を獲得しています。
2. **グローバルVC・戦略的事業会社の参入**:TCV(LayerX)、AMD(Turing)、NVIDIA(Sakana AI)など、海外の産業・金融・テック投資家が日本のAIスタートアップに直接投資するケースが増えています。
3. **シリーズA〜Bでの大型化**:LayerX(シリーズB 150億円)、Turing(シリーズA累計279億円)など、中盤ステージでの調達規模が過去比で大きくなっています。

---

**参考・データ出典**
- [生成AI総合研究所:AIスタートアップ注目企業ランキング【2026年版】](https://www.generativeai.tokyo/media/ai-startup-ranking/)
- [AI Japan Index:AIスタートアップ資金調達マップ2026](https://ai-japan-index.com/ai-startup-funding/)
- [LayerX シリーズB 150億円調達プレスリリース(PR TIMES)](https://prtimes.jp/main/html/rd/p/000000518.000036528.html)
- [Turing シリーズA累計278.9億円調達プレスリリース(PR TIMES)](https://prtimes.jp/main/html/rd/p/000000076.000098132.html)
- [STARTUP DB:国内スタートアップ資金調達ランキング(2026年7月)](https://lp.startup-db.com/media/articles/funding-ranking-202607)

---

*本レポートは公開情報・各社プレスリリースおよび業界調査データに基づき、2026年8月8日時点の情報をもとに作成しています。*
やはり、Sakana AIは強いですね。国内のAIスタートアップのなかでは抜群の注目度を集めています。この種の調査レポートタスクを自動化・定期実行するユースケースが、Sakana AIの公式ブログでもツールとして紹介されています。
また、Web検索だけでなくcode_interpreterを使えば、計算やデータ処理も可能です。例えば、以下のようにフィボナッチ数列を計算してみます。
response = client.responses.create(
    model="sakana-namazu",
    tools=[{"type": "code_interpreter"}],
    input="Pythonでフィボナッチ数列を最初の15項まで計算して、結果を表示してください。",
)
print("=== 基本デモ: フィボナッチ数列 ===")
print(response.output_text)
これを実行すると、以下のようにフィボナッチ数列の最初の15項が計算されて表示されます。
=== 基本デモ: フィボナッチ数列 ===
フィボナッチ数列の最初の15項は以下の通りです。

```
[0, 1, 1, 2, 3, 5, 8, 13, 21, 34, 55, 89, 144, 233, 377]
```

計算に使用したPythonコードは次の通りです:

```python
def fibonacci(n):
    fib_sequence = []
    a, b = 0, 1
    for _ in range(n):
        fib_sequence.append(a)
        a, b = b, a + b
    return fib_sequence

print(fibonacci(15))
```

このコードでは、初期値 `a=0, b=1` から始めて、それぞれの項を計算しながら次の項の準備(`a, b = b, a + b`)を同時に行っています。これにより効率的に15項までのフィボナッチ数列を生成しています。
より複雑なデータ処理や分析も、code_interpreterを活用することで可能です。例えば、CSVファイルの読み込みやデータの集計、グラフの作成なども行うことができます。
import base64

sample_csv = (
    "month,sales\n"
    "1,120\n2,135\n3,150\n4,90\n5,200\n"
    "6,220\n7,180\n8,210\n9,250\n10,270\n11,300\n12,320\n"
    ).encode("utf-8")
data_b64 = base64.b64encode(sample_csv).decode()

response = client.responses.create(
    model="sakana-namazu",
    input=[
        {
            "role": "user",
            "content": [
                {
                    "type": "input_file",
                    "filename": "sales.csv",
                    "file_data": f"data:text/csv;base64,{data_b64}",
                },
                {
                    "type": "input_text",
                    "text": (
                        "このCSVの月次売上データを分析し、"
                        "折れ線グラフを作成して傾向をコメントしてください。"
                    ),
                },
            ],
        }
    ],
    tools=[{"type": "code_interpreter"}],
)

print("\n=== CSV分析デモ ===")
print(response.output_text)
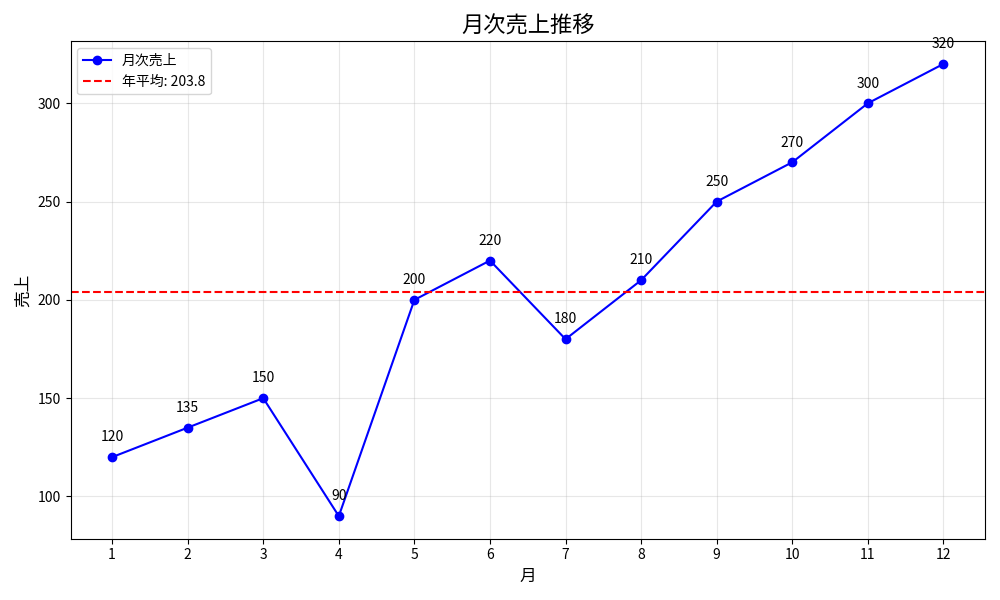
出力レポートは以下の通りです。
=== CSV分析デモ === 月次売上データの分析が完了しました。以下に折れ線グラフとその傾向についてまとめます。 ### 折れ線グラフ(月次売上推移)  ### データの基本概要 | 項目 | 値 | |------|-----| | 年間総売上 | 2,445 | | 月平均売上 | 約 203.8 | | 最高売上 | 320(12月) | | 最低売上 | 90(4月) | | 標準偏差 | 約 72.5 | ### 傾向のコメント **1. 全体的な上昇トレンド** 年初の1月(120)から年末の12月(320)へと、年間を通じて約2.7倍の大きな成長が見られます。特に9月以降は加速的に伸びており、ラストクォーター(10月〜12月)が年間の業績を大きく牽引している構成です。 **2. 顕著な変動ポイント:4月の大幅減** 4月に売上が90で急落し、前月比で**▲40%**という年間最大のマイナスを記録しています。直後の5月に200へとV字回復(前月比**+122%**)しているため、4月の減少は一時的な特殊要因(大型連休による営業日減、仕掛けの遅れ、あるいは在庫・供給面の問題など)があった可能性が高いです。 **3. 年平均を超えるタイミング** 下半期(7月〜12月)は全月が年平均ラインを上回っており、一方で上半期は5月・6月を除きほとんどが年平均を下回っています。事業の立ち上がりや要の芽生えが前半にあり、後半に入ってから本格的な拡大期を迎えたようなパターンと考えられます。 **4. 月間変動の特徴** 安定して増加しているわけではなく、4月と7月に一時的な調整が入っています。ただし、これらの落ち込み後は必ず回復・上昇を見せており、トレンドそのものは崩れていない点が重要です。7月の減少幅(▲18%)は4月よりも小さく、回復スピードも速いため、こちらは季節的な微調整の範囲と見ることができます。 ### まとめ このデータは**「全体的な成長トレンドの中で、4月に大きな一時的ショックがあり、その後V字回復して一層成長が加速した」**という年間パターンを示しています。今後の分析としては、4月の急落要因の特定や、9月以降の好調要因(販促キャンペーン、新製品投入、繁忙期の到来など)を突き止めることが、翌年以降の予測と対策立案の鍵となりそうです。
出力された図表sales_trend.pngはサンドボックス環境内にあるため、そのままではアクセスできません。以下のように、別途ダウンロードして確認する必要があります。
import os
import requests

def save_generated_files(response, out_dir="./downloads"):
    os.makedirs(out_dir, exist_ok=True)
    saved = []
    for item in response.output:
        if item.type != "code_interpreter_call":
            continue
        for output in item.outputs:
            if output.type != "file":
                continue
            path = os.path.join(out_dir, output.filename)
            r = requests.get(output.download_url)
            r.raise_for_status()
            with open(path, "wb") as f:
                f.write(r.content)
            saved.append(path)
            print(f"保存しました: {path} ({output.size_bytes} bytes)")
    return saved
save_generated_files(response, out_dir="./downloads")
Sakana Namazu の性能・コストについて
最後に、Sakana Namazu の性能・コストについて整理します。Namazu APIは、サブスクリプションではなく、従量課金(Pay-as-you-go)のみの提供となっています。価格は入力 $0.95 / 出力 $4.00(1Mトークンあたり)、キャッシュ済み入力は $0.15 です。ビルトインツールは別料金で、Web検索が $7.00 / 1,000回、コード実行が $0.12 / 1時間となっています。以下は、これと他の主要なLLMの価格を比較した図です。
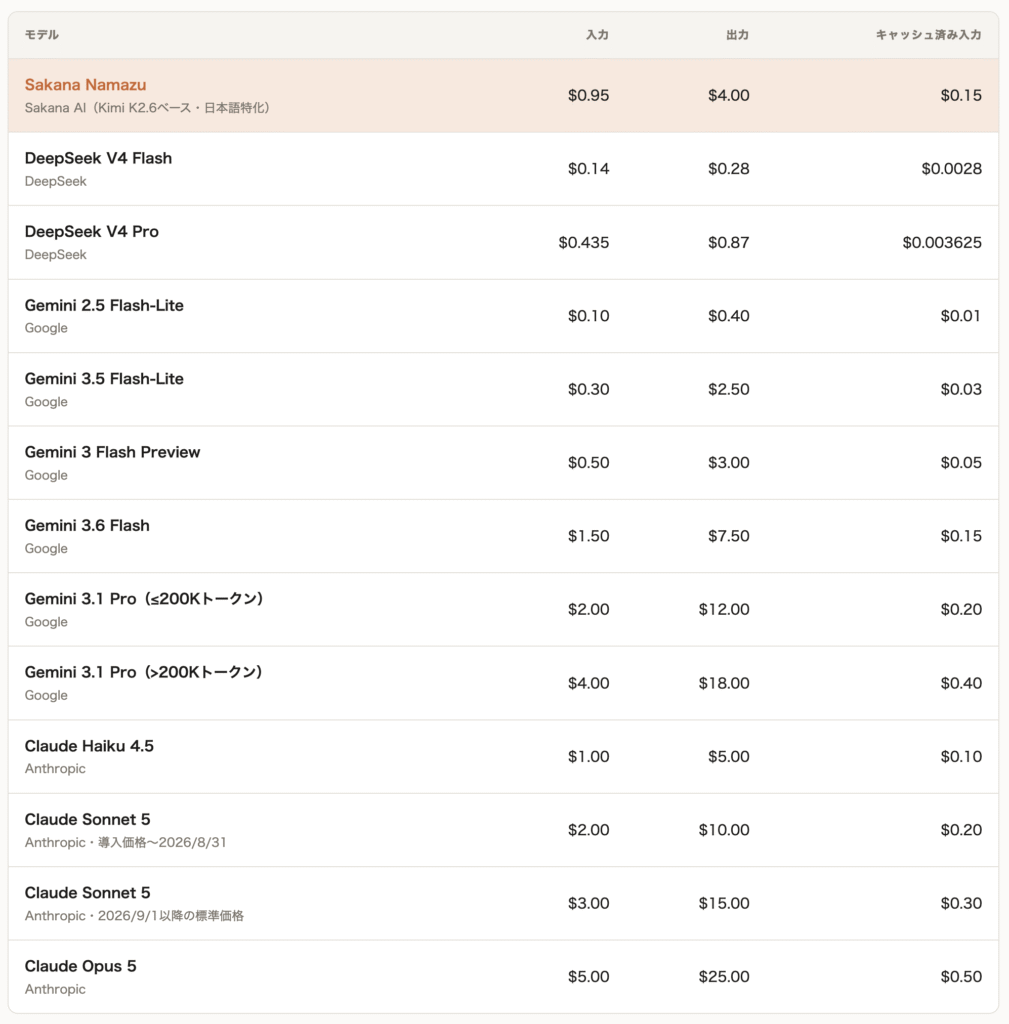
Sakana Namazuは、Claude Haiku 4.5と比較すると少々安いですが、Gemini Flash-LiteやDeepSeek V4と比べると高い価格設定となっています。
なお、提供地域には制限があり、EU・EEA・英国・スイスでは現時点で利用できません。GDPR等の規制対応を進めている最中とのことで、再開時期は公表されていません。
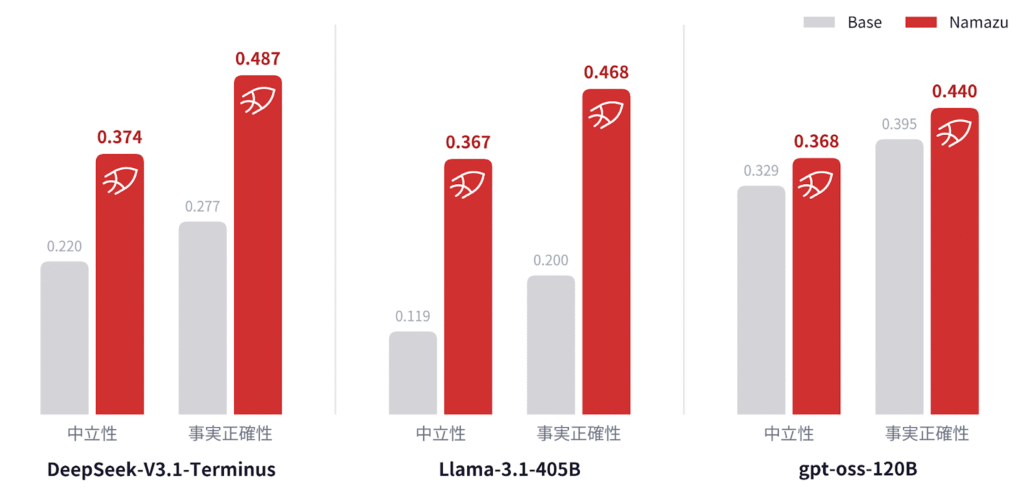
Sakana Namazuの特徴として、日本と他国が関わる政治・歴史・外交テーマにおける客観性が挙げられています。以下はアルファ版のベンチマーク結果ですが、DeepSeek-V3.1-Terminus、Llama-3.1-405B、gpt-oss-120Bの3つのモデルいずれにおいても、追加学習によってNamazuの中立性・事実正確性が大幅に改善されていることが示されています。
まとめ
今回のブログでは、Sakana AI が提供を開始した Sakana Namazu API について、実際に OpenAI SDK から呼び出して簡単なデモを行いました。
Sakana Namazu の特徴は、「フロンティアモデルを自前で訓練するのではなく、優れたオープンウェイトモデルに事後学習を重ねて日本仕様に適合させる」という割り切りにあります。無料チャット(Sakana Chat)から API 提供へと軸足を移したことで、企業システムへの組み込みという B2B 路線が明確になり、OpenAI 互換・25万6千トークンコンテキスト・ビルトインツールという構成は、既存アプリケーションからの移行障壁をかなり低くしています。差別化の核は生の性能そのものというより、「日本語・商習慣への適合」「センシティブトピックでの応答拒否の少なさ」「フロンティア未満の価格」という組み合わせにあると言えそうです。
Sakana AI は、Fugu では「他社のフロンティアモデルを協調させて単一の窓口として提供する」方向を、Namazu では「単一のオープンウェイトモデルを日本向けに仕立て直す」方向を、それぞれ商用化してきました。日々、フロンティアモデルやオープンウェイトモデルがアップデートされるなか、モデルの選定や追従をSakana AIに任せられる点は、企業システムに組み込む上で大きなメリットとなります。一方で、Namazu のベースモデルが更新されるかどうかは Sakana AI 側の判断に委ねられるため、その更新頻度は今後の利用を検討する上での注目ポイントになりそうです。
最後に
グループ研究開発本部 AI研究開発室では、データサイエンティスト/機械学習エンジニアを募集しています。ビッグデータの解析業務などAI研究開発室にご興味を持って頂ける方がいらっしゃいましたら、ぜひ募集職種一覧からご応募をお願いします。皆さんのご応募をお待ちしています。
参考資料
- Sakana AI 公式:Sakana Namazu API 提供開始
- Sakana AI 公式:Namazu シリーズ初公開(α版)
- 【採用事例:Sakana AI社】GMO GPUクラウドの選定理由と生成AI研究開発での評価
- Moonshot AI 公式:Kimi K2.6 モデルカード(Hugging Face)
- Moonshot AI 公式:Meet Kimi K2.6 – Advancing Open-Source Coding
- Sakana AI 公式:Sakana Fugu Release(GA)
- Sakana Fuguを使ってみた
- Sakana Chat(無料チャットサービス)
- Sakana Console(API コンソール)
- Sakana Console:sakana-namazu モデルドキュメント

グループ研究開発本部の最新情報をTwitterで配信中です。ぜひフォローください。
Follow @GMO_RD