2026.08.24
ElastiCacheのCross-AZデータ転送費をZone-awareルーティングで削減する
結論
- ElastiCache (Valkey) のreader endpoint経由の読み取りがDNSラウンドロビンでAZを跨いでいて、Cross-AZデータ転送費が月額約$380発生していた
- アプリケーション側でAZを検出して同一AZのレプリカから読み取る方式に変更することで、Cross-AZデータ転送費を実測で約92%削減出来た
- 全ての失敗経路がreader endpoint(従来動作)にフォールバックする設計により、可用性を損なわずにコスト削減出来、レスポンスタイムも低〜中負荷時に15〜19%改善した
はじめに
こんにちは。次世代システム研究室のT.Tです。
現在開発運用に携わっているWebサービスは、AWS環境で稼働しています。オンプレ環境からAWS環境への移行後もランニングコスト削減に継続的に取り組んでいて、Cost Explorerでコストの発生状況を定期的に確認しています。その中で、AZ間のデータ転送費(Data Transfer Regional Bytes)が想定以上に発生していることが分かり、調査したところElastiCache (Valkey) への読み取りアクセスが原因であることが判明しました。
本記事では、Cross-AZデータ転送費が発生する仕組みと、アプリケーション側でAZを意識したルーティングを実装してコストを削減した事例についてご紹介します。
1.Cross-AZデータ転送費の問題
システム構成
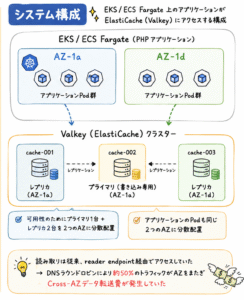
WebサービスはEKSとECS Fargate上でPHPアプリケーションが稼働していて、セッションやキャッシュの保存先としてElastiCache (Valkey) のクラスターを利用しています。クラスターは可用性のためにプライマリ1台とレプリカ2台の構成で、レプリカは2つのAZ(ap-northeast-1aと1d)に分散配置しています。アプリケーションのPodも同じ2つのAZに分散しています。
問題の原因
Cross-AZデータ転送費の問題はEKS側で発生していました。アプリケーションからの読み取りはElastiCacheのreader endpointを利用していました。reader endpointはDNSラウンドロビンで2つのレプリカに読み取りを分散するため、約50%の読み取りトラフィックがAZを跨ぐことになります。AWSではAZ間のデータ転送に$0.01/GB(双方向で$0.02/GB)が課金されるため、読み取りトラフィックが多いサービスではこの費用が無視出来ない金額になります。
実際にCloudWatchのNetworkBytesOutメトリクスで転送量を確認したところ、以下のようになっていました。
| メトリクス | 値 |
|---|---|
| レプリカ (AZ-1a) のNetworkBytesOut | 約1,270 GB/日 |
| レプリカ (AZ-1d) のNetworkBytesOut | 約1,260 GB/日 |
| 読み取りトラフィック合計 | 約2,530 GB/日 |
| Cross-AZ分(ラウンドロビンの約50%) | 約38 TB/月 |
| 実際の請求額 | 約$380/月 |
キャッシュへのアクセス自体は正常な動作なので障害ではありませんが、同一AZのレプリカから読み取れば発生しない費用が毎月発生し続けている状態でした。
2.解決策の比較検討
参考にした事例
調査を進める中で、How HotelTrader cut inter-AZ cost 95% and latency by 49% with Valkey GLIDE on Amazon ElastiCacheというAWS Database Blogの事例を見つけました。reader endpointのDNSラウンドロビンによるCross-AZ転送費という、同じ問題をValkey GLIDEクライアントのAZ_AFFINITY読み取り戦略で解決した事例です。
2つのアプローチの比較
この事例を踏まえて、2つのアプローチを比較検討しました。
| 比較項目 | 案A: 設定レベルのZone-awareルーティング | 案B: Valkey GLIDEへの移行 |
|---|---|---|
| 概要 | 既存のRedisクライアントを維持し、AZ検出と同一AZホスト名解決を設定レベルで追加 | RedisクライアントをValkey GLIDEに置き換え、組み込みのAZ_AFFINITYを利用 |
| 変更規模 | 新規2ファイル+本番用設定の修正 | Redisレイヤー全体の置き換え、Dockerイメージの再ビルド(GLIDEはC/Rust拡張) |
| リスク | 低(接続先ホスト名の変更のみで後方互換) | 高(コアコンポーネントの置き換えで全面的なリグレッションテストが必要) |
| 影響範囲 | 本番環境のみ | 全環境 |
| 期待効果 | Cross-AZ費用の約85〜95%削減 | Cross-AZ費用の約95%削減 |
効果はどちらもほぼ同等ですが、GLIDEのPHPクライアントがまだプレビュー段階で本番環境への導入はリスクが高いと判断したため、案Aを採用しました。案Aを先に導入し、将来GLIDEのPHPクライアントがGAになった時点で案Bに移行することが出来る点も判断材料になりました。
3.Zone-awareルーティングの実装
全体のフロー
実装は「自分がどのAZにいるかを検出する」「同一AZのレプリカのホスト名に解決する」「障害時はreader endpointにフォールバックする」の3つの要素で構成しています。全体のフローは以下のようになります。
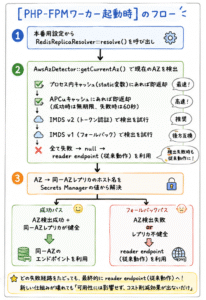
重要なのは、フロー内のどの失敗経路をたどっても最終的にreader endpoint、つまり変更前とまったく同じ動作に行き着く点です。新しい仕組みが壊れた場合の最悪ケースが「コスト削減効果が出ないだけ」になるように設計していて、可用性には影響しません。
AZの検出
Podが自分のAZを知るには、EC2のInstance Metadata Service (IMDS)に問い合わせます。検出結果は多層キャッシュに保存して、IMDSへの実アクセスがPodあたり実質1回になるようにしています。コードの概要は以下のようになります。
class AwsAzDetector
{
    private static $memoryCache = null;

    public static function getCurrentAz(): ?string
    {
        // 1. プロセス内キャッシュ
        if (self::$memoryCache !== null) {
            return self::$memoryCache ?: null;
        }

        // 2. APCuキャッシュ(同一Pod内の全ワーカーで共有)
        $cached = apcu_fetch(self::CACHE_KEY, $success);
        if ($success && $cached !== false) {
            if ($cached !== '') {
                // 成功値のみプロセス内キャッシュに昇格させる
                self::$memoryCache = $cached;
            }
            return $cached ?: null;
        }

        // 3. IMDS v2 → v1の順で検出
        $az = self::detectFromImdsV2() ?? self::detectFromImdsV1();

        if ($az !== null) {
            // 成功: 稼働中のPodのAZは変わらないため無期限にキャッシュ
            apcu_store(self::CACHE_KEY, $az, 0);
            self::$memoryCache = $az;
        } else {
            // 失敗: 60秒だけAPCuに記録して自動で再試行させる
            apcu_store(self::CACHE_KEY, '', 60);
        }

        return $az;
    }
    ...
}
キャッシュのTTLを成功と失敗で変えているのがポイントです。稼働中のPodのAZは絶対に変わらないため、成功時は無期限にキャッシュして再検出のコストを排除します。一方、IMDSの失敗は一時的な可能性が高いため、失敗は60秒だけ記録して、復旧後は自動的に同一AZルーティングに戻るようにしています。
ハマりどころ: 失敗キャッシュの扱い
この実装で1点ハマりどころがありました。当初、APCuから読み出した値を無条件にプロセス内キャッシュ(static変数)へ昇格させていたため、IMDS障害中に格納された失敗値までワーカープロセスに固定されてしまう不具合がありました。static変数には失効機構がないため、一度失敗値が入るとIMDSが復旧してもそのワーカーは二度と再検出せず、プロセスがリサイクルされるまでreader endpoint(Cross-AZ)に戻り続けます。
この不具合は障害にはならず「コスト削減効果が静かに消える」だけなので、機能テストでは検出しづらい性質のものでした。上記のコードのように、成功値のみをプロセス内キャッシュに昇格させることで解決しています。フォールバック設計のシステムでは、こうした「エラーが出ない劣化」の検証も必要という学びになりました。
接続失敗時のフェイルオーバー
同一AZのレプリカに直接接続する方式にすると、reader endpointのDNSが担っていた障害ノードの自動除外が働かなくなります。その代わりとして、Redisクライアントの接続クラスを拡張して、接続失敗時に同一リクエスト内でreader endpointへ切り替えるフェイルオーバーを実装しました。
class RedisFoConnection extends \yii\redis\Connection
{
    public $fallbackHostname = null;

    private function switchToFallback(\Exception $originalException): bool
    {
        if ($this->_usingFallback || empty($this->fallbackHostname)) {
            return false;
        }

        // 同一AZレプリカを60秒間unhealthyとして記録し、
        // 以降のリクエストは最初からreader endpointを使う
        RedisReplicaResolver::markUnhealthy($this->hostname);

        $this->close();
        $this->hostname = $this->fallbackHostname;
        $this->_usingFallback = true;

        try {
            $this->open();
            return true;
        } catch (\Exception $fallbackException) {
            ...
            throw $originalException;
        }
    }

    public function executeCommand($name, $params = [])
    {
        try {
            return $this->sendCommandInternal($command, $params);
        } catch (SocketException $e) {
            // 同一リクエスト内でフォールバック先に再実行(リクエストロスなし)
            if ($this->switchToFallback($e)) {
                return $this->sendCommandInternal($command, $params);
            }
            throw $e;
        }
    }
    ...
}
reader endpointのDNSから障害ノードが除外されるまでには数秒〜数十秒かかりますが、この方式では接続失敗を検知した瞬間に同一リクエスト内で切り替わるため、既存方式よりも速くフェイルオーバーします。60秒後には自動でTCPチェックを再試行して、レプリカが復旧していれば同一AZルーティングに戻ります。
4.検証と効果
検証環境での機能検証
本番適用の前に、検証環境で以下の3ケースを検証して、いずれも想定どおりの動作を確認しました。
- Cross-AZ転送費の削減: 負荷試験で79GBのRedisトラフィックを発生させ、Cost ExplorerでCross-AZ転送費が$0になることを確認
- 同一AZレプリカのノード障害: ノード再起動中はreader endpointへ自動フェイルオーバーし、復旧後は同一AZルーティングに自動復帰することを確認
- AZ検出の失敗: IMDSに到達出来ない状態では従来どおりreader endpointを利用し、エラーが発生しないことを確認
性能への影響
Gatlingを利用して、変更前後で同一シナリオの負荷テストを実施しました。結果は以下のようになりました。
| 負荷 | 変更前 平均 | 変更後 平均 | 変更前 P95 | 変更後 P95 | エラー率 |
|---|---|---|---|---|---|
| 10qps | 708ms | 576ms | 1598ms | 648ms | 0% |
| 30qps | 707ms | 604ms | 1380ms | 853ms | 0% |
| 50qps | 688ms | 664ms | 1404ms | 1084ms | 0% |
性能の劣化はなく、低〜中負荷時にはレスポンスタイムが15〜19%改善しました。これはRedisアクセス時のAZ跨ぎ通信のレイテンシが排除されたことによるもので、冒頭でご紹介したHotelTraderの事例で報告されているレイテンシ改善と同じメカニズムです。コスト削減が目的の変更で性能も改善するのは嬉しい副産物でした。
本番環境リリース後の効果
本番環境へのリリース後、Cost ExplorerでCross-AZデータ転送(Data Transfer Regional Bytes)の使用量とコストを確認しました。リリース前後それぞれ3日間の平均を比較すると以下のようになりました。
| 項目 | リリース前(3日間平均) | リリース後(3日間平均) | 削減率 |
|---|---|---|---|
| Cross-AZ転送量 | 約1,214 GB/日 | 約98 GB/日 | -92% |
| Cross-AZ転送費 | 約$12.1/日 | 約$1.0/日 | -92% |
| 月額換算 | 約$364/月 | 約$29/月 | 約$335/月の削減 |
使用量・コストともに約92%の削減となり、事前に見積もっていた85〜95%削減のレンジ内に収まりました。残っている転送分は、プライマリへの書き込みやプライマリからレプリカへのレプリケーション、ELB等のRedis以外のAZ跨ぎ通信によるもので、今回の方式の対象外のものです。
運用上の注意点
この方式では、レプリカのホスト名をSecrets Managerで静的に管理するため、reader endpointが持っていた「新しいレプリカを自動でラウンドロビンに組み込む」機能は失われます。レプリカを追加・置換する場合はSecrets Managerのキーの更新が必要になるため、クラスター構成変更時の運用手順に組み込んでおく必要があります。更新を忘れてもフォールバックにより障害にはなりませんが、削減効果が静かに消えるため、リリース後は定期的にCost ExplorerでCross-AZ転送費を確認するようにしています。
5.まとめ
今回は、ElastiCacheのCross-AZデータ転送費を、アプリケーション側のZone-awareルーティングで削減した事例についてご紹介しました。reader endpointのDNSラウンドロビンによるCross-AZ転送費は、読み取りトラフィックの多いサービスでは意外と大きな金額になるため、NetworkBytesOutメトリクスとCost ExplorerのData Transfer Regional Bytesを一度確認してみることをおすすめします。
また、今回のような「失敗しても従来動作に戻るだけ」のフォールバック設計は、リリースリスクを抑えられる一方で、劣化がエラーとして現れないため検証と監視に工夫が必要になります。Valkey GLIDEのPHPクライアントがGAになった際には、自前実装部分をライブラリに置き換える移行も検討したいと思います。
なお、2026年7月にAmazon ECS Service ConnectのZone-awareルーティングが提供開始されていて、サービス間通信については今回自前実装したのと同様の同一AZ優先ルーティングをマネージドで実現出来るようになっています。今回の対象はElastiCacheへの接続のためこの機能は適用出来ませんが、AZを意識したルーティングによるCross-AZ転送費の削減はAWS全体の流れになりそうなので、今後は自前実装せずにマネージド機能やクライアントライブラリで実現出来る範囲が広がっていくことも期待出来そうです。
次世代システム研究室では、アプリケーション開発や設計を行うアーキテクトを募集しています。アプリケーション開発者の方、次世代システム研究室にご興味を持って頂ける方がいらっしゃいましたら、ぜひ 募集職種一覧 からご応募をお願いします。
皆さんのご応募をお待ちしています。

グループ研究開発本部の最新情報をTwitterで配信中です。ぜひフォローください。
Follow @GMO_RD